Accent Remover: ลบวรรณยุกต์เพื่อข้อความ ASCII ที่สะอาด
ลบเครื่องหมายเน้นเสียงจากข้อความด้วย Unicode NFKD normalization เพื่อ export, username และ search index ที่สะอาด — ฟรีและทันทีในเบราว์เซอร์
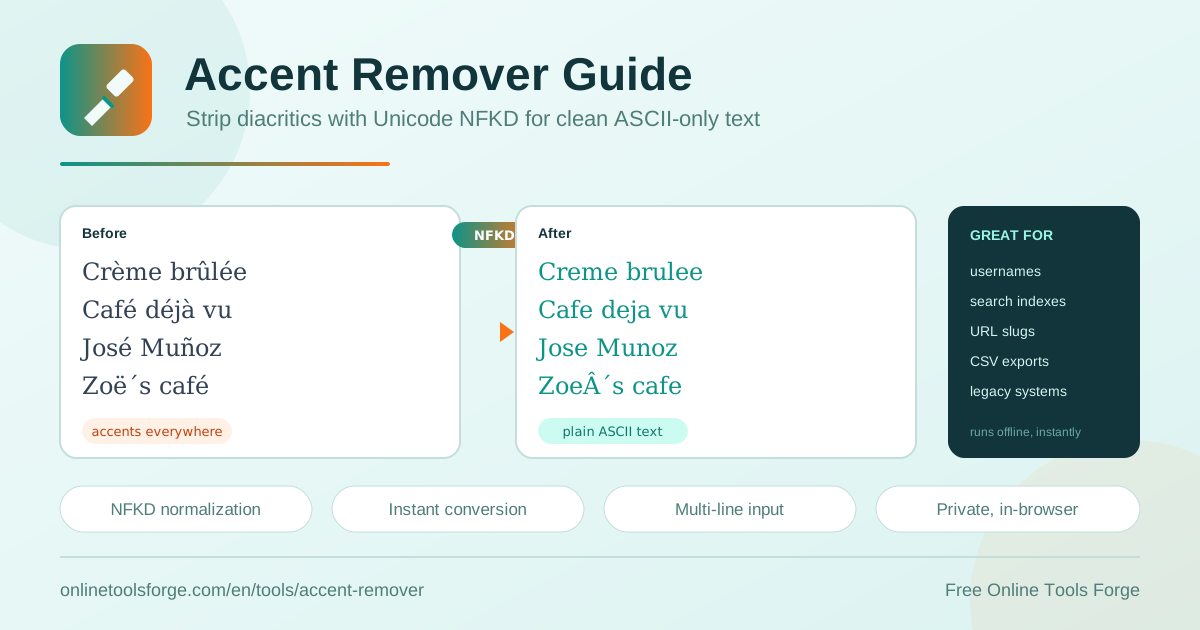
Table of Contents
ลองนึกภาพว่าคุณกำลังจะสร้าง username จากชื่อลูกค้า "José García" หรือเตรียมรายการเมนูอาหาร "Crème brûlée" สำหรับระบบภายใน แล้วจู่ ๆ ระบบดันเด้ง error กลับมา เพราะตัวอักษร é, á, û ที่ดูธรรมดาในสายตาเรา กลับเป็น "ตัวปัญหา" สำหรับระบบที่รองรับเฉพาะ ASCII ล้วน ปัญหานี้เจอกันบ่อยมากในงานที่ต้องจัดการข้อมูลข้ามภาษา ทั้งการ import CSV, สร้าง search index หรือทำ URL slug
ทางแก้ที่เร็วที่สุดคือ Accent Remover เครื่องมือฟรีที่ใช้เทคนิค Unicode NFKD normalization แยกเครื่องหมายเน้นเสียง (diacritics) ออกจากตัวอักษร แล้วลบทิ้งอย่างสะอาด ให้ผลลัพธ์เป็นข้อความ ASCII ที่ระบบไหนก็กินได้ ทำงานทันทีใน browser ไม่ต้องสมัครสมาชิก ไม่ต้องติดตั้งอะไรทั้งสิ้น
ข้อดีอีกอย่างคือทั้งหมดประมวลผลบนเครื่องคุณเอง ข้อความที่วางลงไปไม่ถูกส่งไป server ใด ๆ เหมาะกับข้อมูลลูกค้าหรือเอกสารภายในที่ห้ามรั่วไหล บทความนี้จะพาไปดูว่าเครื่องมือนี้ทำอะไรได้บ้าง หลักการทำงานเบื้องหลังเป็นอย่างไร และมีกรณีไหนที่ควรระวังการใช้งาน
ทำไมต้องใช้ Accent Remover?
- ป้องกัน username และ ID พัง — ระบบสมัครสมาชิกส่วนใหญ่ยอมรับเฉพาะ a-z, 0-9 การลบ accent ก่อนสร้างบัญชีช่วยให้ José กลายเป็น Jose ได้ทันทีโดยไม่ต้องเดาว่าจะแทนด้วย e หรือตัดทิ้ง
- สร้าง URL slug ที่ถูกต้อง — ลิงก์ที่มีตัวอักษรมีเครื่องหมายมักถูก encode ยาวเป็น %C3%A9 ทำให้อ่านไม่ออกและแชร์ลำบาก การ fold เป็น ASCII ก่อนช่วยให้ slug สั้นและอ่านง่าย
- ทำให้ search index แม่นยำขึ้น — ผู้ใช้พิมพ์ "cafe" แต่ข้อมูลเก็บเป็น "café" การค้นหาก็หาไม่เจอ การ normalize ทั้งสองฝั่งให้เหลือรูปเดียวช่วยแก้ปัญหานี้ตั้งแต่ต้นทาง
- เข้ากันได้กับระบบ legacy — ระบบเก่าอย่าง mainframe, ERP หรือฐานข้อมูล encoding แบบเดิมมักรับได้เฉพาะ ASCII เท็กซ์ที่สะอาดจึง import ผ่านโดยไม่ต้องแก้สคริปต์
- ประหยัดเวลาจากการลบมือ — เอกสารหลายพันบรรทัดถ้าไล่ลบเครื่องหมายทีละตัวใช้เวลานานมาก เครื่องมือนี้แปลงทั้งชุดเสร็จในไม่กี่วินาที
- เป็นส่วนตัว 100% — ทุกอย่างทำงานใน browser ของคุณ ไม่มีการอัปโหลดข้อมูลไปไหน จึงใช้กับข้อมูลที่มีความอ่อนไหวได้อย่างมั่นใจ
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| Unicode NFKD normalization | แยกตัวอักษรที่มีเครื่องหมายออกเป็นตัวอักษรฐาน + เครื่องหมายแยกชิ้น |
| ลบ combining diacritical marks | ตัดเครื่องหมายเน้นเสียงที่แยกออกมาทิ้ง เหลือเฉพาะตัวอักษรฐาน |
| รองรับหลายบรรทัดทั้งชุด | วางเอกสารยาวหรือรายการข้อมูลทั้งก้อน แปลงได้ครั้งเดียวจบ |
| แปลงทันที | เห็นผลลัพธ์ทันทีที่วางข้อความ ไม่ต้องกดปุ่มซ้ำ ๆ |
| ทำงานเป็นส่วนตัวในเบราว์เซอร์ | ข้อมูลไม่ออกจากเครื่อง ไม่ต้องสมัคร ไม่มีข้อจำกัดจำนวนครั้ง |
จุดเด่นของเครื่องมือคือความเรียบง่าย — วางข้อความที่มีตัวอักษรมีเครื่องหมาย แล้วรับข้อความ ASCII กลับไปใช้ได้เลย เช่น Crème brûlée กลายเป็น Creme brulee หรือ José กลายเป็น Jose ในเสี้ยววินาที
เนื่องจากใช้มาตรฐาน Unicode โดยตรง เครื่องมือจึงจัดการ accent ได้ครอบคลุมหลายภาษา ทั้งฝรั่งเศส สเปน เยอรมัน สแกนดิเนเวีย และเวียดนาม โดยโครงสร้างข้อความเดิม เช่น การเว้นบรรทัด ยังคงอยู่ครบถ้วน
วิธีลบเครื่องหมายเน้นเสียง
- เปิดหน้า Accent Remover ใน browser ได้เลย ไม่ต้องติดตั้งหรือสมัครอะไร
- วางข้อความที่มีตัวอักษรมีเครื่องหมายลงในช่อง input จะเป็นประโยคสั้น ๆ หรือเอกสารหลายบรรทัดทั้งชุดก็ได้
- ดูผลลัพธ์ในช่อง output ทันที — เครื่องหมายเน้นเสียงทั้งหมดถูกลบออกโดยอัตโนมัติ
- ตรวจทานผลลัพธ์อย่างรวดเร็ว โดยเฉพาะชื่อเฉพาะหรือคำที่ accent มีผลต่อความหมาย
- คัดลอกข้อความ ASCII ที่สะอาดแล้วไปใช้ในงานต่อได้ทันที ไม่ว่าจะ export, สร้าง username หรือเติมลงฐานข้อมูล
Unicode Normalization ลบ Accent อย่างไร
หัวใจของเครื่องมือนี้คือความเข้าใจว่าตัวอักษรเดียวกันใน Unicode มีได้สองรูปแบบ รูปแบบแรกคือ composed form ที่ตัวอักษรกับเครื่องหมายถูกรวมเป็น code point เดียว เช่น é คือ U+00E9 ส่วนรูปแบบที่สองคือ decomposed form ที่แยกเป็นสองชิ้น คือตัวอักษรฐาน e ตามด้วย combining acute accent U+0301 ทั้งสองแบบแสดงผลเหมือนกันสนิทตา แต่ในระดับ byte ต่างกันสิ้นเชิง
NFKD (Normalization Form KD — Compatibility Decomposition) คืออัลกอริทึมมาตรฐานของ Unicode ที่ "แกะ" ตัวอักษรทุกตัวให้ออกมาในรูป decomposed ที่สุด พอตัวอักษรถูกแยกชิ้นแล้ว เครื่องหมายเน้นเสียงทั้งหมดจะตกอยู่ในช่วง combining diacritical marks คือ U+0300 ถึง U+036F ซึ่งลบทิ้งได้อย่างแม่นยำด้วย pattern ระดับ Unicode category โดยไม่กระทบตัวอักษรฐาน
สิ่งที่เทคนิคนี้ทำคือ accent folding ไม่ใช่การแปลภาษา — มันไม่ได้เปลี่ยนความหมายของคำ แต่ "พับ" ตัวอักษรหลายรูปลงในรูปฐานเดียวกัน เช่น é, è, ê, ë ล้วน fold ลงเป็น e เพื่อให้ระบบจับคู่และเปรียบเทียบได้ง่าย ซึ่งต่างจากการแปลที่ต้องเข้าใจบริบทภาษา
ก่อน: Crème brûlée — José García
หลัง: Creme brulee — Jose Garcia
อย่างไรก็ตาม accent folding ไม่ใช่คำตอบสำรองสำหรับทุกภาษา ในภาษาสแกนดิเนเวีย å และ ø ถือเป็นตัวอักษรเฉพาะที่มีอยู่ในลำดับอักษรของตัวเอง การ fold เป็น a และ o ทำให้เสียความหมายของชื่อเฉพาะไป ภาษาเวียดนามใช้เครื่องหมายเพื่อแยกวรรณยุกต์ของคำ การลบทิ้งอาจทำให้คนอ่านสับสนได้ และภาษาตระกูลจีน-ญี่ปุ่น-เกาหลี (CJK) ไม่ใช่เรื่องของ accent เลย จึงอยู่นอกขอบเขตของเทคนิคนี้ ข้อจำกัดอีกจุดคือตัวอักษรพิเศษอย่าง ß ของเยอรมัน ซึ่ง NFKD ไม่แตกออกเป็น ss โดยอัตโนมัติ ดังนั้นถ้าข้อมูลของคุณมีความละเอียดอ่อนด้านภาษา ควรตรวจสอบผลลัพธ์ก่อนนำไปใช้จริง
กรณีใช้งานจริง
สร้าง username และ slug
นักพัฒนาเว็บมักต้องแปลงชื่อผู้ใช้หรือหัวข้อบทความเป็น identifier ที่ปลอดภัย เช่น จาก "Renée Müller" ให้ fold เป็น "Renee Muller" ก่อน แล้วจึงต่อยอดเป็น username อย่าง renee.muller หรือ slug อย่าง /blog/renee-muller-profile ขั้นตอน fold ตรงนี้คือการลบความไม่แน่นอนตั้งแต่ต้นทาง ทำให้ระบบสมัครสมาชิกหรือ CMS ไม่ต้องเจอตัวอักษรแปลก ๆ ที่อาจทำให้ validation ล้มเหลว และลิงก์ที่ได้ก็อ่านออกในทุก browser และแพลตฟอร์ม
ปรับ search index ให้ค้นเจอทั้งสองแบบ
ร้านอาหารที่มีเมนู "crème brûlée" หรือ "purée" มักเจอปัญหาลูกค้าพิมพ์ค้นหาแบบไม่มีเครื่องหมายแล้วหาไม่เจอ วิธีมาตรฐานคือเก็บข้อมูลต้นฉบับไว้สำหรับแสดงผล แต่สร้าง search index จากข้อความที่ fold แล้ว พอมีคนพิมพ์ "creme brulee" ระบบก็ normalize คำค้นเช่นกัน ทำให้ทั้ง crème และ creme เจอกันหมด เทคนิคนี้ใช้ได้ทั้งกับ search engine ภายในร้านค้า ระบบค้นเอกสาร และ autocomplete ในแอป
ทำความสะอาด CSV สำหรับระบบเก่า
ฝ่ายบัญชีหรือ HR ที่ต้อง import รายชื่อพนักงานเข้าระบบ ERP รุ่นเก่ามักเจอ error แปลก ๆ กลางไฟล์ เพราะชื่ออย่าง "Björn Ström" หรือ "Sofía" มี byte ที่ encoding เดิมไม่รู้จัก ก่อนส่งไฟล์จึงควรผ่านการ fold เป็น ASCII ทั้งไฟล์ก่อน โดยวางเนื้อหาทั้งชุดลงในเครื่องมือซึ่งรองรับหลายบรรทัดพร้อมกัน จากนั้นคัดลอกกลับลงไฟล์ CSV ระบบปลายทางก็จะรับข้อมูลได้ครบทุกแถวโดยไม่ต้องแก้มือทีละเซลล์
เตรียมที่อยู่อีเมลและข้อมูลติดต่อ
ที่อยู่อีเมลในทางทฤษฎีรองรับตัวอักษรหลากหลาย แต่ในความเป็นจริงระบบ newsletter, CRM และ gateway จำนวนมากยังติดขัดกับ local part ที่มีเครื่องหมาย เช่น René[email protected] การ fold เป็น [email protected] ก่อนบันทึกลงระบบช่วยให้การส่งอีเมลไม่ติดขัด และลดปัญหาข้อมูลซ้ำซ้อนจากการที่ระบบมองว่าเป็นคนละรายการกัน
แนวทางปฏิบัติที่ดี
- เก็บข้อมูลต้นฉบับไว้เสมอ — fold เป็นการลบข้อมูล จึงควรเก็บรูปดั้งเดิมไว้ในคอลัมน์หรือฟิลด์แยก แล้วใช้รูปที่ fold แล้วเฉพาะงานด้าน identifier และการค้นหา
- fold ก่อนแล้วจึง lowercase — ลำดับสำคัญ เพราะเครื่องหมายบนตัวพิมพ์ใหญ่บางตัวจัดการต่างจากตัวพิมพ์เล็ก การ normalize ตามลำดับ NFKD → ลบ accent → lowercase ให้ผลสม่ำเสมอที่สุด
- fold ตั้งแต่ขั้น ingest — ถ้าทำใน pipeline ข้อมูล ให้ normalize ตั้งแต่รับเข้าระบบ ดีกว่ามาตามแก้ทีหลังเมื่อข้อมูลสะสมมากขึ้น
- ตรวจสอบชื่อเฉพาะก่อนใช้จริง — ชื่อคนและสถานที่มักมีความหมายผูกกับเครื่องหมาย ควรกลั่นกรองเคสสำคัญเช่น å, ø, ß เป็นพิเศษ
- ทดสอบกับข้อมูลจริงของคุณ — ลองวางตัวอย่างข้อมูลที่แปลกที่สุดในชุดของคุณดูก่อน จะได้รู้ว่าผลลัพธ์ตรงความคาดหวังหรือไม่
- ผสานกับเครื่องมือทำความสะอาดอื่น — งานจริงมักต้องจัดการทั้ง accent, ช่องว่าง และรูปแบบ Unicode ในคราวเดียวกัน การทำงานร่วมกับเครื่องมืออื่นช่วยให้ pipeline ครบวงจร
พร้อมทำให้ข้อความสะอาดแล้วหรือยัง?
อย่าปล่อยให้ตัวอักษรมีเครื่องหมายขัดขวางงานของคุณอีกต่อไป เปิด Accent Remover วางข้อความ แล้วรับข้อความ ASCII ที่สะอาดกลับไปใช้ภายในไม่กี่วินาที — ฟรี ไม่มีข้อจำกัด และข้อมูลของคุณไม่เคยออกจาก browser
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Whitespace Remover — ลบช่องว่างและ whitespace ที่ไม่ต้องการออกจากข้อความเสริมให้ข้อมูลสะอาดสมบูรณ์ยิ่งขึ้น
- Unicode Normalizer — จัดรูปแบบ Unicode ของข้อความให้เป็นมาตรฐานเดียวกัน ครอบคลุมกว่าการลบ accent เพียงอย่างเดียว
- Slug Generator — แปลงหัวข้อหรือชื่อเรื่องเป็น URL slug ที่สะอาด อ่านง่าย พร้อมใช้กับเว็บไซต์ทันที
ขอให้ทำความสะอาดข้อความอย่างสนุก!
คำถามที่พบบ่อย
ถ: เครื่องมือนี้เปลี่ยนความหมายของข้อความหรือไม่?
ตอบ: ไม่เปลี่ยนความหมาย แต่จะลบเครื่องหมายเน้นเสียงออก ทำให้ é กลายเป็น e เป็นต้น ข้อความยังอ่านได้เข้าใจเหมือนเดิม อย่างไรก็ดีในบางภาษาเครื่องหมายมีผลต่อการออกเสียงอย่างมาก จึงควรตรวจทานชื่อเฉพาะก่อนใช้ในเอกสารทางการ
ถ: ทำงานกับข้อความยาวหลายบรรทัดได้ไหม?
ตอบ: ได้ เครื่องมือรองรับเอกสารหลายบรรทัดทั้งชุด วางข้อความยาวหรือรายการข้อมูลจำนวนมากลงไปก็แปลงให้ครบทั้งหมดในครั้งเดียว โดยโครงสร้างบรรทัดยังคงเดิม
ถ: ข้อมูลของฉันถูกส่งไปเซิร์ฟเวอร์หรือไม่?
ตอบ: ไม่ การประมวลผลทั้งหมดเกิดขึ้นใน browser ของคุณด้วย JavaScript ล้วน ๆ ข้อความไม่ถูกอัปโหลดหรือบันทึกไว้ที่ใด จึงใช้กับข้อมูลที่มีความอ่อนไหวได้อย่างปลอดภัย
ถ: NFKD ต่างจาก NFC อย่างไร?
ตอบ: NFC รวมตัวอักษรกับเครื่องหมายให้เป็นรูป composed รูปเดียว ส่วน NFKD ทำตรงข้ามคือแยกออกเป็นรูป decomposed เต็มที่ ซึ่งจำเป็นสำหรับการลบ accent เพราะต่อให้แยกเครื่องหมายออกมาเป็นชิ้น ๆ ก่อน ถึงจะลบทิ้งได้อย่างแม่นยำ
ถ: มีภาษาไหนที่ไม่ควรใช้ accent folding บ้าง?
ตอบ: ควรระวังกับภาษาที่ตัวอักษรมีเครื่องหมายถือเป็นอักษรเฉพาะ เช่น å และ ø ในภาษาสแกนดิเนเวีย หรือภาษาเวียดนามที่วรรณยุกต์แยกความหมายของคำ สำหรับภาษากลุ่ม CJK ก็ไม่เกี่ยวกับ accent อยู่แล้ว กรณีเหล่านี้ควรพิจารณาเป็นรายคำแทนการ fold ทั้งชุด