AI Crawler Checker: เช็กให้ชัดว่า AI Bots ตัวไหนอ่านเว็บคุณได้
ใช้ AI Crawler Checker ตรวจ robots.txt และ meta tags ของคุณว่าเปิดทางให้ GPTBot, ClaudeBot, CCBot หรือ PerplexityBot หรือไม่ พร้อม snippet สำหรับ block AI crawler แบบก๊อปวางได้ทันที
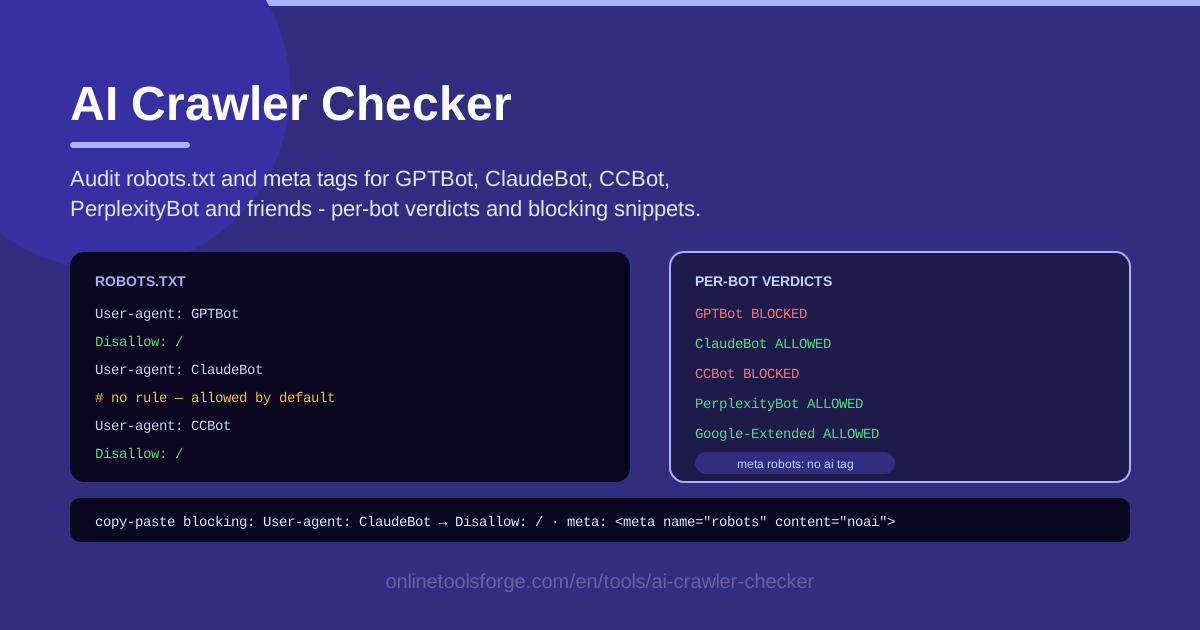
Table of Contents
ทุกเดือนมี AI crawler หน้าใหม่เข้ามาไต่เว็บกันไม่หยุด GPTBot จาก OpenAI, ClaudeBot จาก Anthropic, CCBot จาก Common Crawl, PerplexityBot จาก Perplexity และ Google-Extended จาก Google ต่างกวาดคอนเทนต์จากเว็บนับล้านแห่งไปเลี้ยง search index และโมเดลภาษา แต่เจ้าของเว็บส่วนใหญ่กลับไม่รู้ตัว เพราะ robots.txt ทำงานบนค่าเริ่มต้นที่เงียบที่สุด: ถ้าคุณไม่เคยเขียนกฎสำหรับบอทตัวใดเลย แปลว่ามันไต่ทุกหน้าที่คุณเผยแพร่ได้ วิธีเร็วที่สุดเพื่อรู้สถานะจริงของคุณคือเอาไฟล์ไปตรวจกับ AI Crawler Checker
แค่วาง robots.txt และ meta tags ที่เกี่ยวข้องลงในเครื่องมือ มันจะตรวจกฎการเข้าถึงของ AI crawler ทีละตัว แล้วสรุป verdict ให้ครบทุกตัวว่า blocked หรือ allowed by default ไม่ว่าจะเป็น GPTBot, ClaudeBot, CCBot, PerplexityBot หรือ Google-Extended เมื่อคุณตัดสินใจว่าบอทตัวไหนไม่ควรอ่านเว็บ เครื่องมือก็ส่ง snippet แบบก๊อปวางสำหรับ block ให้ทันที และทุกอย่างประมวลผลในเบราว์เซอร์ การตั้งค่าของคุณจึงไม่หลุดออกจากเครื่อง
ทำไมต้องใช้ AI Crawler Checker?
- บอทที่อนุญาตแบบเงียบ ๆ: robots.txt ที่ไม่เคยรีวิว คือใบอนุญาตให้ AI crawler ทุกตัวที่มีอยู่วันนี้ และทุกตัวที่จะเปิดตัววันหน้า
- เทรนโมเดลกับค้นหาเว็บเป็นคนละเรื่อง: GPTBot เก็บข้อมูลไปเทรน ส่วน OAI-SearchBot ป้อนผลค้นหา การ block ทั้งคู่กับ block ตัวเดียวเป็นการตัดสินใจที่ต่างกันคนละขั้ว
- สองพื้นที่ ตรวจรวดเดียว: กฎ AI กระจายอยู่ทั้งใน robots.txt และ meta tags บนหน้าเว็บ ซึ่งมักขัดกันเอง เครื่องมือจะตรวจทั้งสองส่วนพร้อมกัน
- ลิสต์บอทโตไม่หยุด: Bytespider, meta-externalagent, Applebot-Extended เกิดใหม่ตลอดเวลา ผลตรวจเมื่อปีก่อนจึงพูดถึงไตรมาสนี้ได้น้อยมาก
- ผลลัพธ์ที่ลงมือได้ทันที: ทุก verdict มาพร้อม snippet สำหรับ block แบบก๊อปวาง ช่องว่างระหว่างรู้กับแก้จึงเหลือแค่การวางครั้งเดียว
- เป็นส่วนตัวตั้งแต่การออกแบบ: การประมวลผลเกิดขึ้นในเบราว์เซอร์ล้วน ๆ ข้อมูลการตั้งค่าเว็บของคุณจึงไม่ถูกส่งขึ้นเซิร์ฟเวอร์ใด ๆ
ฟีเจอร์หลักของเครื่องมือ
| Feature | What it does |
|---|---|
| ตรวจแบบวางแล้วจบ | วาง robots.txt ที่ใช้จริงและ meta tags จากเทมเพลตสำคัญ ไม่ต้องให้ใครไต่เว็บคุณ |
| Per-bot verdicts | สรุป blocked หรือ allowed by default ให้ GPTBot, ClaudeBot, CCBot, PerplexityBot, Google-Extended และบอทหลักอีกมากมาย |
| จับค่าเริ่มต้น | ไล่ flag ทุกบอทที่ไม่มีกฎครอบคลุม เปลี่ยนสิทธิ์แบบเงียบ ๆ ให้กลายเป็นแถวที่มองเห็น |
| Blocking snippets | กลุ่มกฎ robots.txt พร้อมก๊อปวาง สำหรับบอทที่คุณตัดสินใจไล่ออก |
| ประมวลผลในเบราว์เซอร์ | การ parse และจับคู่กฎทำงานบนเครื่องของคุณทั้งหมด |
รายละเอียดที่ควรรู้:
- ตรรกะการตัดสิน verdict เลียนแบบพฤติกรรม parser จริง: กลุ่ม user-agent ที่เจาะจงที่สุดชนะเสมอ และไฟล์ที่ขาดหายหรือกฎที่ว่างเปล่าแปลว่าอนุญาตทั้งหมด
- ผลจาก meta tags บอกคุณว่าสัญญาณระดับหน้าเว็บช่วยได้ตรงไหน และตรงไหนที่ robots.txt เป็นทางเดียวที่ได้ผล
- ใช้งานซ้ำได้ตามใจ: วางฉบับร่าง อ่าน verdict แก้ แล้ววางใหม่ จนกว่าทุกแถวจะตรงกับเจตนาของคุณ
วิธีใช้ AI Crawler Checker ทีละขั้น
- วาง robots.txt ของคุณ. เปิด https://yourdomain.com/robots.txt ก๊อปเนื้อหาทั้งไฟล์ แล้ววางลงช่อง robots.txt ถ้าเว็บคุณยังไม่มีไฟล์นี้เลย การตรวจก็เริ่มจาก baseline ที่ถูกต้อง: ทุกบอทได้รับอนุญาต
- วาง meta tags. เพิ่ม meta tags ที่ใช้บนเทมเพลตสำคัญ เช่น หน้าบทความ หน้าสินค้า หน้ารูปภาพ เพื่อให้สัญญาณระดับหน้าเว็บถูกตรวจด้วย
- อ่าน per-bot verdicts. ไล่ดูผลของ GPTBot, ClaudeBot, CCBot, PerplexityBot, Google-Extended และตัวอื่น ๆ อะไรที่ติด allowed by default แปลว่าตอนนี้มันไต่ได้เต็มสิทธิ์
- ตั้งนโยบายให้ทีละบอท. ชั่งน้ำหนักระหว่างการเข้าถึงเพื่อเทรนกับการมองเห็นใน search (ดูหัวข้อถัดไป) แล้วกำหนดว่าตัวไหนอนุญาตโดยเจตนา ตัวไหนต้อง block
- ก๊อป snippet แล้ว deploy. สำหรับบอทที่ block ให้วางกลุ่มกฎที่สร้างให้ลง robots.txt จริง deploy แล้วเอาไฟล์ใหม่กลับมาตรวจซ้ำ เพื่อยืนยันว่าทุก verdict พลิกตามที่ตั้งใจ
ใครกำลังเอาคอนเทนต์ของคุณไปเทรน AI
user agents สาย AI หลัก ๆ อยู่ในมือบริษัทไม่กี่เจ้า และจุดประสงค์ต่างกัน GPTBot กับ OAI-SearchBot เป็นของ OpenAI ตัวแรกเก็บข้อมูลเทรน ตัวหลังสร้าง search index ให้ ChatGPT search ClaudeBot เป็นของ Anthropic ไต่เว็บเพื่อเทรนโมเดล CCBot ดูแลโดย Common Crawl องค์กรไม่แสวงผลกำไรที่เผยแพร่ dataset เว็บเปิดซึ่งถูกใช้เทรนโมเดลกันแพร่หลาย — block ตัวนี้ตัวเดียวเท่ากับปิดวาล์วบริษัท AI ปลายทางจำนวนมากในคราวเดียว PerplexityBot ขับเคลื่อนเอนจินตอบคำถามของ Perplexity ส่วน Google-Extended ไม่ใช่ crawler แต่เป็นสวิตช์ควบคุมว่า Google จะเอาคอนเทนต์ของคุณไปเทรน Gemini และโมเดลในเครือได้หรือไม่ โดยแยกจาก Googlebot และ Google Search อย่างสิ้นเชิง เพิ่ม Bytespider (ByteDance), meta-externalagent (Meta) และ Applebot-Extended (Apple) เข้าไป รายชื่อจึงครอบคลุมเกือบทั้งวงการ
เรื่อง semantics สำคัญมาก robots.txt เป็น allow-by-default และเป็นข้อตกลงแบบสมัครใจ: บอทที่ไม่มีกฎครอบคลุมย่อมไต่ได้ และการทำตามขึ้นอยู่กับมารยาท — เจ้าใหญ่ที่มีชื่อเสียงทำตาม แต่นักขูดบางเจ้าไม่สนใจ กฎผูกกับกลุ่ม user-agent กลุ่มที่เจาะจงที่สุดชนะเสมอ และไม่มีการสืบทอดสิทธิ์จาก Googlebot ไปยัง GPTBot
meta tags เป็นพื้นที่ที่สองและอ่อนกว่า สัญญาณอย่าง nosnippet หรือ noarchive มีผลต่อผลค้นหา ส่วน token ใหม่อย่าง noai และ TDM reservation พยายามปฏิเสธการเทรน แต่มีแค่ crawler ที่ดึงและ parse HTML ของคุณเท่านั้นที่เห็นสัญญาณเหล่านี้ และไม่มีผู้ให้บริการ AI ถูกผูกมัดให้ทำตามครบทุกตัว จุดที่น่าสังเกตคือ Google-Extended ไม่มี meta tag เทียบเท่า — robots.txt คือสวิตช์เดียวของมัน
ทางออกที่ใช้ได้จริงคือนโยบายรายบอท ตัดสินใจอย่างชัดเจน: crawler สายเทรนจะเข้าหรือออก crawler สาย search มักควรเข้าเพราะช่วยให้คนพบเว็บคุณ dataset builder อย่าง CCBot ตัดสินใจแยกสายเป็นของตัวเอง ส่วนสวิตช์อย่าง Google-Extended ปรับตามจุดยืนของแบรนด์ เครื่องมือให้แถวตัดสินใจครบทุกตัว ไม่เหลืออะไรให้ค่าเริ่มต้นชี้ขาดแทนคุณ
ตัวอย่างการใช้งานจริง
สำนักข่าวตัดสินใจเรื่องการ block
เว็บข่าวแห่งหนึ่งพบว่า GPTBot และ CCBot เข้าถึงคอนเทนต์ได้หมด ทีมบรรณาธิการต้องการทราฟฟิกจาก search แต่ไม่ต้องการให้เนื้อหาถูกเอาไปเทรนเป็นวงกว้าง จึง block GPTBot กับ CCBot อนุญาต OAI-SearchBot และตั้ง Google-Extended เป็น disallow ผลตรวจยืนยันทุก verdict ก่อนไฟล์ขึ้นเซิร์ฟเวอร์จริง
นโยบายเอกสารของ SaaS
บริษัทซอฟต์แวร์อยากให้เอกสารสาธารณะถูกอ้างถึงในคำตอบ AI เพราะเท่ากับการกระจายสินค้าฟรี แต่ไม่อยากให้ถูกดูดกลืนทั้งก้อน จึงอนุญาต crawler สาย search block สายเทรน และเขียนเหตุผลไว้เป็นคอมเมนต์ใน robots.txt เพื่อให้ทีมดูแลรุ่นถัดไปเข้าใจที่มา
การปกป้องพอร์ตโฟลิโอศิลปิน
นักวาดภาพประกอบคนหนึ่งพบว่าแกลเลอรีของตัวเองถูกไต่และสไตล์การวาดถูกเลียนแบบ เขาจึง block AI user agents ทุกตัวจากไดเรกทอรีพอร์ตโฟลิโอ คง search engine ทั่วไปไว้โดยไม่กระทบ แล้วกลับมาตรวจซ้ำทุกไตรมาสเมื่อบอทขูดงานศิลป์หน้าใหม่เปิดตัว
การทบทวนเพื่อ compliance ก่อนเปิดตัว
เอเจนซีรับงานเว็บลูกค้ากลางไฟล์รีดีไซน์ ก่อนเปิดตัวจึงเอา robots.txt และ meta tags มาผ่านเครื่องมือ ทำตาราง per-bot ส่งทีมกฎหมายของลูกค้าตรวจ แล้ว deploy snippet ที่ตกลงกันไว้พร้อมรีลีสเดียวกัน
แนวปฏิบัติที่แนะนำ
- เขียนกฎแบบชัดเจน ไม่ใช่การปล่อยว่าง. เพิ่มกลุ่มกฎระบุชื่อให้บอท AI หลักทุกตัวพร้อม Allow หรือ Disallow ชัด ๆ เพื่อให้เจตนาของคุณรอดจากการ deploy ใหม่และการย้าย CMS
- ทดสอบหลัง deploy. เอาไฟล์จริงกลับมาตรวจซ้ำ เพราะพิมพ์ผิดใน robots.txt เพียงจุดเดียวก็พลิกนโยบายกลับสู่ allow-by-default ได้อย่างเงียบ ๆ
- กลับมาดูลิสต์บอททุกไตรมาส. เอเจนต์ใหม่เปิดตัวตลอด ผลตรวจคือสแนปช็อต ณ ช่วงเวลาหนึ่ง ไม่ใช่สถานะถาวร
- จับคู่ robots.txt กับการยืนยันตัวตนสำหรับคอนเทนต์ส่วนตัว. robots.txt เป็นเพียงคำขอให้บอทที่มีมารยาทออกไป อะไรที่เป็นส่วนตัวจริง ๆ ต้องมี login หรือ paywall คุ้มกัน
- เขียนคอมเมนต์บอกเจตนาไว้ในไฟล์. โน้ตสั้น ๆ หนึ่งบรรทัดต่อกลุ่มกฎ อธิบายว่ากฎนั้นเกิดขึ้นเพราะอะไร ไว้ให้เพื่อนร่วมทีมที่จะแก้ไฟล์ปีหน้า
- จับตา server logs หาตัวดื้อ. บอทที่ไม่สน robots.txt จะโผล่ใน access logs เท่านั้น ไม่เคยปรากฏในไฟล์
พร้อมเห็นความเสี่ยงจริงของคุณแล้วหรือยัง เปิด AI Crawler Checker วาง robots.txt และ meta tags ของคุณ แล้วเปลี่ยนทุกค่าเริ่มต้นที่เงียบให้เป็นการตัดสินใจที่ชัดเจน ใช้เวลาเพียงประมาณห้านาทีเท่านั้น
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Robots.txt Generator — สร้าง robots.txt ใหม่ตั้งแต่ต้นพร้อมกลุ่มกฎ AI crawler ในตัว
- Robots.txt Tester — ตรวจ URL ทีละหน้ากับกฎของคุณก่อน deploy จริง
- Security Headers Generator — ปิดจุดอ่อนด้าน HTTP ส่วนที่เหลือของเว็บในรอบเดียว
ขอให้สนุกกับการตรวจสอบ!
คำถามที่พบบ่อย
ถ: Block GPTBot แล้วกระทบอันดับใน Google Search ไหม? ตอบ: ไม่กระทบ GPTBot เป็น crawler สายเทรนของ OpenAI แยกจาก Googlebot และ Google-Extended อย่างสิ้นเชิง การ block จึงไม่แตะต้องการ index หรืออันดับใน Google Search เลย ส่วน Google-Extended คุมแค่ว่า Google จะเอาคอนเทนต์ไปเทรนโมเดลอย่าง Gemini ได้หรือไม่
ถ: พึ่ง meta tags อย่างเดียวเพื่อ block AI crawler ได้ไหม? ตอบ: ไม่ควร meta tags มีแค่ crawler ที่ดึงและ parse HTML ของคุณเท่านั้นที่เห็น และไม่มีผู้ให้บริการ AI ถูกผูกมัดให้ทำตามครบทุกตัว robots.txt คือเครื่องมือหลักสำหรับ GPTBot, ClaudeBot, CCBot และ PerplexityBot โดย meta tags ควรเป็นตัวเสริม ไม่ใช่ตัวแทน
ถ: AI crawler มีหน้าที่ต้องทำตาม robots.txt หรือเปล่า? ตอบ: robots.txt เป็นข้อตกลงทางสังคม ไม่ใช่กฎหมาย เจ้าใหญ่อย่าง OpenAI, Anthropic, Google และ Perplexity เปิดเผยพฤติกรรมและมักทำตามอย่างจริงจัง แต่นักขูดบางเจ้าเมินหน้าหนี จึงควรมอนิเตอร์ logs และใช้การยืนยันตัวตนป้องกันคอนเทนต์ส่วนตัวควบคู่กันไป