Avro Schema Generator: แปลงตัวอย่าง JSON เป็น Avro Record Schema ที่มี type ครบในไม่กี่วินาที
คู่มือใช้งาน Avro Schema Generator เครื่องมือสร้าง Apache Avro record schema จากตัวอย่าง JSON พร้อม type inference, logical types อย่าง uuid และ timestamp-millis, nullable union และ nested record ทำงานฝั่ง client ทั้งหมด
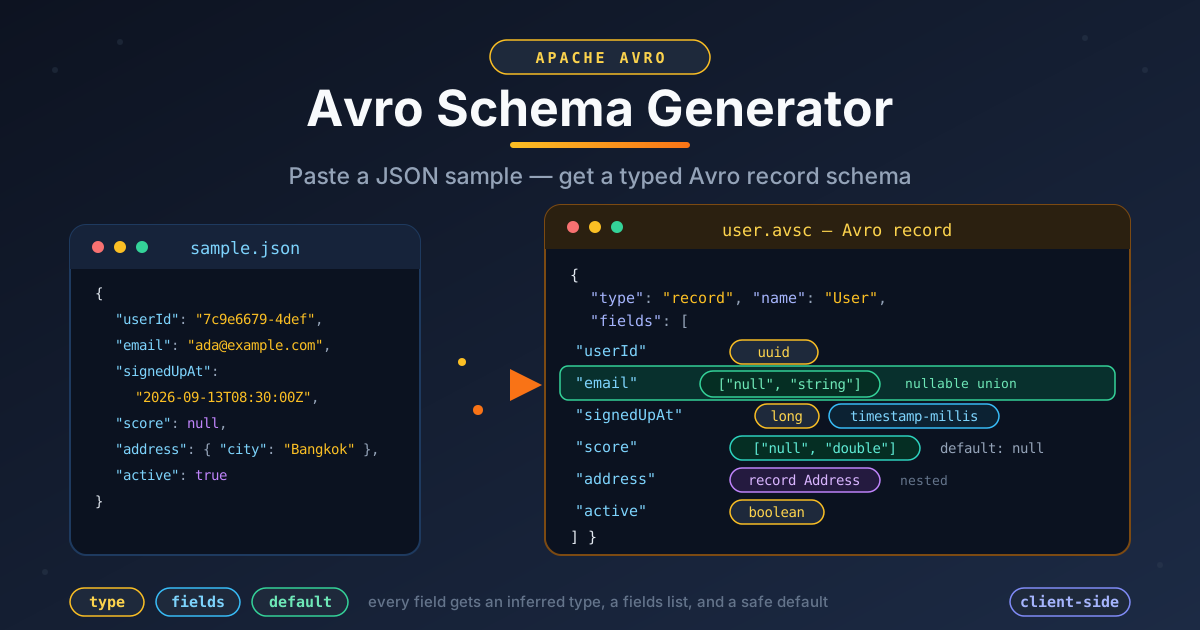
Table of Contents
Avro Schema Generator: แปลงตัวอย่าง JSON เป็น Avro Record Schema ที่มี type ครบในไม่กี่วินาที
ถ้าทำงานสาย data คงคุ้นเคยกับ Apache Avro ดี ไม่ว่าจะเป็น Kafka, event streaming, schema registry หรือ data lake ต่างก็ใช้ Avro เป็นรูปแบบข้อมูลหลัก เพราะมันบีบอัดข้อมูลเป็น binary ได้เล็กกว่า JSON มาก และที่สำคัญคือมีกติกาการ schema evolution ที่ชัดเจน ทำให้ producer และ consumer หลายตัวแลกเปลี่ยนข้อมูลกันได้อย่างน่าเชื่อถือแม้ schema จะเปลี่ยนไปตามกาลเวลา
แต่ทุก event ที่ส่งออกไปต้องมี schema กำกับ และการนั่งเขียน Avro record schema ด้วยมือทุกครั้งเป็นงานที่น่าเบื่อสุด ๆ ต้องไล่ประกาศ field ทีละตัว เลือก primitive type ให้ถูก ครอบ field ที่เป็น null ได้ด้วย union แล้วยังต้องจำให้ได้ว่า default ต้องตรงกับ branch แรกของ union ด้วย แค่พิมพ์ int ผิดตอนที่ควรเป็น long ก็อาจทำให้ compatibility check พังหรือข้อมูลผิดเพี้ยนไปทั้งวันได้
นี่คือปัญหาที่ Avro Schema Generator จาก Online Tools Forge ถูกสร้างมาแก้โดยตรง เพียงวางตัวอย่าง JSON ลงไป คุณก็จะได้ Avro record schema ที่สมบูรณ์ทันที ทั้ง inferred types, logical types อย่าง uuid และ timestamp-millis, nullable union และ nested record โดยทำงานฝั่ง client ทั้งหมดใน browser ของคุณ บทความนี้จะพาไปดูว่าการ type inference ทำงานอย่างไร และ schema ที่ได้นำไปใช้จริงตรงไหนได้บ้าง
ทำไมต้องใช้ Avro Schema Generator
- ตัดงานเขียน boilerplate ทิ้ง — Avro record หนึ่งอันจริง ๆ มักยาวหลายสิบบรรทัดเต็มไปด้วย fields, type และ default ซ้ำ ๆ การ generate โครงจากข้อมูลจริงใช้เวลาแค่ไม่กี่วินาที เหลือเวลาไปคิดเรื่องความหมายของข้อมูลแทน
- ทำ nullable field ถูกตั้งแต่ครั้งแรก — Avro ไม่มี optional type ความสามารถ "เป็น null ได้" ต้องเขียนเป็น union และ default ต้องตรงกับ branch แรกเสมอ เครื่องมือจะ emit ["null", "type"] โดยให้ null อยู่หน้าพร้อม default ที่ตรงกัน ซึ่งเป็นรูปแบบที่กฎ compatibility ของ registry คาดหวัง
- รักษาความหมายด้วย logical types — string ที่แท้จริงคือ UUID หรือ timestamp ที่ควรถูก serialize เป็นมิลลิวินาที จะมีข้อมูลครบกว่ามากเมื่อติด annotation uuid หรือ timestamp-millis ซึ่งเครื่องมือตรวจจับรูปแบบเหล่านี้ให้อัตโนมัติ
- รักษาโครงสร้างซ้อนไว้ครบถ้วน — object ที่ซ้อนกันใน JSON จะกลายเป็น nested record type ที่สะท้อนข้อมูลจริง ทำให้ consumer เห็น hierarchy แบบเดียวกับที่ producer ส่งมา
- เริ่ม workflow แบบ schema-first ได้ไว — ไม่ว่าจะเปิด Kafka topic ใหม่ จะ register subject หรือจะนิยามตารางใน data lake การเริ่มจาก schema ร่างที่แม่นยำย่อมไวกว่าเริ่มจากหน้าจอว่าง
- ข้อมูลไม่ออกจากเครื่อง — ทุกอย่างทำงานใน browser ตัวอย่างข้อมูลจาก production หรือ event shape ภายในบริษัทจึงไม่ถูกส่งไปไหน
ฟีเจอร์เด่น
| ฟีเจอร์ | รายละเอียด |
|---|---|
| แปลง JSON เป็น Avro record | วาง JSON object แล้วได้ Avro record schema ที่สมบูรณ์ทันที |
| Type inference | จับคู่ค่า JSON กับ string, int, long, double และ boolean จากตัวอย่างข้อมูลจริง |
| Nullable union | field ที่เป็น null ได้จะกลายเป็น union ["null", "type"] พร้อม default ที่สอดคล้องกัน |
| Logical types | ตรวจจับ string รูปแบบ UUID และ ISO timestamp แล้วติด annotation uuid และ timestamp-millis |
| Nested records | JSON object ที่ซ้อนกันกลายเป็น nested record ที่มี field list ของตัวเอง |
| ทำงานฝั่ง client 100% | ทุกอย่างรันใน browser ไม่มีการอัปโหลด ไม่ต้องสมัครสมาชิก ไม่ต้องรอ |
จุดที่น่าสนใจเป็นพิเศษมีสามเรื่อง:
- ขนาดของ integer มีผลจริง — เครื่องมือแยก int (32-bit) กับ long (64-bit) จากขนาดของตัวเลข ทำให้ id ตัวใหญ่ ๆ หรือ epoch millis ไม่ตกไปอยู่ type ที่ล้นแบบเงียบ ๆ
- union เป็นไปตาม convention ของ Avro — union ทุกตัวเริ่มด้วย null ทำให้ default: null ที่ generate ให้ใช้ได้ทันทีตามกฎที่ว่า default ต้องตรงกับ branch แรก
- ผลลัพธ์คือจุดเริ่มต้น ไม่ใช่จุดจบ — แก้ไขต่อได้อิสระ เพิ่ม enum เปลี่ยนชื่อ field หรือบีบ constraint ก่อนส่งเข้า registry
วิธีใช้งาน
- วางตัวอย่าง JSON — คัดลอก payload ที่เป็นตัวแทนของข้อมูลจริง (object เดียวก็พอ) ลงในช่อง input ตัวอย่างจาก traffic จริงให้ schema ที่แม่นกว่าตัวอย่างแบบเรียบร้อยหวือหวา
- ตรวจ record ที่ได้ — เครื่องมือสร้าง record พร้อม fields array ให้ทันที หนึ่งรายการต่อหนึ่ง key ใน JSON พร้อม type ที่ infer มาแล้ว
- เช็ก union และ logical types — ยืนยันว่า field ที่กลายเป็น nullable นั้น optional จริงในโดเมนของคุณ และ annotation uuid กับ timestamp-millis ที่ตรวจจับได้ตรงกับความตั้งใจ
- เปลี่ยนชื่อ record ถ้าจำเป็น — ตั้งชื่อให้ตรงกับ topic หรือ entity เพื่อให้ subject ใน registry อ่านรู้เรื่อง
- คัดลอกไปใช้งาน — นำ schema ไปวางใน producer configuration, register ลง schema registry หรือ commit ไว้ข้างนิยามตาราง
ประเภทของ Avro ที่ได้จากตัวอย่าง JSON
หัวใจของเครื่องมือนี้คือการ inference คือการเดินไล่ค่าใน JSON แล้วจับคู่กับ Avro type ที่แม่นที่สุด ลองดูตัวอย่าง JSON คู่กับ schema ที่ได้:
{
  "userId": "7c9e6679-7422-4def-b2c9-3b71c8a2e5d1",
  "email": "[email protected]",
  "signedUpAt": "2026-09-13T08:30:00Z",
  "score": null,
  "active": true
}
{
  "type": "record",
  "name": "GeneratedRecord",
  "fields": [
    {
      "name": "userId",
      "type": { "type": "string", "logicalType": "uuid" }
    },
    {
      "name": "email",
      "type": "string"
    },
    {
      "name": "signedUpAt",
      "type": { "type": "long", "logicalType": "timestamp-millis" }
    },
    {
      "name": "score",
      "type": ["null", "double"],
      "default": null
    },
    {
      "name": "active",
      "type": "boolean"
    }
  ]
}
Primitive inference เริ่มจากค่าของข้อมูลเอง — ข้อความในเครื่องหมายคำพูดกลายเป็น string, จำนวนเต็มเป็น int หรือ long ตามขนาด, ทศนิยมเป็น double และ true/false เป็น boolean
Nullable union คือวิธีบอกความเป็น optional — เพราะ score เป็น null ในตัวอย่าง มันจึงถูกขยายเป็น ["null", "double"] และที่ null ต้องอยู่ branch แรกไม่ใช่เรื่องความสวยงาม: Avro กำหนดให้ default ต้องตรงกับ branch แรกของ union ดังนั้น default: null ใช้ได้เฉพาะเมื่อเรียงลำดับแบบนี้เท่านั้น
Logical types เติมความหมายทับบนพื้นที่จัดเก็บ — annotation uuid บอก consumer ว่า string นี้ต้องเป็น UUID ที่ถูกต้อง ส่วน timestamp-millis ลึกกว่านั้น: type พื้นฐานคือ long แต่ logical type ประกาศว่าเลขนั้นคือมิลลิวินาทีนับจาก epoch แค่ annotation เดียวทำให้ timestamp ใน JSON วนไปกลับได้เป็นเลข 8 ไบต์กะทัดรัดโดยไม่เสียความหมาย
Object ที่ซ้อนกันกลายเป็น nested record — object อย่าง address จะกลายเป็น field ที่มี type เป็น record ของตัวเอง โดย field ด้านในถูก infer ด้วยวิธีเดียวกัน hierarchy จึงรอดจากการแปลงมาได้ครบ
เรื่อง default มีข้อควรระวัง — เครื่องมือใส่ default ให้เฉพาะ nullable union ซึ่ง null เป็นค่าที่ปลอดภัยพอจะอยู่ branch แรก ส่วน field อื่นการไม่มี default คือเจตนา เพราะ default ที่ผิดจะเติมค่าที่ producer ไม่เคยตั้งใจส่งแบบเงียบ ๆ ควรเพิ่มเองตามแผน evolution ของคุณ
กรณีการใช้งานจริง
1. ตั้งค่า Kafka producer
เปิด topic ใหม่พร้อม schema ที่ถูกต้องตั้งแต่วันแรก เก็บ payload จริงสักชุด generate เป็น record แล้วเอาไปวางใน producer configuration schema จะเริ่มจาก payload จริง แทนที่จะค่อย ๆ เพี้ยนห่างจากโค้ดที่ serialize event
2. Bootstrap schema registry
การ register เวอร์ชันแรกของ subject คือจุดที่พิมพ์ผิดแพงที่สุด เพราะทุกเวอร์ชันถัดไปถูกตรวจเทียบกับมัน generate schema จาก payload ที่พิสูจน์แล้ว ตรวจทาน แล้ว register ลงไป เวอร์ชันถัด ๆ ไปจะได้ผ่าน compatibility check บนรากฐานที่คุณไว้ใจ
3. นิยามตารางใน data lake
Engine สายวิเคราะห์ที่กิน Avro ต้องมี schema ไว้นิยาม column และ type generate schema จาก event ตัวอย่างแล้วส่งต่อให้ ingestion job column userId ของคุณจะมาเป็น string ที่รู้ว่าเป็น UUID ไม่ใช่ varchar ไร้ตัวตน
4. ใช้สอนและเรียนรู้ Avro
กฎเรื่อง union และ logical type เรียนรู้ได้ไวที่สุดด้วยตัวอย่าง ลองวาง JSON แล้วแก้ค่าจาก 42 เป็น null ดูว่า schema เปลี่ยนตอบสนองอย่างไร เป็น feedback loop ที่เร็วมากสำหรับทีมที่กำลังเริ่มใช้ event แบบ schema-first
แนวปฏิบัติที่ดี
- ทาน type ที่ infer มากับความตั้งใจด้วยตัวเอง — inference เห็นแค่ตัวอย่างเดียว ถ้า quantity ไม่ควรมีทศนิยม หรือ long ควรเป็น int จริง ๆ ให้แก้ก่อน schema กลายเป็น contract
- ใช้ตัวอย่างที่ครอบคลุม — field ที่บังเอิญเป็น null ในตัวอย่างจะกลายเป็น nullable ใน schema ควรเลือกตัวอย่างที่สะท้อนความหลากหลายของข้อมูลจริง
- ใส่ default ก่อนขยับ schema — ให้ field เดิมมี default ที่สมเหตุสมผลก่อนเพิ่ม field ใหม่ เพื่อให้ consumer ตัวเก่าอ่าน record ใหม่ได้ระหว่าง rolling deployment
- Evolve ผ่าน compatibility check — เปลี่ยน schema ผ่าน compatibility mode ของ registry เสมอ นั่นคือสิ่งที่เปลี่ยน schema จากเอกสารให้กลายเป็นคำสัญญา
- ระวังเรื่องความละเอียดของตัวเลข — double เหมาะกับคะแนนหรือ ratio แต่ข้อมูลเงินมักควรใช้ bytes กับ logical type แบบ decimal ซึ่งต้องปรับเอง
- ดูแล schema เหมือนโค้ด — commit schema ที่ generate ได้เข้า version control และให้ผ่าน pull request เพื่อให้การเปลี่ยน schema ได้รับการ review เทียบเท่ากับโค้ดแอปพลิเคชัน
เริ่มสร้าง Avro Schema ของคุณวันนี้
เลิกนั่งเขียน fields array เองและเลิกเดาลำดับ union แล้วไปใช้ Avro Schema Generator กันเถอะ วางตัวอย่าง JSON สักชุด แล้วรับ Avro record schema ที่เป๊ะตาม convention ภายในไม่กี่วินาที ฟรี ไม่ต้องสมัครสมาชิก และทำงานใน browser ของคุณล้วน ๆ
เครื่องมืออื่น ๆ ที่คุณอาจสนใจ:
- JSON Formatter — จัดรูปแบบ, minify และ validate JSON ของคุณให้เรียบร้อยก่อนเอาไปทำ schema
- JSON Schema Visualizer — สำรวจโครงสร้าง JSON ที่ซ้อนกันแบบเห็นภาพ เข้าใจ shape ที่กำลังจะ model
- OpenAPI to TypeScript Converter — แปลง API contract เป็น TypeScript types เพื่อ producer และ consumer ที่ type-safe
ขอให้สนุกกับการตีเหล็ก schema และขอให้ union ของคุณ null อยู่หน้าเสมอจ๊ะ
คำถามที่พบบ่อย
ถ: JSON ของฉันถูกอัปโหลดขึ้น server ไหม?
ตอบ: ไม่ Avro Schema Generator ทำงานทั้งหมดใน browser ของคุณด้วย JavaScript ฝั่ง client ตัวอย่างข้อมูลไม่เคยออกจากเครื่อง จึงใช้กับ payload จาก production หรือ event shape ภายในองค์กรได้อย่างปลอดภัย
ถ: ทำไม null ถึงต้องอยู่ branch แรกของ union ที่ generate ออกมาเสมอ?
ตอบ: เพราะ Avro กำหนดให้ default ของ field ต้องตรงกับ branch แรกของ union การ emit ["null", "type"] พร้อม default: null ทำให้ schema ใช้ได้ทันทีและผ่าน compatibility check ที่จะ reject กรณีเรียงสลับข้าง
ถ: ตอนไหนที่ inference เลือก int แทนที่จะเป็น long?
ตอบ: จำนวนเต็มที่อยู่ในช่วง 32-bit จะได้เป็น int ส่วนค่าที่ใหญ่กว่าจะได้ long ถ้าค่าวันนี้ยังเล็กแต่มีแนวโน้มโต เปลี่ยนเป็น long ก่อน register schema จะดีกว่า
ถ: เอา schema ที่ได้ไปใช้กับ Kafka ตรง ๆ ได้เลยไหม?
ตอบ: ได้ ผลลัพธ์เป็น Avro record schema มาตรฐานนามสกุล .avsc พร้อมนำไปวางใน producer configuration, register เป็น subject ใน schema registry หรือใช้กับ ingestion job ที่รองรับ Avro ได้ทันที