Case Style Converter: แปลง identifier ครบทั้ง 8 สไตล์ ตั้งแต่ camelCase ถึง Train-Case
เรียนรู้วิธีแปลง identifier ระหว่าง camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE, dot.case, Title Case และ Train-Case พร้อมจัดการ acronym และตัวเลขอย่างฉลาด ทำงานในเบราว์เซอร์ 100%
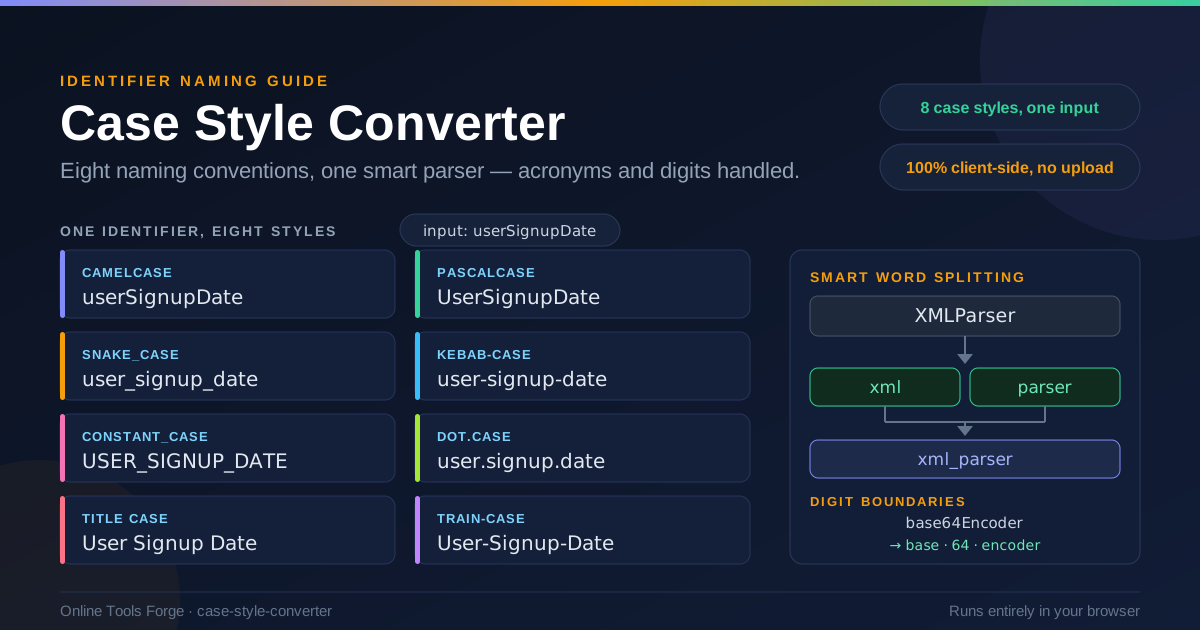
Table of Contents
Case Style Converter: แปลง identifier ครบทั้ง 8 สไตล์ ตั้งแต่ camelCase ถึง Train-Case
ทุกชั้นของ stack ตั้งชื่อสิ่งเดียวกันไว้คนละแบบ ตัวแปรใน JavaScript เป็น lastLoginTimestamp แบบ camelCase แต่คอลัมน์ในฐานข้อมูลที่มันมาจากกลับเป็น last_login_timestamp แบบ snake_case ส่วน CSS class ที่ใช้จัดการหน้าตามันกลายเป็น .last-login-timestamp แบบ kebab-case และ environment variable ที่ใช้ตั้งค่า timeout ก็เป็น LOGIN_TIMEOUT_MS แบบ CONSTANT_CASE — ความหมายเดิมทั้งหมด เปลี่ยนแค่ convention ของแต่ละชั้นเท่านั้น
การพิมพ์แปลงเองด้วยมือคือจุดกำเนิดของบั๊ก ลืมขีดล่างนึกดื่ม หรือจำไม่ได้ว่า XMLParser ควรกลายเป็น xmlParser ไม่ใช่ xMLParser แค่จุดเดียวก็อาจกลายเป็น field mismatch ที่โผล่มาตอน runtime เท่านั้น Case Style Converter รับ identifier ที่คุณป้อนเข้ามา แยกเป็นคำอย่างฉลาด — รวมถึง acronym และขอบเขตตัวเลข — แล้วแสดงผลครบทั้ง 8 รูปแบบยอดนิยมพร้อมกันในเบราว์เซอร์ของคุณ
ในบทความนี้เราจะพาไปดูว่าทำไมแต่ละ convention ถึงมีอยู่ กฎการแยกคำแบบ smart ทำงานอย่างไร และเครื่องมือแปลงที่เชื่อถือได้ช่วยกันบั๊กเล็ก ๆ ที่สะสมทั่วโค้ดเบสจริงได้อย่างไร
ทำไมต้องใช้ Case Style Converter?
Naming convention ไม่ใช่แค่การตกแต่ง แต่เป็นสัญญาระหว่างชั้นต่าง ๆ ของระบบ นี่คือสิ่งที่เครื่องมือแปลงเฉพาะทางให้คุณ:
- ความสม่ำเสมอทั่วทั้ง stack เมื่อ entity เดียวกันปรากฏเป็น camelCase ใน frontend, snake_case ในฐานข้อมูล และ kebab-case ใน URL เครื่องมือช่วยให้คำที่ใช้เหมือนกันทุกประการ — userSignupDate จะไม่หลุดไปเป็น userSignUpDate กลางทาง
- จัดการ acronym ถูกต้อง สายตาคนเราไม่เห็นด้วยกันว่า XMLHTTPRequest ควรแยกตรงไหน เครื่องมือใช้กฎที่แน่นอน XMLParser ก็จะกลายเป็น xml · parser ทุกครั้ง ไม่ใช่เดาตามอารมณ์ตอนห้าโมงเย็นวันศุกร์
- แยกขอบเขตตัวเลขให้ identifier อย่าง base64Encoder หรือ sha256Hash ต้องแยกที่ขอบเขตตัวเลขให้ถูก สคริปต์ธรรมดามักพัง แต่เครื่องมือนี้จัดการได้
- เร็วขึ้นตอน refactor การเปลี่ยนชื่อ field ใน API หมายถึงต้องแก้ทั้ง route, model, serializer และเอกสาร วางครั้งเดียวได้ครบ 8 รูปแบบทันที แทนการพิมพ์เองแปดรอบ
- ลดบั๊กเรื่องตัวพิมพ์ใน code review การวางรูปแบบ canonical จากเครื่องมือลงใน pull request ตัดพิมพ์ผิดแบบ "ดูเหมือนถูกแล้วมั้ง" ออกไปทั้งประเภท
- ไม่มีขั้นตอนติดขัด ทำงานฝั่ง client 100% ไม่ต้องสมัคร ไม่ต้องอัปโหลด ไม่มีข้อมูลออกจากเครื่อง ซึ่งสำคัญมากเวลา identifier มาจาก internal API ที่ยังไม่เปิดเผย
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| ครบ 8 สไตล์ | camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE, dot.case, Title Case และ Train-Case จาก input เดียว |
| Smart word splitting | ตรวจจับขอบเขตคำใน identifier ที่เขียนติดกัน เช่น userSignupDate แยกเป็น user, signup และ date |
| จัดการ acronym | แยก acronym ถูกต้อง เช่น XMLParser กลายเป็น xml และ parser แล้วประกอบกลับได้ในทุก case เป้าหมาย |
| ขอบเขตตัวเลข | ถือว่าชุดตัวเลขเป็น segment ของตัวเอง เช่น base64Encoder แยกเป็น base, 64 และ encoder |
| ผลลัพธ์พร้อมกันทันที | แสดงครบทั้ง 8 รูปแบบในจอเดียว คัดลอกรายตัวได้เลย |
| ทำงานฝั่ง client 100% | คำนวณทั้งหมดในเบราว์เซอร์ ไม่มีการส่งหรือเก็บข้อมูล |
บางฟีเจอร์น่าดูใกล้ ๆ กว่านั้น:
- ตัวแยกคำทำงานสองทาง — ป้อน USER_SIGNUP_DATE ก็ได้ userSignupDate และป้อน userSignupDate ก็ได้ USER_SIGNUP_DATE กลับกัน
- เพราะผลลัพธ์ทั้งหมดสร้างจาก word list ชุดเดียว แปดสไตล์จึงการันตีว่าสอดคล้องกัน ซึ่งเป็นสิ่งที่คุณต้องการเวลา field เดียวต้องตรงกันทั้งใน serializer, schema และ stylesheet
วิธีใช้งาน
ขั้นตอนถูกออกแบบให้จบในหน้าจอเดียว ไม่มีตั้งค่าให้ปวดหัว:
- เปิดเครื่องมือ เข้าไปที่ Case Style Converter — โหลดทันที และใช้งานได้แม้ออฟไลน์เมื่อแคชแล้ว
- วาง identifier ของคุณ เริ่มจาก convention ไหนก็ได้: invoiceTotalDue, invoice_total_due, Invoice-Total-Due หรือแม้แต่ INVOICE.TOTAL.DUE
- ดูวิธีแยกคำ เครื่องมือแสดงให้เห็นว่ามันแยก input ของคุณอย่างไร รวมถึงการจัดการ acronym และตัวเลข ถ้า IDNumber แยกเป็น id · number คุณก็รู้ว่าผลลัพธ์ทั้งหมดจะถูกต้อง
- คัดลอกสไตล์ที่ต้องการ ทั้ง 8 ผลลัพธ์แสดงพร้อมกัน — หยิบเวอร์ชัน snake_case ไปทำ migration และเวอร์ชัน camelCase ไปฝั่ง client ได้ในครั้งเดียว
- ทำซ้ำกับ field ชุดที่เหลือ ถ้าเปลี่ยนชื่อ field ทั้ง API ให้วางทีละตัว แล้วเก็บรายการแมปเก่า-ใหม่ไว้ทำ changelog
นั่นแหละคือทั้งหมดของหน้าจอ ไม่ต้องติดตั้ง ไม่มีบัญชี ไม่มีการยิง request ไป server
แต่ละ case อยู่ที่ไหน
ทักษะจริงของการตั้งชื่อคือการรู้ว่าแต่ละชั้นคาดหวัง convention แบบไหน นี่คือแผนที่ที่ทีมส่วนใหญ่ลงตัวกัน:
- camelCase — ตัวแปรและฟังก์ชันใน JavaScript และ TypeScript (userSignupDate), JSON payload จาก service ยุคใหม่ส่วนใหญ่ และชื่อ method ใน Java นี่คือภาษากลางของโค้ดแอปพลิเคชัน
- PascalCase — class และ component (UserSignupForm), ชื่อ React component, ชื่อ method ใน .NET และ TypeScript type ที่ export ออกไป ถ้ามันคือพิมพ์เขียวมากกว่าค่าคอนกรีต มักเป็น PascalCase
- snake_case — ตัวแปรและฟังก์ชันใน Python (user_signup_date), ชื่อคอลัมน์และตารางใน SQL, Ruby และ database migration เกือบทั้งหมด PostgreSQL ย้อม identifier ที่ไม่ครอบ quote ให้เป็นตัวพิมพ์เล็ก ซึ่งช่วยย้ำนิสัยนี้โดยไม่ตั้งใจ
- kebab-case — CSS class, URL และ slug (/user-signup-date), ชื่อไฟล์, HTML attribute และชื่อแพ็กเกจ npm ขีดกลางปลอดภัยใน URL และอ่านง่ายใน path
- CONSTANT_CASE — environment variable (MAX_RETRIES), ค่าคงที่ที่ใช้ร่วมกันทั้งโปรเจกต์ และเชลล์สคริปต์ที่ตัวพิมพ์ใหญ่ทั้งหมดส่งสัญญาณว่า "ตั้งค่านี้ก่อนรันด้วย"
- dot.case — config key และ log field (user.signup.date) พบบ่อยในไฟล์ INI, structured logging และ config แบบ namespaced
กฎการแยก acronym
Acronym คือจุดที่การแปลงด้วยมือพลาดบ่อยที่สุด เครื่องมือใช้กฎง่าย ๆ ที่คาดเดาได้: กลุ่มตัวพิมพ์ใหญ่ที่ต่อด้วยคำที่ขึ้นต้นด้วยตัวใหญ่หรือตัวเล็ก จะถูกแยก acronym ออกมาเป็นหน่วยของตัวเอง XMLParser จึงกลายเป็น xml กับ parser แล้วได้ xmlParser, XML_PARSER หรือ xml-parser ตามสไตล์เป้าหมาย เช่นเดียวกับที่ HTTPResponseCode กลายเป็น http · response · code — ไม่ใช่ hTTPResponseCode แบบที่ตรรกะแยกทีละตัวอักษรได้ผล กฎนี้ใช้ย้อนกลับได้ด้วย: parseXMLDocument แยกเป็น parse, xml และ document
ขอบเขตตัวเลข
ตัวเลขได้รับการปฏิบัติแบบเดียวกัน ชุดตัวเลขถือเป็น segment ของตัวเอง base64Encoder จึงแยกเป็น base, 64 และ encoder — ได้ base64_encoder, BASE64_ENCODER หรือ base64-encoder อย่างสะอาดเรียบร้อย มันสำคัญกว่าที่ฟังดู: identifier อย่าง utf8String, sha256Hash และ x509Certificate อยู่รอบตัวเรา และการเข้าใจขอบเขตผิดทำให้ได้ชื่อที่โดนตกรอบ code review ทันที
ตัวอย่างจริง: เปลี่ยนชื่อ field หนึ่งตัว
สมมติว่าทีม API ของคุณเห็นว่า maxRetryCount กำกวม และตัดสินใจเปลี่ยน concept เป็น "จำนวน retry สูงสุดต่อ endpoint" คุณจะต้องใช้ identifier ใหม่ในทุก convention ที่โค้ดเบสใช้:
| สไตล์ | ผลลัพธ์ |
|---|---|
| camelCase | maximumRetryAttempts |
| PascalCase | MaximumRetryAttempts |
| snake_case | maximum_retry_attempts |
| kebab-case | maximum-retry-attempts |
| CONSTANT_CASE | MAXIMUM_RETRY_ATTEMPTS |
| dot.case | maximum.retry.attempts |
| Title Case | Maximum Retry Attempts |
| Train-Case | Maximum-Retry-Attempts |
TypeScript client ได้แถวแรก, migration ของ Postgres ได้แถวที่สาม, route ของ API gateway ได้แถวที่สี่, config ของ Kubernetes ได้แถวที่ห้า, structured logger ได้แถวที่หก และเอกสารได้สองแถวท้าย คำเดิม ปลายทางแปดที่ — โดยไม่มีสักจุดที่ต้องพิมพ์เอง
กรณีใช้งานจริง
แมป field จาก API มาที่ frontend
นี่คือสถานการณ์คลาสสิก backend serialize แบบ snake_case, frontend พูดภาษา camelCase และทุก deserializer ที่คุณเขียนคือโอกาสพิมพ์ผิดหนึ่งครั้ง วาง field ของ payload ผ่านตัวแปลงครั้งเดียวเพื่อสร้างตารางแมปสำหรับ client type ของคุณ — หรือยืนยันว่า created_at ของ third-party API ควรกลายเป็น createdAt ใน response model จริง ๆ
การตั้งชื่อคอลัมน์ฐานข้อมูล
เวลาออกแบบตารางใหม่ ชื่อคอลัมน์จะอยู่ต่อไปยาวนานกว่าโค้ดแอปพลิเคชันรุ่นปัจจุบัน การเช็กชื่อที่เสนอในทั้งแปดสไตล์ล่วงหน้าบอกคุณได้ว่าชื่อนั้นอ่านดีทั้งในรูปคอลัมน์ (maximum_retry_attempts), config key (maximum.retry.attempts) และเอกสาร (Title Case) ก่อนที่อะไรจะถูก commit
การตั้งชื่อไฟล์
Frontend component, stylesheet partial และไฟล์เอกสารแต่ละประเภทมีข้อคาดหวังต่างกัน — user-signup-form.tsx กับ UserSignupForm.tsx กับ user_signup_form.spec.ts แปลง concept หนึ่งครั้งแล้วใช้ผลลัพธ์เป็นชื่อไฟล์ ช่วยให้ import, route และไฟล์ทดสอบสอดคล้องกับชื่อ component ที่มันทดสอบอยู่
เก็บกวาด config key
โปรเจกต์อายุยาวมักสะสม config key แบบสามสี่ convention — maxRetryCount, max_retry_count, MAXRETRYCOUNT — ตามยุคและคนที่เพิ่มเข้ามา การทำ cleanup ง่ายขึ้นมากเมื่อทุก key เก่าแยกเป็นคำแล้วเรนเดอร์ใหม่เป็น convention เดียวที่ config loader ของคุณคาดหวัง
แนวปฏิบัติที่ดี
- เลือก convention รายชั้น แล้วจดไว้ เขียนแผนที่ลงเอกสาร — camelCase สำหรับ client, snake_case สำหรับฐานข้อมูล, kebab-case สำหรับไฟล์ — และถือว่าผลลัพธ์จากเครื่องมือคือการสะกดแบบ canonical เวลาหลายชั้นมาบรรจบกัน
- ทำให้อัตโนมัติเท่าที่ทำได้ linter และ formatter จับ violation ในไฟล์โค้ดได้ แต่มองไม่เห็น migration, เอกสาร หรือตาราง route ใช้ตัวแปลงกับทุกอย่างที่ linter ไม่ถึง
- ใช้ acronym ให้สม่ำเสมอ ตัดสินใจครั้งเดียวว่า ID, URL และ HTTP เป็นคำ (idNumber, xmlParser) หรือคงรูป acronym (IDNumber) แล้วใช้กฎเดียวกันทุกที่ที่ identifier นั้นปรากฏ
- แปลงจากแหล่งที่ชัดที่สุด ถ้าคุณมีคอลัมน์แบบ snake_case ในฐานข้อมูล ให้เริ่มจากตรงนั้น — ขอบเขตคำของมันไม่กำกวม parse จึงถูกต้องแน่นอน
- เช็กชื่อที่มีตัวเลขให้ดี กับอะไรอย่าง sha256Hash ให้ยืนยัน segment ที่แยกได้ก่อนคัดลอก ความผิดพลาดตรงนี้มองไม่เห็นจนกลายเป็น key mismatch
- เลือกความอ่านง่ายมากกว่าความเท่ เมื่อสอง convention ใช้ได้ทั้งคู่ในชั้นนั้น ให้เลือกรูปที่อ่านออกเสียงแล้วลื่นกว่า — คุณจะต้องเรียกชื่อพวกนี้ในที่ประชุมไปอีกหลายปี
พร้อมมาตรฐานนิยมการตั้งชื่อแล้วหรือยัง?
เปิด Case Style Converter วาง identifier ที่คุณกำลังจ้องอยู่ แล้วคัดลอกรูปแบบที่แต่ละชั้นต้องการ ฟรี ทันที และทำงานฝั่ง client 100% — บุ๊กมาร์กไว้ข้าง config ของ linter แล้วให้แผนที่ convention ใน README ของคุณกลับมาตรงกับโค้ดจริงสักที
เครื่องมืออื่น ๆ ที่น่าสนใจ:
- Text Case Converter — แปลงข้อความทั้งบล็อกระหว่างตัวพิมพ์ใหญ่ ตัวพิมพ์เล็ก Title Case Sentence Case และอื่น ๆ
- Git Branch Name Generator — เปลี่ยน ticket และคำอธิบายเป็นชื่อ branch แบบ kebab-case ที่ทีมอ่านรู้เรื่อง
- JSON Formatter — จัดรูป ตรวจสอบ และไล่ดู payload ของ API ที่คุณกำลังแปลงชื่อ field อยู่
เขียนโดยทีม Online Tools Forge — สร้าง developer tools ที่เร็ว ฟรี เน้นความเป็นส่วนตัว และทำงานทั้งหมดในเบราว์เซอร์ของคุณ
คำถามที่พบบ่อย
ถ: Case Style Converter รับ input แบบไหนได้บ้าง?
ตอบ: ใช้ได้ทั้งแปด convention ที่มันปล่อยออกเป็น output — camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE, dot.case, Title Case หรือ Train-Case — รวมถึงรูปแบบผสมที่มีทั้งเครื่องหมายคั่นและตัวพิมพ์ใหญ่ปนกันอยู่แล้ว
ถ: เครื่องมือตัดสินใจแยก identifier อย่าง XMLParser ตรงไหนอย่างไร?
ตอบ: มันใช้กฎที่แน่นอน กลุ่มตัวพิมพ์ใหญ่ที่เป็น acronym จะถูกแยกออกเป็นหน่วยก่อนคำที่ขึ้นต้นด้วยตัวใหญ่ และชุดตัวเลขกลายเป็น segment ของตัวเอง XMLParser กลายเป็น xml กับ parser ส่วน base64Encoder กลายเป็น base, 64 และ encoder
ถ: identifier หรือโค้ดของฉันถูกส่งไป server ไหม?
ตอบ: ไม่ parsing และ conversion ทั้งหมดทำงานในเบราว์เซอร์ของคุณด้วย JavaScript ไม่มีการอัปโหลด บันทึก หรือจัดเก็บ จึงใช้กับ identifier จาก codebase ส่วนตัวหรือที่ยังไม่เปิดเผยได้อย่างปลอดภัย
ถ: แปลง JSON object ทั้งก้อนหรือ field หลายตัวพร้อมกันได้ไหม?
ตอบ: เครื่องมือนี้ออกแบบมาสำหรับ identifier ละหนึ่งตัวเพื่อให้ตัวอย่างการแยกคำแม่นยำ สำหรับ payload ชุดใหญ่ ให้จับคู่กับ JSON formatter แล้ววาง field ทีละตัวเพื่อสร้างตารางแมป
ถ: ทำไม kebab-case ถึงสำคัญกับ URL และไฟล์ ทั้งที่โค้ดใช้ camelCase?
ตอบ: kebab-case เลี่ยงอักขระพิเศษที่ต้อง escape ใน URL อ่านไม่กำกวมใน file path และเป็น convention หลักของ CSS class, slug และชื่อแพ็กเกจ — โปรเจกต์ส่วนใหญ่จึงเก็บไว้กับทุกอย่างที่ออกจาก code editor