Chi Square Calculator: ทดสอบ Goodness of Fit และ Independence ในเบราว์เซอร์
รัน chi-square goodness-of-fit และ independence test (contingency table) ในเบราว์เซอร์ — เครื่องมือ Chi Square Calculator คำนวณ χ² statistic, p-value, degrees of freedom, critical value, standardized residuals และ Cramér's V ให้ครบในคลิกเดียว
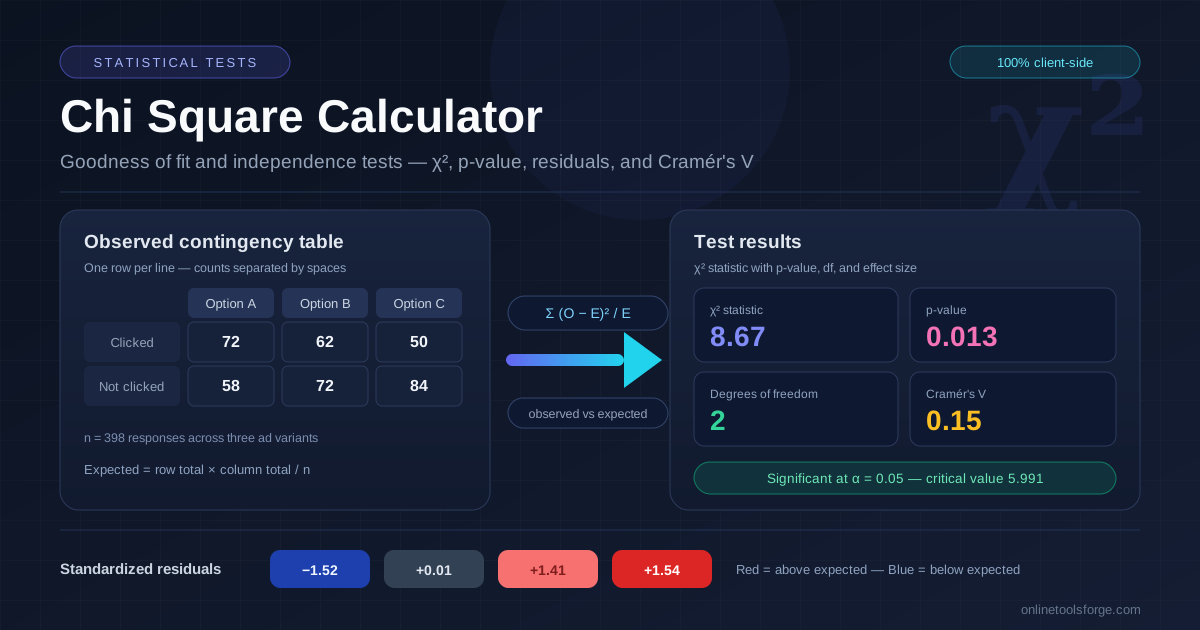
Table of Contents
Chi Square Calculator: ทดสอบ Goodness of Fit และ Independence ในเบราว์เซอร์
คำถามในงานวิเคราะห์ข้อมูลไม่ได้มีแต่เรื่องค่าเฉลี่ย ข้อมูลจำนวนมากที่คุณจัดการเป็นข้อมูลเชิงหมวดหมู่ (categorical data) เช่น จำนวนคลิกเทียบกับการแสดงผล, ตอบใช่เทียบกับตอบไม่, การเลือกแบรนด์หนึ่งแทนอีกแบรนด์ หรือผ่านเทียบกับตก การเทียบค่าเฉลี่ยไม่ใช่เลนส์ที่เหมาะกับข้อมูลนับประเภทนี้ — ข้อมูลเชิงหมวดหมู่ต้องใช้ hypothesis test ของตัวเอง นั่นคือ chi-square Chi Square Calculator รันทั้งสองรูปแบบหลัก คือ goodness-of-fit test และ test of independence ได้ในเบราว์เซอร์โดยตรง ไม่ต้องสมัครสมาชิก ไม่ต้องเขียนสูตรในสเปรดชีต และข้อมูลไม่ออกจากเครื่องของคุณ
เพียงวาง observed counts ที่มีอยู่ เครื่องมือจะคืนค่า χ² statistic, p-value, degrees of freedom, critical value ตามระดับนัยสำคัญที่เลือก, standardized residuals ที่ชี้ว่าเซลล์ไหนเบี่ยงเบนมากที่สุด และ Cramér's V สำหรับวัดขนาดของ effect บทความนี้จะอธิบายว่าควรใช้ test แบบไหนเมื่อไหร่ คณิตศาสตร์เบื้องหลังทำงานอย่างไรในภาษาคน และวิธีอ่านทุกตัวเลขที่เครื่องมือรายงาน
Why Use Chi Square Calculator?
- สอง test ในเครื่องมือเดียว — สลับระหว่าง goodness of fit (ตัวแปรเชิงหมวดหมู่หนึ่งตัวเทียบกับ distribution ที่คาดหวัง) กับ independence (สองตัวแปรใน contingency table) ได้โดยไม่ต้องเปลี่ยนเครื่องมือ
- ให้มากกว่าคำตัดสิน — นอกจาก p-value ยังมี critical value, standardized residuals และ Cramér's V ช่วยให้คุณอธิบายผลลัพธ์ได้ ไม่ใช่แค่รายงานว่าผ่านหรือไม่ผ่าน
- เลือก alpha เองได้ — ตั้งระดับนัยสำคัญเป็น 0.01, 0.05 หรือ 0.1 แล้วข้อสรุปจะอัปเดตตาม χ² distribution ที่ตรงกัน
- วาง input แบบที่มีอยู่แล้ว — วาง counts บรรทัดละหนึ่งแถว คั่นด้วยช่องว่าง และตั้ง expected proportions สำหรับ goodness-of-fit test ได้ถ้าต้องการ
- ตรวจสอบความถูกต้องในตัว — เตือนเมื่อ expected counts ต่ำกว่า 5, ตารางแถวไม่เท่ากัน หรือมีแถว/คอลัมน์ที่ผลรวมเป็นศูนย์ ก่อนที่ปัญหาเหล่านี้จะบิดเบือนผลลัพธ์โดยที่คุณไม่รู้ตัว
- เป็นส่วนตัวตั้งแต่การออกแบบ — ทุกการคำนวณทำงานฝั่งไคลเอนต์ด้วย JavaScript ไม่มีการอัปโหลด จัดเก็บ หรือบันทึกข้อมูลใด ๆ
Key Features
| ผลลัพธ์ | บอกอะไรกับคุณ |
|---|---|
| χ² statistic | รวมส่วนต่างกำลังสองระหว่าง observed กับ expected counts |
| p-value | โอกาสที่จะเจอส่วนต่างใหญ่ขนาดนี้ ถ้า null hypothesis เป็นจริง |
| Degrees of freedom | χ² distribution แบบไหนที่ใช้ตัดสิน statistic ของคุณ |
| Critical value | เกณฑ์ที่ χ² ต้องผ่านจึงจะ reject ที่ระดับ alpha ที่เลือก |
| Standardized residuals | เซลล์ใดบ้างที่ขับเคลื่อนผลลัพธ์โดยรวม |
| Cramér's V | Effect size สำหรับ independence test จาก 0 (ไม่สัมพันธ์) ไปหา 1 (สัมพันธ์สมบูรณ์) |
รายละเอียดที่น่ารู้เพิ่มเติม:
- โหมด goodness-of-fit รับ weights เพิ่มเติมได้ จึงทดสอบกับ theoretical distribution ใด ๆ ได้ ไม่ใช่แค่ uniform
- บรรทัดข้อสรุปสรุปการตัดสินใจตรง ๆ — มีนัยสำคัญหรือไม่ ที่ระดับ alpha ที่คุณเลือก — สะดวกมากเวลานำผลไปใส่รายงาน
- input ที่ผิดปกติ (แถวไม่เท่ากัน, margin เป็นศูนย์ทั้งหมด) จะถูกจับด้วยข้อความเฉพาะเจาะจง ไม่ใช่การคำนวณที่พังเงียบ ๆ
How to Use
- เลือกประเภท test — เลือก goodness of fit สำหรับตัวแปรเชิงหมวดหมู่หนึ่งตัว หรือ independence สำหรับ contingency table ของสองตัวแปร
- ใส่ observed counts — สำหรับ goodness of fit ให้ใส่ count ของแต่ละหมวด สำหรับ independence ให้วางตารางบรรทัดละหนึ่งแถว คั่น counts ด้วยช่องว่าง และตั้ง expected proportions หรือ weights ได้ถ้าต้องการ
- เลือกระดับนัยสำคัญ — ค่าเริ่มต้นคือ alpha 0.05 ใช้ 0.01 เมื่อต้องการเกณฑ์เข้ม หรือ 0.1 สำหรับงานสำรวจเบื้องต้น
- รัน test — χ² statistic, degrees of freedom, p-value และ critical value จะปรากฏทันที พร้อมข้อสรุปภาษาง่าย ๆ
- อ่านค่าวิเคราะห์เพิ่มเติม — ดู standardized residuals เพื่อหาเซลล์สำคัญ ดู Cramér's V เพื่อวัด effect size และใส่ใจคำเตือนเรื่อง expected count ต่ำ
Goodness of Fit กับ Independence ต่างกันอย่างไร
สองคำถาม สถิติเดียวกัน
ทั้งสอง test ใช้กลไก χ² เหมือนกัน แต่ตอบคนละคำถาม goodness of fit ถามว่า distribution ของตัวแปรเชิงหมวดหมู่หนึ่งตัวตรงกับความคาดหวังหรือไม่ เช่น หมวด support ticket สี่หมวดน่าจะเกิดเท่า ๆ กันหรือไม่ หรือลูกเต๋าควรออกแต่ละหน้าหนึ่งในหกของเวลา ส่วน independence ถามว่าตัวแปรเชิงหมวดหมู่สองตัวมีความสัมพันธ์กันหรือไม่ เช่น ประเภทอุปกรณ์มีอิทธิพลต่อการเลือกแพ็กเกจหรือไม่ หรือช่วงอายุเป็นอิสระจากความชอบสินค้าหรือไม่
Observed เทียบกับ Expected counts
ทุก chi-square test เทียบ observed count (O) ในแต่ละเซลล์กับ expected count (E) สำหรับ goodness of fit ค่า E คือ n คูณ expected proportion ของหมวดนั้น สำหรับ independence ค่า E ของเซลล์หนึ่งคือผลรวมแถวคูณผลรวมคอลัมน์หารด้วยผลรวมทั้งหมด — นับเป็นจำนวนที่ควรเกิดถ้าสองตัวแปรไม่เกี่ยวข้องกัน จากนั้นสถิติจะรวม (O − E)² / E ของทุกเซลล์: การยกกำลังสองป้องกันส่วนเกินและส่วนขาดจากการหักล้างกัน และการหารด้วย E ทำให้เซลล์เล็กและใหญ่อยู่บนฐานเดียวกัน ขาดไป 10 จากที่คาด 15 จึงหนักกว่าขาดไป 10 จากที่คาด 1,000 มาก
Degrees of freedom
Degrees of freedom บอกรูปร่างของตาราง: จำนวนหมวดลบหนึ่งสำหรับ goodness of fit และ (แถว − 1) × (คอลัมน์ − 1) สำหรับ independence ค่านี้เลือก χ² distribution ที่ใช้อ้างอิง นั่นคือเหตุผลที่ χ² เท่ากับ 8 ไม่น่าตื่นเต้นเมื่อ df = 5 แต่ชี้ขาดเมื่อ df = 1
Standardized residuals: เซลล์ไหนขับเคลื่อนผลลัพธ์
χ² ที่มีนัยสำคัญบอกว่ามีบางอย่างแตกต่าง แต่ไม่บอกว่าอะไรแตกต่าง standardized residual ของแต่ละเซลล์ คือ (O − E) / √E ตอบคำถามต่อยอดนี้: ค่าที่เกินราว ±2 คือเซลล์ที่มีส่วนร่วมกับสถิติมากที่สุด ถ้าทดสอบครีเอทีฟโฆษณาสามแบบแล้วผลรวมมีนัยสำคัญ แต่แบบหนึ่งมี residual ที่ +1.9 ขณะที่แบบอื่นอยู่ใกล้ศูนย์ แปลว่าคุณเจอตัวที่ทำผลงานเกินคาดแล้ว ไม่ใช่แค่คำตัดสินรวม ๆ
Cramér's V: ความสัมพันธ์แข็งแรงแค่ไหน
เมื่อ sample ใหญ่ ส่วนต่างเล็กน้อยก็กลายเป็น significant ได้ Cramér's V ที่รายงานใน independence test ปรับสเกล χ² ให้วิ่งจาก 0 (ไม่สัมพันธ์) ไปหา 1 (สัมพันธ์สมบูรณ์): ราว 0.1 ถือว่าเล็ก, 0.3 ปานกลาง และ 0.5 ขึ้นไปแข็งแรงสำหรับตาราง 2 × 2 การรายงานค่านี้คู่กับ p-value ช่วยให้พาดหัวข่าวของคุณซื่อสัตย์
ตัวอย่างคำนวณตาราง 2 × 2
สมมติ A/B test ส่งผู้เข้าชม 200 คนเข้า landing page สองแบบ หน้าเก่า 48 คน convert และ 152 คนไม่ convert หน้าใหม่ 74 คน convert และ 126 คนไม่ convert ผลรวมคอลัมน์ได้ผู้ convert 122 คนและไม่ convert 278 คน ดังนั้นที่ n = 400 ทุก expected count เท่ากับ 200 × 122 / 400 = 61 สำหรับผู้ convert และ 139 สำหรับคนที่ไม่ convert จากนั้น χ² = (48−61)²/61 + (152−139)²/139 + (74−61)²/61 + (126−139)²/139 ≈ 2.77 + 1.22 + 2.77 + 1.22 = 7.97 ที่ df = (2−1)(2−1) = 1 critical value ที่ α = 0.05 คือ 3.841 และ p-value อยู่ราว 0.005: หน้าใหม่ convert ได้ดีกว่าจริง แต่สังเกตว่า Cramér's V ≈ 0.14 — เป็น lift ที่จริงแต่ยังปานกลาง ซึ่งสำคัญถ้าการออกแบบใหม่มีต้นทุนต่อเนื่อง
ข้อควรระวังเรื่อง count น้อย
χ² distribution เป็นการ approximation และมันเริ่มเพี้ยนเมื่อ expected counts น้อย กฎทั่วไปคือ expected count ทุกเซลล์ควรอย่างน้อย 5 (เวอร์ชันหลวมกว่ายอมให้เซลล์ไม่เกิน 20% อยู่ระหว่าง 1 ถึง 5) เครื่องมือจะเตือนเมื่อละเมิด เพื่อให้คุณรวมหมวดที่ sparse หรือเก็บข้อมูลเพิ่มก่อนสรุปอะไร สำหรับตาราง 2 × 2 ที่ count น้อยมาก ทางเลือกคลาสสิกคือ Fisher's exact test
Practical Use Cases
แบบสำรวจและวิจัยตลาด
ทดสอบว่า distribution ของคำตอบ (พึงพอใจ, เฉย ๆ, ไม่พึงพอใจ) ตรงกับ benchmark หรือไม่ หรือทัศนคติเป็นอิสระจากข้อมูลประชากรศาสตร์ เช่น ช่วงอายุหรือภูมิภาคหรือไม่ contingency table ของแถวกับคอลัมน์สรุปคำถามทั้งหมดได้ใน test เดียว
A/B test ที่ผลลัพธ์เป็นเชิงหมวดหมู่
Conversion, การสมัครสมาชิก, หมวด bounce และการเลือกแพ็กเกจล้วนเป็น count ไม่ใช่ค่าเฉลี่ย วาง variants เป็นแถวและผลลัพธ์เป็นคอลัมน์ independence test จะบอกว่าส่วนต่างที่เห็นเป็น signal หรือ noise ตัวอย่างคำนวณด้านบนก็คือ pattern นี้เป๊ะ ๆ
ตรวจสอบลูกเต๋า, RNG และความยุติธรรม
ทอยลูกเต๋า 600 ครั้ง ลูกที่ยุติธรรมควรออกแต่ละหน้าราว 100 ครั้ง — เป็น goodness-of-fit test แบบตำราเรียนเทียบกับ uniform expectation การตรวจแบบเดียวกันใช้กับ random number generator, loot table ที่มีน้ำหนัก, การกระจายงานของ load balancer หรือระบบใด ๆ ที่อ้างว่าเป็นธรรม
เปรียบเทียบข้อมูลประชากรและการปฏิบัติงาน
แพ็กเกจสมัครสมาชิกต่างกันตามประเทศหรือไม่ defect ต่างกันตามโรงงานหรือกะการทำงานหรือไม่ ทุกครั้งที่สองปัจจัยเชิงหมวดหมู่มาบรรจบกันในตาราง chi-square คือคำตอบที่เร็วและตรงไปตรงมาที่สุด — และ residuals จะชี้ไปที่ segment ที่ควรดูใกล้ ๆ
Best Practices
- เช็ก expected counts ก่อนเชื่อคำตัดสิน — ถ้า expected count ใดต่ำกว่า 5 ให้รวมหมวดหมู่หรือเก็บข้อมูลเพิ่มก่อน
- รายงาน residuals ไม่ใช่แค่คำตัดสิน — p-value ที่มีนัยสำคัญโดยไม่มี residuals ซ่อนว่า effect อยู่ที่ไหน เริ่มจากเซลล์ที่เบี่ยงเบน
- คู่ significance กับ effect size — อ้างอิง Cramér's V คู่กับ p-value เพื่อให้ผู้อ่านรู้ว่าความสัมพันธ์คุ้มที่จะลงมือหรือไม่
- ใส่ raw counts ไม่ใช่ percentages — การคำนวณขึ้นกับขนาดตัวอย่าง สัดส่วนทิ้งตัวส่วน (denominator) ที่ test ต้องใช้
- รักษาความเป็นอิสระของ observations — แต่ละ subject ควรอยู่ในเซลล์เดียว ข้อมูลวัดซ้ำต้องใช้วิธีอื่น
- วางแผนขนาดตัวอย่างก่อนทดสอบ — chi-square test บนตารางเล็กมักขาด power กำหนดขนาด study ตั้งแต่ต้น
พร้อมทดสอบข้อมูลหมวดหมู่ของคุณหรือยัง?
ถ้าคุณมี counts รออยู่ในสเปรดชีต คุณห่างจากคำตอบเพียงการวางข้อมูลหนึ่งครั้ง เปิด Chi Square Calculator วางตารางของคุณ เลือก alpha แล้วรับ χ² statistic, p-value, residuals และ effect size ในไม่กี่วินาที — ฟรี เป็นส่วนตัว และทำงานในเบราว์เซอร์ของคุณ
Related Tools You Might Like:
- T-Test Calculator — เทียบค่าเฉลี่ยของข้อมูลต่อเนื่อง ซึ่งเป็นเดิมพันอีกฝั่งของ categorical test
- Statistics Calculator — คำนวณ descriptive statistics และสำรวจข้อมูลก่อนลงมือ hypothesis testing
- Sample Size Calculator — วางแผนว่า test ของคุณต้องใช้ observations กี่ตัวอย่างก่อนเก็บข้อมูล
ขอให้ residuals ของคุณเล็กและ insight ของคุณคมกริบ
คำถามที่พบบ่อย
ถ: ควรใช้ chi-square test เมื่อไหร่ แทนที่จะใช้ t-test?
ตอบ: ใช้ chi-square เมื่อข้อมูลเป็น count ในหมวดหมู่ เช่น ผลลัพธ์ใช่/ไม่ใช่ การเลือก หรือการเป็นสมาชิกกลุ่ม ส่วน t-test ใช้เทียบค่าเฉลี่ยของข้อมูลต่อเนื่อง เช่น เวลา น้ำหนัก หรือคะแนน
ถ: p-value ที่เห็นในเครื่องมือแปลว่าอะไรกันแน่?
ตอบ: คือความน่าจะเป็นที่จะเห็น χ² statistic ใหญ่อย่างน้อยเท่านี้ ถ้า null hypothesis (ไม่ต่างจากความคาดหวัง หรือไม่มีความสัมพันธ์) เป็นจริง p-value เลขต่ำแปลว่า counts ของคุณจะน่าประหลาดใจมากภายใต้สมมติฐานนั้น
ถ: ทำไม expected count ต่ำกว่า 5 ถึงเป็นปัญหา?
ตอบ: เพราะ p-value อาศัย χ² approximation ที่ไม่แม่นเมื่อเซลล์ sparse ผลอาจดูมีหรือไม่มีนัยสำคัญไปโดยบังเอิญ ควรรวมหมวดที่ sparse หรือเก็บข้อมูลเพิ่ม และให้สังเกตคำเตือนของเครื่องมือ
ถ: วิเคราะห์ตารางที่ใหญ่กว่า 2 × 2 ได้ไหม?
ตอบ: ได้ วางตารางได้ทุกขนาดเท่าที่แถวมีความยาวสม่ำเสมอ degrees of freedom จะคำนวณเป็น (แถว − 1) × (คอลัมน์ − 1) อัตโนมัติ พร้อม residuals และ Cramér's V ของทุกเซลล์
ถ: ข้อมูลของฉันถูกส่งไปเซิร์ฟเวอร์หรือไม่?
ตอบ: ไม่ การคำนวณทั้งหมดทำงานฝั่งไคลเอนต์ในเบราว์เซอร์ contingency table ของคุณไม่เคยออกจากอุปกรณ์