Email Obfuscator: ซ่อนอีเมลจาก spam bot โดยไม่ซ่อนจากผู้ใช้
แปลงอีเมลให้เป็นรูปแบบที่ spam bot จับไม่ได้ ทั้ง HTML entity, สคริปต์ ROT13 document.write และข้อความ [at]/[dot] ที่มนุษย์อ่านได้ พร้อม snippet คัดลอกวาง ทำงานฝั่ง client 100%
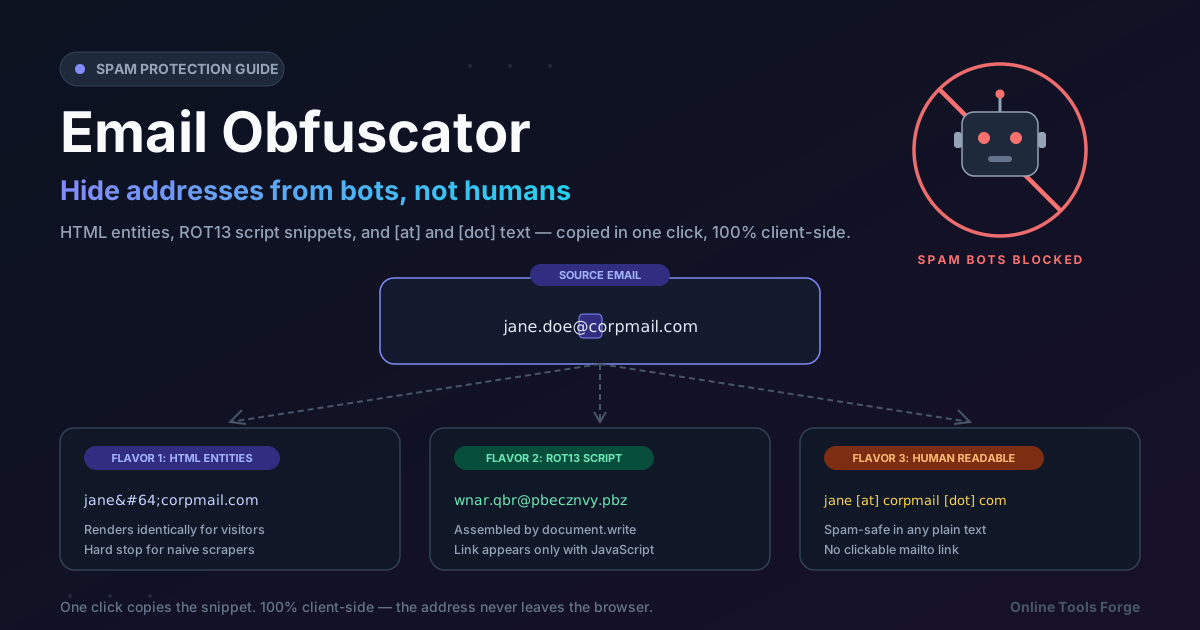
Table of Contents
Email Obfuscator: ซ่อนอีเมลจาก spam bot โดยไม่ซ่อนจากผู้ใช้
พอเผยแพร่ที่อยู่อีเมลเป็นข้อความธรรมดา นาฬิกาก็เริ่มเดิน crawler ที่เก็บข้อมูลจะดึงทุกอย่างที่มีรูปร่างคล้าย [email protected] และส่งเข้าลิสต์ส่งเมลขยะภายในไม่กี่วัน กล่องจดหมายที่เงียบสนิทในวันจันทร์ เริ่มรับข้อเสนอที่ไม่ได้ขอและข้อความหลอกลวงในสัปดาห์ถัดมา และเมื่อที่อยู่ตกไปอยู่ในลิสต์ที่ถูกขายต่อไปเรื่อย ๆ แล้ว ก็ไม่มีลิงก์ยกเลิกใดนำมันกลับคืนมาได้
ลิงก์ mailto: ธรรมดาคือจุดเสี่ยงที่สุด เพราะ scraper แค่จับรูปแบบใน markup ของคุณแล้วผ่านไป ทางแก้คือการ obfuscate — เขียนที่อยู่ใหม่ให้มนุษย์ยังอ่านหรือประกอบกลับได้ แต่การจับรูปแบบอัตโนมัติหาอะไรไม่เจอ Email Obfuscator สร้างรูปแบบดังกล่าวสามแบบในครั้งเดียว — HTML entity encoding, สคริปต์ ROT13 document.write และข้อความ [at]/[dot] ที่มนุษย์อ่านได้ — พร้อม snippet คัดลอกวางคลิกเดียว และทุกอย่างทำงานในเบราว์เซอร์ของคุณ
ทำไมต้องใช้ Email Obfuscator?
- หยุดตัวเก็บเกี่ยวระดับพื้นฐาน: งาน scrape ส่วนใหญ่คือ regex บน HTML ดิบ การเข้ารหัสที่อยู่ทำให้รูปแบบ @ และจุดตรง ๆ ไม่ปรากฏในซอร์สโค้ดเลย
- หน้าเว็บยังอ่านง่ายเหมือนเดิมสำหรับคน: เบราว์เซอร์ถอดรหัส HTML entity ให้อัตโนมัติ ผู้ใช้จึงเห็นที่อยู่ปกติคลิกได้ แม้โค้ดข้างใต้ถูกเข้ารหัสไว้
- ปกป้อง static site โดยไม่ต้องมี backend: snippet ชิ้นเดียววางได้ทั้ง GitHub Pages, เว็บ portfolio หรือ CMS ใดก็ตามที่รับ HTML ดิบ
- เลือก trade-off ให้ตรงบริบท: สามรูปแบบครอบคลุมทั้งการเรนเดอร์เหมือนต้นฉบับเป๊ะ การซ่อนด้วยสคริปต์ และข้อความธรรมดาที่รอดทุกสื่อ
- เป็นส่วนตัวตั้งแต่ต้น: เครื่องมือทำงาน client-side 100% ที่อยู่ไม่เคยออกจากเครื่อง — สำคัญมากเมื่อตัวที่อยู่นั่นแหละคือข้อมูลอ่อนไหว
คุณสมบัติเด่น
| คุณสมบัติ | ทำอะไร | ทำไมจึงสำคัญ |
|---|---|---|
| HTML entity encoding | เขียนทุกตัวอักษรใหม่เป็น numeric entity แบบทศนิยมหรือ hex | ไม่มีรูปแบบอีเมลตรง ๆ ใน markup แต่หน้าตาเหมือนเดิม |
| ROT13 พร้อมสคริปต์ | เข้ารหัส anchor tag ทั้งแท็กแล้วสร้างใหม่ด้วย document.write | scraper ที่อ่านแค่ซอร์สไม่เห็นแม้แต่โครงสร้างแท็ก |
| ข้อความอ่านได้ | แปลงเป็น name [at] domain [dot] tld | ใช้ได้ในบริบท plain text ที่ markup เข้าไม่ได้ |
| ข้อความแสดงแบบกำหนดเอง | แสดง label ที่สวยงามแทนที่อยู่ดิบ | หน้าเว็บสะอาดขณะที่ mailto target ยังถูกต้อง |
| คัดลอก snippet คลิกเดียว | ทุกรูปแบบพร้อมวางทันที | ไม่ต้องเข้ารหัสมือ ไม่มี syntax error |
| ทำงานฝั่ง client | เข้ารหัสทั้งหมดในเบราว์เซอร์ | ที่อยู่ไม่ผ่านเซิร์ฟเวอร์ใดเลย |
- ตรวจสอบทันที: ตรวจรูปแบบที่อยู่ระหว่างพิมพ์ แจ้งเตือนก่อนสร้างผลลัพธ์
- entity สองแบบ: เลือก entity แบบทศนิยมหรือเลขฐานสิบหกตามธรรมเนียมของโค้ดคุณ
วิธีใช้งาน
- เปิดเครื่องมือ: เข้า Email Obfuscator ในเบราว์เซอร์ ไม่ต้องสมัคร ไม่ต้องติดตั้ง
- กรอกที่อยู่อีเมล: พิมพ์ที่อยู่ที่ต้องการปกป้อง เครื่องมือจะตรวจรูปแบบก่อนสร้างผลลัพธ์
- ตั้งข้อความแสดง (ถ้าต้องการ): เว้นว่างเพื่อแสดงที่อยู่ตรง ๆ หรือใส่ label อย่าง "ฝ่ายสนับสนุน" เพื่อให้ข้อความที่มองเห็นสะอาดตา
- เลือกรูปแบบ: เลือก entity แบบทศนิยมหรือ hex, สคริปต์ ROT13 หรือข้อความ [at]/[dot] ธรรมดา ตามที่ snippet จะถูกวาง
- คัดลอกและวาง: เอา snippet ไปวางใน HTML, README หรือหน้า plain text แล้วทดสอบผลลัพธ์ก่อนเผยแพร่
สามรูปแบบของการซ่อน
ผลลัพธ์สามแบบไม่สามารถใช้แทนกันได้ แต่ละแบบเข้ารหัสคุณสมบัติต่างกันของที่อยู่ และมีจุดอ่อนคนละแบบ จึงควรรู้ว่ากำลังแลกอะไรกัน
HTML entity encoding แทนที่ทุกตัวอักษรของที่อยู่ — รวมถึงลิงก์ mailto: — ด้วย numeric entity สำหรับ [email protected] markup จะกลายเป็นสายอักขระอย่าง jane@... โดย anchor tag ทั้งอันสร้างจากโค้ดลักษณะนี้ เบราว์เซอร์ถอด entity ก่อนเรนเดอร์ หน้าเว็บจึงแสดงที่อยู่ปกติคลิกได้เหมือนต้นฉบับเป๊ะ แต่ในซอร์สโค้ดกลับไม่มีรูปแบบ name@domain ที่ scraper ระดับพื้นฐานใช้จับ นี่คือค่าเริ่มต้นที่ดีที่สุดสำหรับเว็บส่วนใหญ่ — ไม่ใช้ JavaScript ไม่ต่างจากเดิมแม้แต่พิกเซลเดียว
ROT13 พร้อม document.write ไปไกลกว่านั้นด้วยการซ่อน anchor tag ทั้งแท็ก anchor <a href="mailto:..."> ทั้งอันถูกเข้ารหัสด้วย ROT13 — เลื่อนทุกตัวอักษรไปสิบสามตำแหน่ง เปลี่ยน [email protected] เป็น [email protected] — แล้วฝังผลลัพธ์ในสคริปต์เล็ก ๆ เมื่อหน้าโหลด สคริปต์จะถอดรหัสกลับแล้วเขียนลิงก์จริงลงใน DOM scraper ที่อ่านแค่ซอร์สดิบจะไม่เห็นข้อความรูปแบบอีเมลเลย ที่อยู่จึงมีอยู่จริงหลัง JavaScript ทำงานเท่านั้น
ข้อความ [at]/[dot] ที่มนุษย์อ่านได้ เปลี่ยนที่อยู่เป็นร้อยกรอง: jane [at] example [dot] com ไม่มีอะไรถอดรหัสให้อัตโนมัติ — ผู้อ่านต้องประกอบกลับในหัว รูปแบบนี้ใช้ได้ทุกที่: ไฟล์ plain text, PDF, โบรชัวร์ และ README ดิบ ข้อแลกคือการใช้งาน: ไม่มีลิงก์ mailto: ให้คลิก, การคัดลอกวางจะได้ข้อความที่ถูก obfuscate แทนที่อยู่จริง และ screen reader อาจอ่านวงเล็บออกมาตรง ๆ ควรสงวนไว้สำหรับบริบทที่ใช้ markup ไม่ได้
ขีดจำกัดที่ต้องพูดตรง ๆ: เทคนิคเหล่านี้ไม่มีอะไรหยุดผู้ไม่หวังดีที่ตั้งใจจริง scraper ที่เรนเดอร์หน้าเว็บหรือถอดรหัสที่จับได้จะกู้คืนได้ทั้งสามรูปแบบ การ obfuscate เพิ่มต้นทุนของการเก็บเกี่ยวแบบสะดวก ๆ เท่านั้น ไม่ใช่การรักษาความปลอดภัย สำหรับกล่องจดหมายสำคัญ ควรใช้คู่กับ spam filter หรือ contact form และเปลี่ยนที่อยู่ที่รั่วไปแล้ว
กรณีการใช้งานจริง
หน้าติดต่อ
กรณีคลาสสิก ธุรกิจขนาดเล็กอยากมีที่อยู่ที่ติดต่อได้บนหน้าติดต่อ แต่เห็นมันถูกเก็บเกี่ยวภายในหนึ่งสัปดาห์ entity encoding ทำให้หน้าใช้งานได้เหมือนเดิมทุกประการขณะตัดรูปแบบที่ harvester จับ ถ้าเป็นที่อยู่ใน footer ที่ซ้ำทั้งเว็บ เข้ารหัสครั้งเดียวแล้วใช้ snippet ซ้ำได้เลย
รายชื่อทีม
หัวข้อ "ทีมของเรา" มักมีที่อยู่สิบกว่ารายการ ยิ่งคูณความเสี่ยงเข้าไปอีก ใช้ตัวเลือกข้อความแสดงแบบกำหนดเอง: แสดงชื่อแต่ละคนเป็นข้อความลิงก์ ขณะที่ mailto: target ที่เข้ารหัสแล้วจะพาที่อยู่ไป ผู้ใช้ได้รายการสะอาด scraper ไม่ได้อะไรที่อ่านออก
README ของโปรเจกต์ open source
README ของโปรเจกต์ถูกเรนเดอร์เป็น HTML บน forge ส่วนใหญ่ แต่ก็มีอยู่ในรูป plain text ดิบใน mirror และ terminal ด้วย รูปแบบ [at]/[dot] จึงเหมาะที่สุด: อ่านออกในทุกบริบท ไม่ต้องใช้สคริปต์ และเป็นธรรมเนียมยาวนานของวงการ open source
เว็บส่วนตัวและ portfolio
portfolio เป็น static page ที่โฮสต์ไว้หลายปีแทบไม่ได้ดูแล — จุดพอดีที่ที่อยู่รั่วเงียบ ๆ โดยไม่มีใครสังเกต สคริปต์ ROT13 หรือลิงก์ entity-encoded จึงปกป้องมันได้โดยไม่ต้องดูแลอะไรเลย
แนวปฏิบัติที่ดี
- หน้าที่ traffic สูงควรใช้ contact form: หน้าที่ดึง traffic จาก search มากจะดึง scraper ตัวฉลาดมาด้วย form ฝั่งเซิร์ฟเวอร์ที่มี rate limiting ปกป้องได้ดีกว่าการเข้ารหัสฝั่ง client ใด ๆ
- ทดสอบผลลัพธ์ที่เรนเดอร์ก่อนเผยแพร่: โหลดหน้า คลิกลิงก์ แล้วตรวจ mailto target ความผิดพลาดจากการเข้ารหัสมองไม่เห็นในซอร์ส แต่เห็นชัดในเบราว์เซอร์
- ใช้คู่กับการป้องกันฝั่งเซิร์ฟเวอร์: rate limiting และ spam filter เสริมการ obfuscate ได้ สองชั้นนี้จับสิ่งที่อีกชั้นมองข้าม
- จับคู่รูปแบบกับสื่อให้ถูก: entity สำหรับหน้า HTML, ROT13 เมื่ออยากซ่อนทั้งลิงก์, [at]/[dot] สำหรับ plain text
- เปลี่ยนที่อยู่ที่เคยเผยแพร่แล้ว: การ obfuscate ที่อยู่หลังจากมันถูกเปิดเผยเป็นข้อความดิบไปแล้ว จะไม่ลบมันออกจากลิสต์ที่มีอยู่ ออกที่อยู่ใหม่แล้วอัปเดตหน้าเว็บ
- จำไว้ว่านี่คือการต่อต้าน ไม่ใช่ความปลอดภัย: การ obfuscate กรอง harvester ที่มาแบบกาฝาก ให้ถือว่าที่อยู่ใดบนหน้าสาธารณะถูกค้นพบได้ในที่สุด
ปกป้องที่อยู่ โดยไม่ทำให้หน้าเว็บใช้ยาก
กล่องจดหมายเปลี่ยนยากกว่าบรรทัด HTML เสมอ ก่อนเผยแพร่หน้าติดต่อหรือ README หน้าถัดไป เปิด Email Obfuscator วางที่อยู่ เลือกรูปแบบที่เหมาะกับสื่อ แล้วคัดลอก snippet ทำงานทั้งหมดในเบราว์เซอร์และเปลี่ยนการเก็บเกี่ยวที่ง่ายที่สุดบนเว็บให้กลายเป็นทางตัน
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- PII Redactor — ลบอีเมล บัตร และ key ออกจากข้อความก่อนวางหรือแชร์
- QR Generator — แชร์ข้อมูลติดต่อเป็น QR code แทนที่อยู่ที่ scrape ได้
- Text Case Converter — จัดรูปแบบตัวอักษรของ label และข้อความแสดงรอบ snippet
ขอให้เผยแพร่อย่างมั่นใจ และกล่องจดหมายสงบเงียบ!
คำถามที่พบบ่อย
ถ: Email Obfuscator ส่งที่อยู่อีเมลของฉันขึ้นเซิร์ฟเวอร์ไหม?
ตอบ: ไม่ การเข้ารหัสทั้งหมดเกิดขึ้นในเบราว์เซอร์ของคุณ ที่อยู่ไม่เคยออกจากเครื่อง
ถ: ควรใช้รูปแบบไหนบนเว็บไซต์ปกติ?
ตอบ: HTML entity encoding คือค่าเริ่มต้นที่ดีที่สุด เรนเดอร์เหมือนที่อยู่ธรรมดา ไม่ต้องใช้ JavaScript และทำลายรูปแบบที่ harvester ส่วนใหญ่พึ่งพา ใช้ ROT13 เมื่อต้องการซ่อน anchor tag ทั้งแท็กจากผู้อ่านซอร์ส
ถ: อีเมลที่ถูก obfuscate ยังใช้งานได้กับ screen reader ไหม?
ตอบ: ลิงก์แบบ entity และ ROT13 ใช้ได้ เพราะเบราว์เซอร์ถอดรหัสเป็นลิงก์ปกติก่อนที่เทคโนโลยีช่วยอ่านจะอ่านหน้านั้น ส่วนข้อความ [at]/[dot] ไม่ได้ — screen reader อาจอ่านวงเล็บออกมาตรง ๆ
ถ: การ obfuscate ช่วยหน่วงสแปมได้จริงแค่ไหน?
ตอบ: มันหยุด crawler ตัวถูกที่จับรูปแบบได้ทันที แต่ harvester ตัวจริงจังที่เรนเดอร์หน้าหรือถอดรหัสจะกู้คืนที่อยู่ได้ ถือเป็นการเพิ่มกำแพงให้สูงขึ้น ไม่ใช่การสร้างปราสาท
ถ: obfuscate หลายที่อยู่พร้อมกันได้ไหม?
ตอบ: เครื่องมือรับทีละที่อยู่ สำหรับรายชื่อทีม ให้สร้าง snippet รายที่อยู่แล้ววางรวมกันในหน้าเว็บ