GROQ Playground: ฝึกเขียนและทดสอบ query ของ Sanity ออนไลน์ได้ในไม่กี่วินาที
GROQ Playground เครื่องมือฟรีสำหรับฝึกใช้ GROQ ภาษา query ของ Sanity — วาง JSON เขียน query แล้วดูผลลัพธ์ที่จัดรูปแบบแล้วได้ทันทีในเบราว์เซอร์
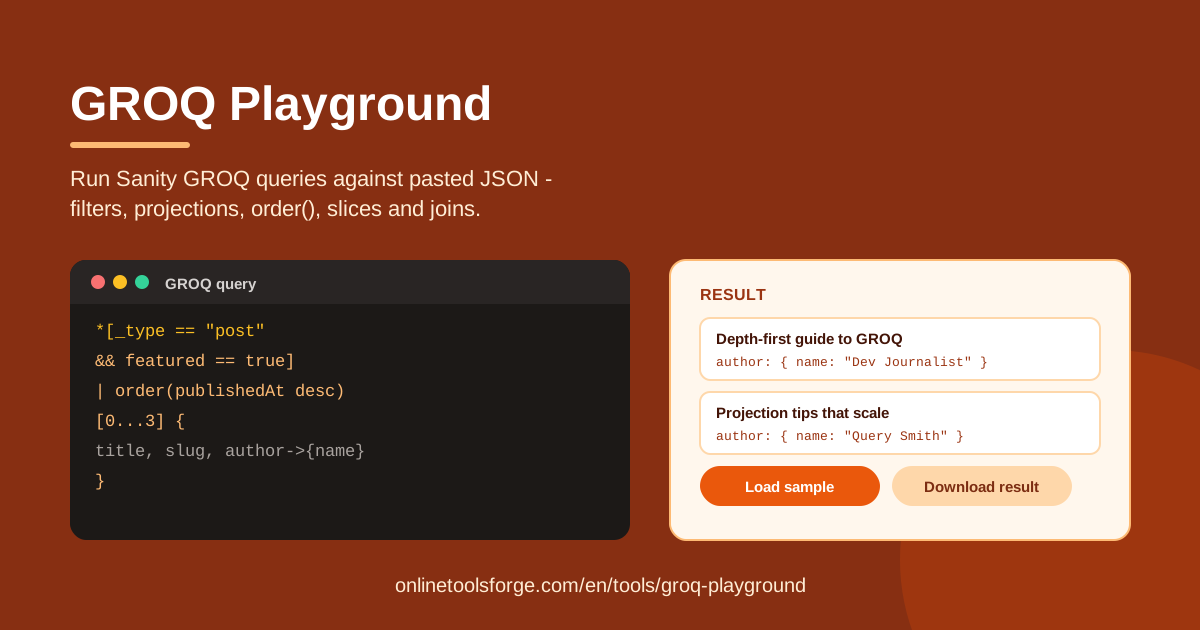
Table of Contents
ถ้าคุณทำเว็บหรือแอปที่ใช้ Sanity GROQ ย่อมาจาก Graph-Relational Object Queries คือภาษา query ที่ใช้ดึงเนื้อหาออกจาก dataset ภาษานี้กระชับและทรงพลัง แต่วิธีเรียนรู้ที่ได้ผลจริงที่สุดคือการลองรัน query แล้วดูว่าผลลัพธ์ออกมาหน้าตาเป็นอย่างไร GROQ Playground ช่วยให้คุณได้วงจร feedback แบบนี้ภายในแท็บเดียวในเบราว์เซอร์ เพียงวางชุดข้อมูล JSON ลงไป เขียน query แล้วผลลัพธ์ที่จัดรูปแบบเรียบร้อยจะปรากฏขึ้นทันที ไม่ต้องมีโปรเจกต์ Sanity ไม่ต้องมี API key และไม่ต้องสมัครบัญชีใด ๆ
เนื่องจากทุก query ทำงานฝั่ง client 100% เครื่องมือนี้จึงเป็นพื้นที่ทดลองที่ปลอดภัยสำหรับข้อมูลจริงด้วย คุณวางข้อมูลที่ export มาจาก production ไฟล์ fixture สำหรับเทส หรือตัวอย่างจากเอกสารของ Sanity ลงไปได้ โดยข้อมูลไม่ถูกอัปโหลดไปที่ใดเลย หากยังไม่มีชุดข้อมูลของตัวเอง ปุ่ม Load sample จะใส่ข้อมูลตัวอย่างให้ทันที เริ่มทดลองได้ทันทีโดยไม่ต้องเตรียมอะไรเพิ่ม
บทความนี้จะพาไปดูว่าเครื่องมือนี้ทำอะไรได้บ้าง ขั้นตอนการใช้งาน 5 ขั้นตอน พื้นฐาน GROQ ที่ควรรู้ และตัวอย่างการนำไปใช้ในงานจริง
ทำไมต้องใช้ GROQ Playground?
- ไม่ต้องติดตั้งอะไรเลย เปิดหน้าเว็บแล้วเริ่มเขียน query ได้ทันที ไม่ต้องใช้ CLI ไม่ต้องสร้างโปรเจกต์ ไม่ต้องสมัครสมาชิก
- เห็นผลลัพธ์ทันที ผลลัพธ์แสดงในแผงที่จัดรูปแบบแล้วทันทีที่รัน query ทำให้ปรับแก้ได้ภายในไม่กี่วินาที ไม่ต้องรีสตาร์ต dev server
- ปลอดภัยกับข้อมูลจริง ทุกอย่างทำงานในเบราว์เซอร์ของคุณ ข้อมูลไม่ออกจากเครื่อง จึงวางข้อมูลจาก production ลงไปได้อย่างมั่นใจ
- ข้อความ error ชัดเจน ถ้า syntax ผิด เครื่องมือจะบอกอย่างตรงไปตรงมา และถ้าไม่มีเอกสารตรงเงื่อนไข ก็จะแจ้งว่า query matched no documents แทนที่จะเจอหน้าจอว่าง ๆ ที่งงตามั่ว
- ผลลัพธ์นำไปใช้ต่อได้ กด Download เพื่อบันทึกผลลัพธ์ไปใช้เขียนเอกสาร เขียนเทส หรือแนบไว้ใน bug report ได้ในคลิกเดียว
- เรียน GROQ ได้เร็วที่สุด ข้อมูลตัวอย่าง ผลลัพธ์แบบทันที และ error ที่ตรงประเด็น คือสูตรที่เร็วที่สุดสำหรับทำความเข้าใจภาษา query ของ Sanity
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| วาง JSON หรือ Load sample | ใส่ชุดข้อมูล JSON ใด ๆ หรือโหลดข้อมูลตัวอย่างได้ในคลิกเดียว |
| ตัวแก้ไข query | เขียน GROQ ของ Sanity ได้เต็มรูปแบบ ทั้ง filter, projection, order(), slice และการ join reference ด้วย -> |
| แผงผลลัพธ์ (Result) | แสดงเอกสารที่ตรงเงื่อนไขเป็นผลลัพธ์ที่อ่านง่าย ไม่ใช่ข้อมูลดิบกองรวมกัน |
| ข้อความ error ที่ชัดเจน | บอก syntax error อย่างเจาะจง พร้อมข้อความ query matched no documents เมื่อไม่มีอะไรตรงเงื่อนไข |
| ดาวน์โหลดผลลัพธ์ | ส่งออกผลลัพธ์ไปใช้ในเอกสาร เทส หรือ bug report |
| Reset | ล้างชุดข้อมูลและ query เพื่อเริ่มต้นใหม่อย่างสะอาด |
| ทำงานในเบราว์เซอร์ 100% | ไม่ต้องมีบัญชี ไม่มีการอัปโหลด ไม่มีการเรียกเซิร์ฟเวอร์ |
มีสองจุดที่น่าสนใจเป็นพิเศษ ประการแรก การ join reference ทำงานได้จริง การต่อท้ายฟิลด์ด้วย -> จะแสดงเอกสารที่ถูกอ้างถึงในผลลัพธ์เลย ซึ่งเป็นส่วนที่คนใช้ GROQ พลาดบ่อยที่สุด ประการที่สอง error มีความ "สอนได้" ไม่กำกวม แค่วงเล็บหายตัวเดียวก็ได้ข้อความที่เจาะจงกลับมา ทำให้ทุกครั้งที่แก้ query คุณได้เรียนรู้กฎใหม่ไปด้วย
วิธีใช้งาน GROQ Playground
- ใส่ชุดข้อมูล วาง JSON ที่เป็นอาร์เรย์ของเอกสารลงในแผงข้อมูล หรือกด Load sample เพื่อใช้ข้อมูลตัวอย่างทันที ข้อมูลจาก Sanity export หรือ API response ใช้ได้เลยโดยไม่ต้องแก้ไข
- เขียน query พิมพ์ GROQ เช่น *[_type == "post"]{title, "slug": slug.current} ลงในช่อง query
- รัน query เมื่อรัน เครื่องมือจะ parse GROQ ของคุณกับ JSON ที่วางไว้ หาก syntax ผิดจะมีข้อความ error ที่ชัดเจนขึ้นมาทันที
- ตรวจผลลัพธ์ อ่านผลลัพธ์ที่จัดรูปแบบแล้วในแผง Result แล้วค่อย ๆ ปรับ filter แก้ projection หรือเพิ่ม order() และ slice จนรูปร่างข้อมูลตรงกับที่แอปของคุณต้องการ
- ดาวน์โหลดหรือรีเซ็ต บันทึกผลลัพธ์ด้วยปุ่ม Download หรือกด Reset เพื่อล้างทุกอย่างแล้วลองไอเดียถัดไป
พื้นฐาน GROQ ที่ควรรู้
ตัวเลือกทุกอย่าง เครื่องหมาย * เพียงตัวเดียวจะจับเอกสารทุกชิ้นใน dataset เป็นจุดเริ่มต้นของ query เกือบทุกตัว ลองรัน * ก่อนเพื่อดูให้ชัดว่าข้อมูลที่คุณมีหน้าตาเป็นอย่างไร
Filter ในวงเล็บเหลี่ยม ต่อท้ายด้วยเงื่อนไขเพื่อกรองผลลัพธ์ เช่น *[_type == "post"] จะคืนเฉพาะเอกสารที่ _type เป็น post เงื่อนไขหลายข้อรวมกันได้ด้วย && และ || และการเปรียบเทียบอย่าง publishedAt > "2026-01-01" ก็ทำงานตามที่คิดไว้
Projection ในวงปีกกา ต่อท้าย filter ด้วย {...} เพื่อกำหนดรูปร่างของผลลัพธ์ ใน *[_type == "post"]{title, "slug": slug.current} จะได้เฉพาะ title และ slug โดยไวยากรณ์ "alias": value ใช้เปลี่ยนชื่อฟิลด์ได้ การ projection ช่วยให้ payload เล็กลงและผลลัพธ์คาดเดาได้
การเรียงลำดับและการตัดช่วง ใช้ | order(_createdAt desc) เพื่อเรียงข้อมูล แล้วตัดช่วงด้วย slice เช่น [0...3] เพื่อเอา 3 รายการแรก slice คือวิธีทำ pagination ใน GROQ เพราะไม่มีคำสั่ง LIMIT แบบ SQL ให้ใช้
การ dereference ด้วย -> เมื่อฟิลด์เป็น reference ชี้ไปยังเอกสารอื่น -> จะตามไปดึงเอกสารนั้นมาให้ เช่น *[_type == "post"]{title, author->{name}} จะฝังชื่อผู้เขียนเข้ามาตรง ๆ แทน ID ดิบ ๆ
GROQ ต่างจาก SQL และ jq อย่างไร GROQ ไม่มีตารางและไม่มีคำสั่ง JOIN การ join คือแค่ -> เท่านั้น และรูปร่างของ query จะสะท้อนโครงสร้าง JSON ที่ได้กลับมาโดยตรง เทียบกับ jq ที่เขียนเชิง procedural มากกว่า GROQ เน้น declarative คุณแค่บอกว่าต้องการผลลัพธ์แบบไหน ส่วนการเรียงลำดับและการ resolve reference ถูก built-in มาให้แล้ว
ตัวอย่างการใช้งานจริง
เรียนรู้ query ของ Sanity ก่อนเชื่อมต่อกับแอปจริง
ตอนเริ่มโปรเจกต์ Sanity งาน frontend กับ query มักพัฒนาไปด้วยกันตลอดเวลา ลอง prototype ทุก query ที่นี่กับเอกสารตัวอย่างก่อน แล้วค่อย copy query ที่ผ่านการตรวจแล้วไปใส่ในโค้ด วิธีนี้ทำให้คุณไม่ต้องดีบัก GROQ กับเฟรมเวิร์กไปพร้อมกัน และ query ที่ส่งขึ้น production คือ query ที่คุณเห็นผลลัพธ์ถูกรูปร่างมาแล้ว
ดีบัก query ที่ใช้งานจริงด้วยชุดข้อมูลทดสอบขนาดเล็ก
ถ้า query บนระบบจริงมีพฤติกรรมแปลก ๆ ให้ export เอกสารที่เกี่ยวข้องไม่กี่ชิ้น วางลงในเครื่องมือ แล้ว reproduce ปัญหาแบบ local การย่อ dataset ให้เหลือไม่กี่เอกสารทำให้ slice ที่เผลอนับเกินหรือ projection ที่ผิดเห็นชัดภายในไม่กี่วินาที และไฟล์ fixture นั้นยังใช้เป็นเทส regression ของการแก้ไขได้อีกด้วย
สอนเรื่อง content modeling ให้ทีมของคุณ
เรื่อง content modeling จะ click ก็ต่อเมื่อคนได้จับข้อมูลจริงกับตา ลองพาเพื่อนร่วมทีมใหม่ไล่ดู schema ของคุณด้วยการรัน *[_type == "author"]{...} สด ๆ ให้เห็นว่าเอกสารเชื่อมต่อกันอย่างไร และทำไม projection แต่ละอันถึงออกแบบมาในรูปร่างนั้น วิธีนี้ได้ผลกว่าสไลด์สักเท่าตัว
ตรวจสอบข้อมูลจากไฟล์ JSON ที่ export มาอย่างรวดเร็ว
ได้ไฟล์ JSON จากลูกค้าหรือ CMS อื่นส่งมา? รันเช็กเร็ว ๆ ได้เลยโดยไม่ต้องเขียนสคริปต์สักบรรทัด เช่น มี post กี่ชิ้นที่ publish แล้ว รายการไหนไม่มีผู้เขียน หรือสิบรายการล่าสุดคืออะไร คำถามที่ query เขียนเสร็จในสามสิบวินาที ตอบได้เร็วกว่าการเปิด spreadsheet มาไล่นับเป็นไหน ๆ
แนวปฏิบัติที่ดี
- Projection เฉพาะฟิลด์ที่ต้องใช้ การขอ {title, slug} แทน * ทำให้ payload เล็กลงและผลลัพธ์อ่านง่ายขึ้นมาก
- เรียงลำดับก่อนตัดช่วงเสมอ [0...3] ที่ต่อท้าย order() จะให้ 3 อันดับแรกที่มีความหมาย แต่ slice ของข้อมูลที่ไม่ได้เรียงจะสุ่มได้เอกสารอะไรก็ได้
- ตั้งชื่อ projection ให้สื่อความหมาย ใช้ "authorName": author->{name} เพื่อให้โค้ดฝั่งที่นำผลลัพธ์ไปใช้อ่านรู้เรื่องในตัวเอง
- เริ่มกว้างแล้วค่อย ๆ กรอง เริ่มจาก * เพิ่ม filter แล้วตามด้วย projection ทีละอย่าง จะทำให้เห็นที่มาของ error ได้ง่ายเสมอ
- เก็บไฟล์ fixture ไว้ใช้ซ้ำ ชุดข้อมูลเล็ก ๆ ที่สร้างเองช่วยให้การทดสอบ query ซ้ำหลังจาก schema เปลี่ยนเป็นเรื่องไม่ยาก
- กด Reset ระหว่างงานแต่ละชิ้น การเริ่มจากหน้าจอสะอาดป้องกันไม่ให้ข้อมูลของงานเมื่อวานมาปนเปื้อนกับการทดลองของวันนี้
พร้อมเขียน query แรกของคุณหรือยัง? เปิด GROQ Playground กด Load sample แล้วรัน * ดูก่อน ภายในหนึ่งนาทีคุณจะมี query ที่ใช้งานได้จริง และการทดลองทุกครั้งหลังจากนั้นไม่มีค่าใช้จ่ายใด ๆ ทั้งสิ้น
เครื่องมืออื่น ๆ ที่คุณอาจสนใจ:
- jq Playground — ฝึกเขียน filter expression ของ jq กับ JSON ในเบราว์เซอร์
- JSON Formatter — จัดรูปแบบ ตรวจสอบ และย่อ JSON ก่อนนำไป query
- Regex Tester — สร้างและดีบัก regular expression พร้อมไฮไลต์ผล match แบบเรียลไทม์
ขอให้สนุกกับการเขียน query!
คำถามที่พบบ่อย
ถ: GROQ Playground เกี่ยวข้องกับ Sanity โดยตรงหรือไม่? ตอบ: ไม่เกี่ยวข้อง เป็นเครื่องมืออิสระที่ใช้ฟรี รองรับภาษา GROQ ของ Sanity โดยทำงานกับ JSON ที่คุณวางลงไปทั้งหมดภายในเบราว์เซอร์ของคุณเอง
ถ: ต้องมีบัญชี Sanity หรือ API token หรือไม่? ตอบ: ไม่ต้อง เครื่องมือทำงานกับ JSON ที่วางเข้ามาเท่านั้น จึงไม่มีอะไรต้องเชื่อมต่อและไม่มีอะไรต้องยืนยันตัวตน
ถ: query รันได้แต่ไม่มีผลลัพธ์ ควรเช็กอะไรก่อน? ตอบ: เครื่องมือจะแจ้งชัดเจนเมื่อ query matched no documents มักเกิดจาก filter เข้มเกินไป ลองตรวจสอบค่า _type ว่าพิมพ์ถูกเป๊ะหรือไม่ ดูชื่อฟิลด์ และชนิดของค่าที่เทียบกับข้อมูลจริงใน dataset ของคุณ
ถ: วางข้อมูล production ลงไปปลอดภัยหรือไม่? ตอบ: ปลอดภัย เพราะการ parse และรัน query ทั้งหมดเกิดขึ้นฝั่ง client ข้อมูลของคุณไม่ถูกส่งไปยังเซิร์ฟเวอร์ใด ๆ