Image OCR Tool: ดึงข้อความจากรูปภาพในเบราว์เซอร์อย่างเป็นส่วนตัว
Image OCR Tool ช่วย extract ข้อความจากรูปภาพในเบราว์เซอร์ของคุณด้วย Tesseract.js รองรับหลายภาษา พร้อมปุ่ม copy และ export เป็นไฟล์ TXT โดยไม่ต้องอัปโหลดรูปขึ้นเซิร์ฟเวอร์
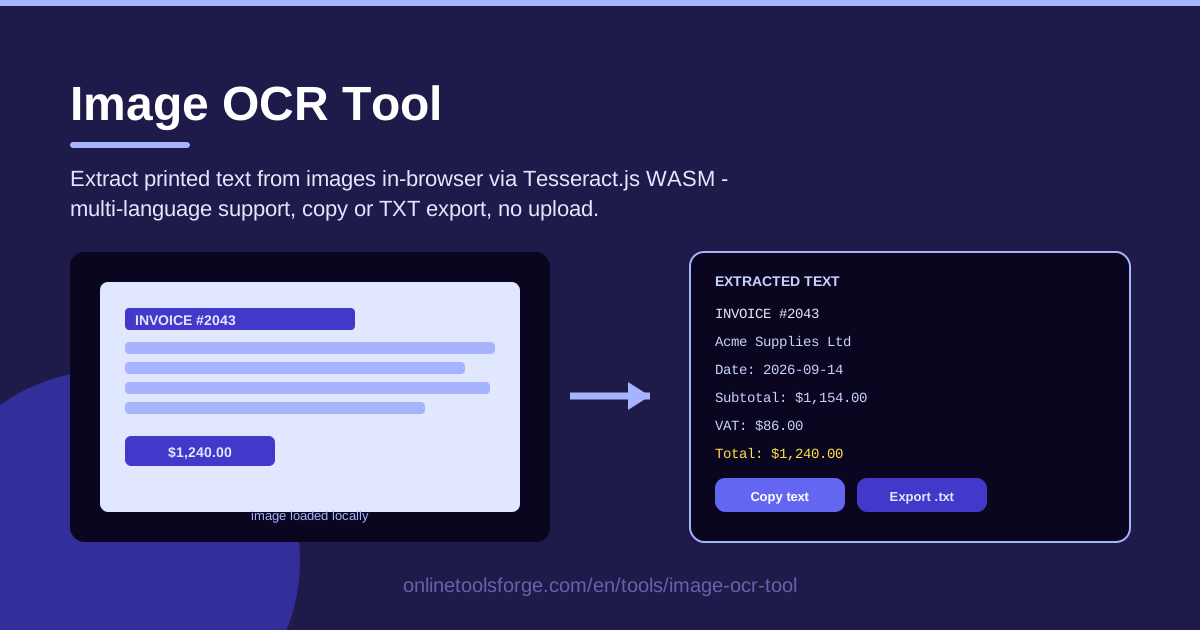
Table of Contents
ทุกวันนี้เราต้องเจอข้อความที่ติดอยู่ในรูปภาพอยู่บ่อยครั้ง ไม่ว่าจะเป็นภาพถ่ายใบเสร็จ ภาพหน้าจอข้อความ error หรือเอกสารสแกน วิธีนำข้อความเหล่านั้นออกมาใช้แบบดั้งเดิมมีสองทางเลือก คือ พิมพ์ใหม่ทั้งหมดด้วยมือ หรืออัปโหลดรูปภาพขึ้นเว็บ OCR ออนไลน์ แล้วเสี่ยงให้เอกสารของเราถูกส่งไปเก็บไว้ที่เซิร์ฟเวอร์ของผู้อื่น
Image OCR Tool ช่วยปิดปัญหานี้ได้อย่างสมบูรณ์ เครื่องมือนี้รัน Tesseract.js ซึ่งเป็น OCR engine โอเพนซอร์สที่ถูกคอมไพล์เป็น WebAssembly (WASM) ทำงานภายในเบราว์เซอร์ของคุณทั้งหมด รูปภาพไม่เคยออกจากเครื่องของคุณเลย ไม่มีขั้นตอนอัปโหลด ไม่ต้องสมัครสมาชิก ไม่มีคิวรอประมวลผล เพียงโหลดรูป เลือกภาษา รันการอ่านข้อความ แล้วคุณจะได้ text ที่แก้ไขได้ พร้อม copy ไปยัง clipboard หรือ export เป็นไฟล์ .txt ได้ทันที
บทความนี้จะพาไปดูว่าเครื่องมือนี้ทำอะไรได้บ้าง วิธีใช้งานทีละขั้นตอน จุดที่ OCR ทำได้ดีจริงและจุดที่ยังทำได้ไม่ดี รวมถึงเทคนิคที่ช่วยให้ได้ผลลัพธ์ที่สะอาดที่สุดจากรูปภาพของคุณ
ทำไมต้องใช้ Image OCR Tool?
- เอกสารส่วนตัวไม่ถูกอัปโหลดไปไหน นี่คือเหตุผลสำคัญที่สุด เพราะรูปภาพถูกอ่านด้วยโค้ดที่รันในเบราว์เซอร์ของคุณเอง และ OCR engine ทำงานแบบ local ผ่าน WASM ใบแจ้งหนี้ สัญญา บัตรประชาชน และรายงานภายในจึงอยู่บนเครื่องของคุณตลอดเวลา ไม่มีอะไรถูกส่งไปที่เซิร์ฟเวอร์
- ไม่ต้องสมัคร ไม่มีค่าใช้จ่าย ไม่จำกัดจำนวนครั้ง ไม่ต้องติดตั้งอะไรเพิ่ม เปิดหน้าเว็บแล้วเริ่ม extract ข้อความได้เลย เท่าที่ต้องการ
- รองรับหลายภาษาในตัว เลือก language model ให้ตรงกับเอกสาร ซึ่งจำเป็นมากสำหรับข้อความที่ไม่ใช่ภาษาอังกฤษ และเอกสารที่มีหลายภาษาปนกัน
- Copy หรือ export ได้ในคลิกเดียว ส่งข้อความที่ดึงได้ตรงเข้า clipboard เพื่อวางลงอีเมลหรือโปรแกรมแก้ไขข้อความ หรือบันทึกเป็นไฟล์ .txt เก็บไว้ใช้ภายหลัง
- ใช้งานได้แม้เน็ตไม่แรง เมื่อ language model โหลดมาแล้ว การอ่านข้อความเกิดขึ้นบนอุปกรณ์ของคุณเอง สัญญาณที่ปรวนแปรจึงไม่ทำให้งานสะดุด
- เร็วพอสำหรับงานจริง เพราะไม่ต้องส่งข้อมูลไปกลับกับเซิร์ฟเวอร์ระยะไกล หน้าเอกสารพิมพ์ที่สะอาดมักถูกอ่านเสร็จภายในไม่กี่วินาทีบนเครื่องสมัยใหม่
ฟีเจอร์หลักของเครื่องมือ
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| โหลดรูปจากเครื่อง | เปิดไฟล์รูปภาพจากอุปกรณ์ของคุณ ข้อมูลไม่ถูกส่งออกไปที่ใด |
| OCR engine Tesseract.js | ประมวลผล OCR เต็มรูปแบบในเบราว์เซอร์ผ่าน WebAssembly (WASM) |
| รองรับหลายภาษา | เลือก language model ให้ตรงกับเอกสารเพื่อความแม่นยำของตัวอักษร |
| Copy ไปยัง clipboard | คลิกเดียวได้ข้อความพร้อมนำไปวางใช้งานต่อ |
| Export เป็นไฟล์ TXT | บันทึกข้อความที่อ่านได้เป็นไฟล์ .txt เพื่อเก็บหรือแก้ไขต่อ |
| ไม่มีการอัปโหลด | รูปภาพอยู่บนอุปกรณ์ตลอดกระบวนการ เอกสารสำคัญจึงยังเป็นส่วนตัว |
สิ่งที่ควรรู้เพิ่มเติม:
- การอ่านครั้งแรกของแต่ละภาษาจะดาวน์โหลด language model มาเก็บไว้ครั้งเดียว ครั้งถัด ๆ ไปจะเร็วขึ้นเพราะโมเดลอยู่ในหน่วยความจำแล้ว
- ผลลัพธ์แสดงในแผงที่แก้ไขได้ คุณจึงแก้คำที่อ่านผิดเล็กน้อยก่อน copy หรือ export ได้ทันที
วิธีใช้งาน Image OCR Tool
- โหลดรูปภาพ เปิดเครื่องมือแล้วโหลดรูปที่ต้องการประมวลผลจากอุปกรณ์ของคุณ ภาพสแกนคมชัดหรือภาพถ่ายที่นิ่งจะให้ผลดีที่สุด
- เลือกภาษา เลือก language model ให้ตรงกับข้อความในรูป ถ้าเอกสารมีหลายภาษาปนกัน ให้เลือกภาษาหลักแล้วตรวจทานส่วนที่เหลือเอง
- รัน OCR เริ่มการอ่านข้อความ Tesseract.js จะวิเคราะห์ layout แยกบริเวณข้อความ และถอดรหัสตัวอักษร ซึ่งปกติใช้เวลาไม่กี่วินาทีต่อหน้าเอกสารมาตรฐาน
- ตรวจทานข้อความที่ได้ อ่านผลลัพธ์ในแผง output แล้วเช็คจุดที่ OCR พลาดบ่อย เช่น ตัว l เล็กกับตัว I ใหญ่ เลข 0 กับตัว O และเครื่องหมายวรรคตอนท้ายบรรทัด
- Copy หรือ export เมื่อข้อความถูกต้องแล้ว ก็ copy ลง clipboard หรือ export เป็นไฟล์ .txt ได้ทันที พร้อมนำไปใช้ต่อในทุกโปรแกรม
OCR ทำอะไรได้ดี (และทำอะไรได้ไม่ดี)
Tesseract อ่านข้อความพิมพ์อย่างไร Tesseract เริ่มจากการเก็บกวาดภาพ คือแปลงเป็นขาวดำและลด noise จากนั้นวิเคราะห์ layout เพื่อหาบล็อกข้อความ บรรทัด และคำ สุดท้ายจะเทียบรูปร่างของตัวอักษรแต่ละตัวกับโมเดลทางสถิติของตัวอักษรที่มันถูกฝึกมา เอกสารพิมพ์ที่สะอาดจึงให้ผลแม่นยำมาก เพราะตัวอักษรทุกตัวมีรูปร่างตรงกับที่โมเดลคาดไว้
ทำไมข้อความพิมพ์ถึงชนะลายมือ ชุดข้อมูลฝึกของ Tesseract เป็นข้อความพิมพ์เป็นส่วนใหญ่ และตัวอักษรพิมพ์มีรูปร่างคงที่ ขณะที่ลายมือแต่ละคนเขียนไม่เหมือนกัน แม้แต่ในคำเดียวกันก็แปรผัน ทำให้วิธีจับคู่รูปร่างใช้ไม่ได้ผล เอกสารพิมพ์ ใบแจ้งหนี้ และแบบฟอร์มจึงออกมาดีเยี่ยม ตัวอักษรเขียนใหญ่ชัดเจนแบบ block capitals พอใช้ได้ แต่ลายมือต่อเนื่องแบบเขียนหวัดจะให้ผลแย่มาก
คุณภาพของภาพคือตัวตัดสิน มีสามเรื่องที่สำคัญที่สุด:
- ความละเอียด (resolution): ตัวอักษรแต่ละตัวต้องมีพิกเซลมากพอให้จำแนกได้ ราว 300 DPI คือค่าที่เหมาะสำหรับเอกสารสแกน ส่วนภาพถ่ายจากระยะไกลไม่มีรายละเอียดพอตั้งแต่ต้น
- คอนทราสต์ (contrast): ตัวอักษรเข้มบนพื้นสว่างสม่ำเสมอคือสภาพที่ดีที่สุด เงา กระดาษสีเทา หมึกจาง และลายน้ำที่ซ้อนอยู่หลังข้อความล้วนเพิ่ม noise
- ความเอียง (skew): Tesseract ทนความเอียงได้ไม่กี่องศา แต่ภาพที่ถ่ายจากมุมเฉียงจะบิดรูปร่างตัวอักษรเอง ความแม่นยำจึงตกลงอย่างรวดเร็ว
ข้อควรรู้เรื่องหลายภาษา การเลือก language model ให้ถูกภาษาคือการตั้งค่าที่กระทบผลลัพธ์มากที่สุด โมเดลภาษาอังกฤษรู้จักตัวอักษรละตินและจะอ่านอักษรไทยเพี้ยน ขณะที่โมเดลภาษาไทยก็จะอ่านภาษาอังกฤษเพี้ยนเช่นกัน ถ้าเอกสารผสมหลายภาษาจริง ๆ ให้ประมวลผลแยกทีละช่วงภาษา หรือรันภาษาหลักแล้วแก้ส่วนที่เหลือด้วยมือ
ข้อแลกเปลี่ยนเรื่องความเร็วของ WASM การรัน engine ในเบราว์เซอร์หมายความว่างานทั้งหมดเกิดขึ้นบน CPU ของคุณผ่าน WebAssembly ซึ่งช้ากว่าโค้ด native ภาพใหญ่ความละเอียดสูงจะใช้เวลานานกว่า ส่วนภาพที่ crop แล้วเล็กเกือบจะได้ผลทันที ราคาที่จ่ายกับความช้านี้ถูกมากเมื่อเทียบกับสิ่งที่ได้กลับมา คือความเป็นส่วนตัวเต็มร้อย ไม่ใช้แบนด์วิดท์อัปโหลด และไม่มีค่าใช้จ่ายต่อหน้า
การประมวลผลแบบ local คือฟีเจอร์ด้านความเป็นส่วนตัว เพราะทุกอย่างเกิดขึ้นบนอุปกรณ์ของคุณ จึงไม่มี log ของเอกสารบนเซิร์ฟเวอร์ ไม่มีนโยบายเก็บรักษาข้อมูลที่ต้องเชื่อ และไม่มีความเสี่ยงข้อมูลรั่วจากการถูกแฮ็ก เอกสารลับทุกชนิดจึงประมวลผลได้อย่างสบายใจ
ตัวอย่างการใช้งานจริง
แปลงใบแจ้งหนี้และใบเสร็จเป็นข้อมูลดิจิทัล
ดึงวันที่ ชื่อร้าน ยอดรวม และรายการสินค้าจากใบเสร็จที่ถ่ายหรือสแกนมา เพื่อนำลง spreadsheet หรือรายงานค่าใช้จ่าย เพราะรูปภาพไม่ออกจากเครื่อง ข้อมูลการเงินของคุณจึงยังเป็นส่วนตัว แต่อย่าลืมตรวจตัวเลขอีกครั้ง เพราะ OCR บางครั้งสลับหลักเลขได้
เปลี่ยนภาพหน้าจอเป็น text ที่แก้ไขได้
ข้อความในภาพหน้าจอเลือก ค้นหา หรืออ้างอิงไม่ได้เลยถ้าต้องพิมพ์ใหม่เอง ส่งภาพหน้าจอเข้าเครื่องมือนี้ แล้วข้อความ error, snippet โค้ด หรือข้อความแชทจะกลายเป็น text ปกติที่วางลงเอกสาร ticket หรือช่องค้นหาได้ทันที
แปลงแบบฟอร์มสิ่งพิมพ์เป็นโน้ต
ใบสมัคร แบบสอบถาม และเช็คลิสต์ที่พิมพ์ไว้สามารถแปลงเป็น plain text ได้ในรอบเดียว ทำให้ค้นหาได้ในแอปโน้ต และอ้างอิงภายหลังง่ายกว่าการไล่เปิดดูโฟลเดอร์เต็มไปด้วยรูปถ่าย
จับภาพจากกระดานไวท์บอร์ด
หลังประชุมหรือ workshop ถ่ายรูปกระดานแล้วดึงข้อความที่เป็นตัวพิมพ์หรือเขียนตัวใหญ่ชัดเจน เช่น หัวข้อ สิ่งที่ต้องทำ และ URL ป้ายกำกับใน flowchart กับหัวข้อต่าง ๆ มักออกมาดี แต่ลายมือต่อเนื่องจะไม่ค่อยได้ผล ส่วนนั้นควรถือว่าเป็นรูปภาพหรือพิมพ์ใหม่เอง
แนวทางปฏิบัติที่ดีที่สุด
- Crop ภาพก่อน OCR ตัดขอบภาพ นิ้วมือ และพื้นโต๊ะออก ยิ่งพื้นที่ที่ไม่ใช่ข้อความน้อย ตัวอักษรเกินมาในผลลัพธ์ก็ยิ่งน้อย
- ทำให้ภาพตรง หมุนภาพจนเส้นข้อความนอนแนวนอน เอียงไม่กี่องศายังทนได้ แต่มากกว่านั้นความแม่นยำจะแย่ลงชัดเจน
- เลือก language model ให้ถูก จับคู่โมเดลกับภาษาจริงของเอกสาร นี่คือการตั้งค่าที่กระทบผลลัพธ์มากที่สุดที่อยู่ในมือคุณ
- ตรวจตัวเลขอย่างละเอียด ยอดรวม เลขที่ใบแจ้งหนี้ และเบอร์โทร คือจุดที่ข้อผิดพลาดเล็ก ๆ สร้างความเสียหายมากที่สุด ระวังการสับสนระหว่าง l/1, O/0 และ S/5
- ถ่ายในแสงดี ถ่ายตรง ๆ แสงสม่ำเสมอ และให้ข้อความเต็มกรอบภาพ
- เก็บไฟล์รูปต้นฉบับไว้ ถ้าผลลัพธ์ดูผิด ให้ลองรันใหม่จากภาพที่ดีกว่า ดีกว่าการไล่แก้เอกสารยาว ๆ ด้วยมือ
พร้อมเปลี่ยนรูปภาพให้เป็นย่อหน้าข้อความหรือยัง ลองโหลดรูปเข้า Image OCR Tool เลือกภาษา แล้วรับ text ที่แก้ไขได้ภายในไม่กี่วินาที จะ copy หรือ export เป็น .txt ก็ได้ โดยเอกสารไม่เคยออกจากอุปกรณ์ของคุณเลย
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
ขอให้สนุกกับการดึงข้อความจากรูปภาพ!
คำถามที่พบบ่อย
ถ: รูปภาพของฉันถูกอัปโหลดขึ้นเซิร์ฟเวอร์หรือไม่? ตอบ: ไม่ รูปภาพถูกประมวลผลภายในเบราว์เซอร์ของคุณทั้งหมดโดย Tesseract.js ที่รันเป็น WebAssembly ไม่มีข้อมูลใดถูกส่งหรือเก็บไว้ เอกสารลับจึงประมวลผลได้อย่างปลอดภัย
ถ: OCR รองรับภาษาอะไรบ้าง? ตอบ: เครื่องมือรองรับหลายภาษาผ่าน language model ของ Tesseract ให้เลือกโมเดลให้ตรงกับเอกสารก่อนรันการอ่าน เพราะการเลือกนี้กระทบความแม่นยำมากที่สุด โดยเฉพาะสำหรับข้อความที่ไม่ใช่ภาษาอังกฤษ
ถ: อ่านลายมือได้ไหม? ตอบ: ไม่ค่อยได้ผล Tesseract ถูกฝึกด้วยข้อความพิมพ์ เอกสารพิมพ์และตัวอักษรเขียนใหญ่ชัดเจนแบบ block capitals ใช้ได้ดี แต่ลายมือต่อเนื่องจะให้ผลแย่ ควรคาดหวังว่าจะต้องพิมพ์ใหม่เองส่วนใหญ่
ถ: ทำไมรูปใหญ่ประมวลผลช้ากว่ารูปเล็ก? ตอบ: เพราะ engine ทำงานบน CPU ของเครื่องคุณภายในเบราว์เซอร์ เวลาที่ใช้จึงแปรผันตามขนาดภาพและปริมาณข้อความ การ crop เฉพาะส่วนที่ต้องการและใช้รูปขนาดพอเหมาะช่วยให้การอ่านเร็วขึ้น