คู่มือใช้งาน JMESPath Tester: เชี่ยวชาญ filter, projection และ function
เรียนรู้การเขียนและ debug JMESPath query กับ JSON payload จริง เชี่ยวชาญ filter, projection, multiselect และ built-in function ด้วยผลลัพธ์ทันที syntax error ที่ชัดเจน และ matched paths
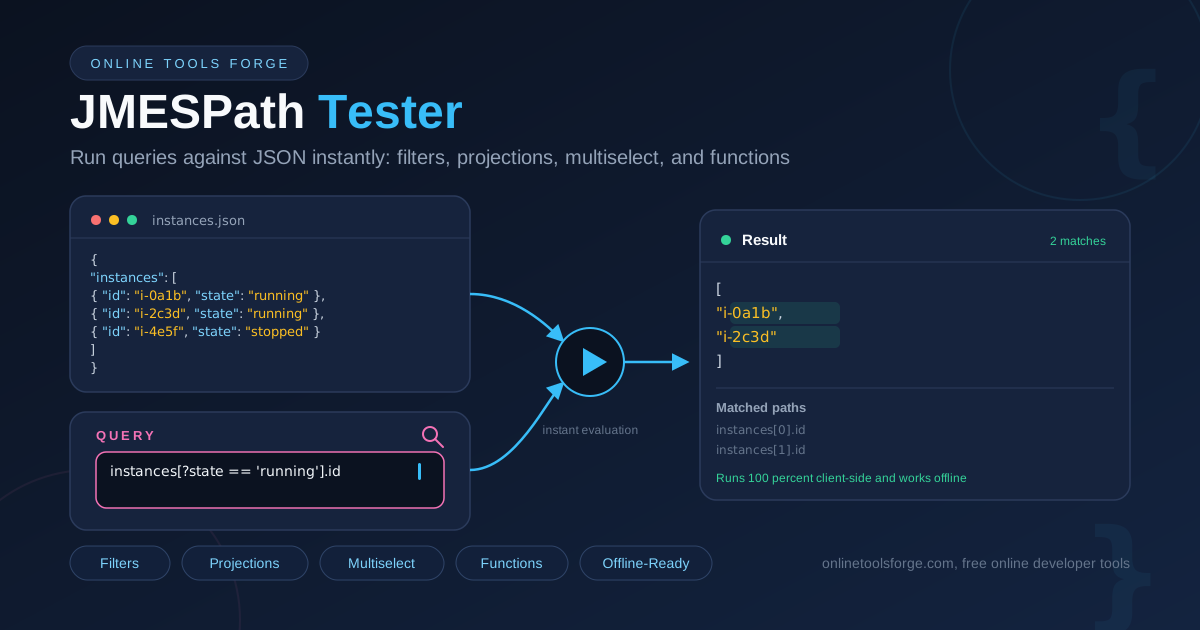
Table of Contents
คู่มือใช้งาน JMESPath Tester: เชี่ยวชาญ filter, projection และ function
ถ้าคุณเคยต่อท้ายคำสั่ง AWS CLI ด้วย --query หรือดึง field ที่ซ้อนอยู่ลึก ๆ จาก response ของ boto3 มาก่อน แปลว่าคุณได้ใช้ JMESPath มาแล้วโดยที่อาจไม่รู้จักชื่อมันก็ได้ JMESPath คือ query language แบบ declarative ที่ถูกฝังมาใน AWS CLI, boto3, AWS SDKs, Ansible และเครื่องมืออีกมากมาย มันอธิบายวิธีเดินไปใน JSON document เพื่อเลือกเฉพาะค่าที่คุณต้องการด้วย expression เดียวกระชับ แทนที่จะเขียน loop เองทุกครั้ง
ประเด็นคือ JMESPath เป็นภาษาจริงที่มี grammar ของตัวเอง วงเล็บใน filter วางผิดที่ ลืม wildcard หรือขาด pipe นิดเดียว ผลที่ได้อาจเป็น null, list ว่าง หรือ syntax error ที่อ่านไม่รู้เรื่องใน terminal เดาสุ่มมักไม่เวิร์ก การทดสอบกับ payload ที่ใกล้เคียงของจริงต่างหากที่ได้ผล
นั่นแหละคือจุดที่ JMESPath Tester ฟรีเข้ามาช่วย วาง JSON ของคุณ พิมพ์ query แล้วดูผลลัพธ์ matched values และ syntax error พร้อมตำแหน่งที่ผิด — ทันที และทำงานทั้งหมดใน browser ของคุณ คู่มือนี้จะพาไปจาก dot notation จนถึง filter, projection, multiselect และ function โดยใช้ payload เดียวกันตลอดทาง
ทำไมต้องใช้ JMESPath Tester?
- Feedback loop ทันที: ผลลัพธ์อัปเดตตามที่คุณพิมพ์ ทดลอง syntax ของ filter และ projection ได้ในไม่กี่วินาที
- Syntax error ชัดเจนพร้อมตำแหน่ง: query ที่ผิดจะรายงาน error และจุดที่เกิด ทำให้แก้ได้ในสิบวินาทีแทนที่จะงงกับข้อความลึกลับ
- เห็น matched values และ paths: นอกจากผลลัพธ์สุดท้าย คุณยังเห็นว่า path ไหน match บ้าง ทำให้ projection ที่ซับซ้อนเข้าใจได้ง่ายขึ้น
- Client-side 100 เปอร์เซ็นต์: JSON ไม่เคยออกจากเครื่องคุณ จึงทดสอบ payload ที่มี identifier จริงหรือข้อมูลอ่อนไหวได้อย่างปลอดภัย
- ใช้งาน offline ได้: โหลดหน้าเว็บแล้วไม่ต้องใช้เน็ต — สะดวกเวลา debug ผ่าน VPN หรือบนเครื่องที่แยกจาก network
- ซ้อม query ก่อนขึ้นของจริง: validate expression ก่อนที่มันจะไปอยู่ใน script, CI job หรือ runbook ไม่ใช่ไปแก้ทีหลัง
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร | ทำไมจึงสำคัญ |
|---|---|---|
| ประเมินผลทันที | รัน query กับ JSON ที่วางไว้ตามที่คุณพิมพ์ | ไม่ต้อง save-reload ระหว่างทดลอง |
| Filter expression | รองรับเงื่อนไขอย่าง [?state == 'running'] | เลือกเฉพาะรายการที่สนใจจริง ๆ |
| Projection | ประมวลผล list และ object ด้วย [], [*] และ * | ใช้ expression เดียวกับทุก element ในครั้งเดียว |
| Multiselect | สร้าง list และ hash อย่าง {id: id, name: name} | ปรับรูปร่างเอกสารให้เป็น output ที่ต้องการเป๊ะ ๆ |
| Built-in function | sort(), length(), keys(), not_null() และเพื่อน ๆ | นับ เรียง และแปลงข้อมูลโดยไม่ต้องพึ่งเครื่องมืออื่น |
| รายงาน error | ระบุ syntax error พร้อมตำแหน่ง | แก้ query ได้ไวแทนที่จะมอง null ค้างไป |
มีสองเรื่องนอกเหนือจากตารางที่น่าสังเกต:
- ทุกอย่างรันใน browser — ไม่ต้องติดตั้งอะไร ไม่ต้องสมัครบัญชี
- ผังผลลัพธ์แยกให้เห็นว่าเป็น "ไม่มีผลลัพธ์" หรือ "syntax ผิด" ซึ่งต่างกันมากกว่าที่คิดตอน debug query ดึก ๆ
วิธีการใช้งาน
- เปิดตัว tester ที่หน้า JMESPath Tester โหลดทันทีและใช้ต่อแบบ offline ได้หลังจากนั้น
- วาง JSON document ลงในช่อง input JSON ที่ถูกต้องใช้ได้หมด: API response, output จาก CLI, config file หรือ log record
- เขียน JMESPath query ในช่อง query เริ่มจากง่าย ๆ เช่น instances[0].name แล้วค่อยต่อยอดทีละขั้น
- อ่านผลลัพธ์ matched values จะโผล่ทันที ถ้า query มี syntax ผิด จะเห็น error พร้อมตำแหน่งแทนผลลัพธ์
- ไล่ปรับแล้ว copy เทียบหลาย ๆ variant แล้วคัดลอก query ตัวที่ชนะไปใช้ในคำสั่ง CLI, SDK call หรือ script ของคุณ
จาก dot notation สู่ projection
เพื่อให้เห็นภาพชัด ส่วนนี้จะใช้ payload เดียวคือ response แบบ EC2 ฉบับย่อ
{
  "instances": [
    { "id": "i-0a1b", "name": "web-01", "state": "running", "score": 61 },
    { "id": "i-2c3d", "name": "db-01",  "state": "running", "score": 42 },
    { "id": "i-4e5f", "name": "web-02", "state": "stopped", "score": 78 }
  ]
}
เริ่มจาก identifier และ pipe
query ที่ง่ายที่สุดแค่เดินตาม key: instances[0].name ให้ผลเป็น "web-01" identifier ที่ต่อด้วยจุดจะลงลึกในเอกสารที่ซ้อนกัน ส่วน pipe operator | ส่งผลลัพธ์ปัจจุบันเข้าไปใน expression ถัดไป — เป็นวิธีต่อขั้นตอนที่ไม่ง้อกันและกัน
filter ด้วยเงื่อนไขในวงเล็บ
filter เลือกเฉพาะ element ที่เข้าเงื่อนไข: instances[?state == 'running'].id ให้ผลเป็น ["i-0a1b", "i-2c3d"] string literal ใช้ single quote ส่วน numeric literal ตามตำราจะครอบด้วย backtick อย่าง [?score > `50`] — หลาย engine รับตัวเลขเปล่า ๆ ด้วย และตัว tester จะบอกทันทีว่าแบบไหนใช้ได้กับ engine ของคุณ
projection: ทำงานกับทุก element ในครั้งเดียว
instances[*].id (เหมือน instances[].id) ฉีด expression ด้านขวาลงไปในทุก element แล้วให้ผลเป็น ["i-0a1b", "i-2c3d", "i-4e5f"] wildcard ใช้กับ object ได้เช่นกัน เข้าถึงทุก value ใน map โดยไม่ต้องรู้ key ล่วงหน้า
multiselect: ปรับรูปร่างเอกสาร
multiselect สร้างโครงสร้างใหม่จากทุก match hash multiselect อย่าง instances[*].{id: id, name: name} ให้ผลเป็น object เล็ก ๆ หนึ่งอันต่อหนึ่ง instance แทนที่จะได้ทั้งเอกสาร — เป็นเครื่องมือหลักสำหรับกรีด API response ที่อ้วนให้เหลือแค่ field ที่โค้ดอ่านจริง
function: sort, length และเพื่อน ๆ
built-in function เติมการคำนวณเข้ามาในการเลือกข้อมูล length(instances) ให้ผล 3; sort(instances[*].score) ให้ผล [42, 61, 78] ต่อ pipe เข้าไปได้ด้วย: instances[*].score | sort(@) เรียง list ที่ได้จาก projection โดยที่ @ หมายถึง "ผลลัพธ์ปัจจุบัน"
ทำไมผลลัพธ์จึงถูก flatten หลัง projection
นี่คือจุดที่ทำให้คนใช้สับสนมากที่สุดในภาษานี้ เมื่อคุณ projection ซ้อนบน projection — สมมุติทุก instance มี list ชื่อ tags แล้วเขียน instances[*].tags[*] — JMESPath จะไม่สร้าง array ซ้อนกัน แต่ projection ชั้นในจะถูก flatten เป็น list เดียวรวม tag ทั้งหมด ถ้าคุณคาดหวัง [[...], [...]] แต่ได้ array แบน ๆ อันเดียว นั่นคือ projection flattening ทำงาน ไม่ใช่ bug ถ้าอยากรักษาโครงสร้างเดิม ให้ใช้ multiselect แทน projection ชั้นที่สอง
สาม query ไล่ระดับจาก payload เดียวกัน
1) instances[?state == 'running'].name
   -> ["web-01", "db-01"]

2) instances[?score > `50`].{name: name, score: score}
   -> [{"name": "web-01", "score": 61}, {"name": "web-02", "score": 78}]

3) instances[*].score | sort(@) | [-1]
   -> 78   (score สูงที่สุด)
query ที่ 1 filter, อันที่ 2 filter แล้วจัดรูป และอันที่ 3 project เรียง แล้วเลือก index ทั้งหมดจากเอกสารใบเดียวกัน
ตัวอย่างการใช้งานจริง
เขียนนิพจน์ --query ของ AWS CLI
flag --query รับภาษานี้ตรง ๆ ดังนั้น tester จึงเป็นเวทีซ้อมคำสั่ง CLI นิพจน์อย่าง Reservations[].Instances[].InstanceId มีพฤติกรรมที่เซอร์ไพรส์เพราะ projection flattening การเช็กกับ sample response ที่เซฟไว้ก่อนรันจริงช่วยลดการ parse ซ้ำซ้อนได้เยอะ
ดึงข้อมูลจาก API response ขนาดใหญ่
เมื่อ response ลึกเป็นพันบรรทัด projection คู่กับ multiselect จะหยิบมาเฉพาะ field ที่รายงานหรือ test fixture ต้องใช้ จับคู่ tester กับ JSON Formatter เพื่อสำรวจโครงสร้างก่อน แล้วค่อยเขียน query จากสิ่งที่เจอ
กรอง log และ message
structured log, event แบบ CloudWatch และ queue message ล้วนเป็น JSON ชุด query ที่ทดสอบแล้วสักห้า-สิบตัว — เอาเฉพาะ error, request ช้าเกินเกณฑ์ หรือ record ที่ขาด field — เปลี่ยนงาน triage ให้เป็นรูทีนที่ทำซ้ำได้
ตรวจสอบจุดต่อของ data pipeline
ก่อนส่ง transformation ขึ้นใช้งาน ลองเดิน input และ output ที่คาดหวังผ่าน tester ถ้า expression ที่ป้อน pipeline ให้ผลตรงคาดหมายบน sample ที่แทนของจริง คุณได้ตัดความล้มเหลวแบบเงียบ ๆ ออกไปทั้งตระกูล
แนวปฏิบัติที่ดี
- ทดสอบกับ sample ที่ใกล้ของจริง ไม่ใช่ array ของเล่นสองตัว edge case อย่าง list ว่างหรือ key ที่หาย จะปรากฏต่อเมื่อ payload สมจริงเท่านั้น
- จับตาผลลัพธ์ที่ถูก flatten หลัง projection ถ้า query ได้รายการมากหรือน้อยกว่าคาด flattening มักเป็นตัวปัญหา
- ครอบ identifier ที่มีอักขระพิเศษ ด้วย double quote — "order-id", "user.name" — เมื่อ key มีขีด จุด หรือช่องว่าง
- จำ semantics ของ null: JMESPath ให้ null เมื่อ key ไม่มีอยู่แทนการโยน error ดังนั้น null เงียบ ๆ มักแปลว่าพิมพ์ identifier ผิด
- เก็บ query ตัวที่ชนะไว้ในเอกสารทีม ติดกับคำสั่งที่ใช้มัน
- เลือก hash multiselect สำหรับสิ่งที่ส่งต่อให้ระบบอื่น — output ที่รูปร่างคงที่ดีกว่า "ได้อะไรมาก็เอาอย่างนั้น"
เลิกเดากันดีกว่า เปิด JMESPath Tester วาง payload จริง แล้วไล่ปรับจน expression ถูกต้องเป๊ะ
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- jq Playground — ฝึก jq เครื่องมือพี่น้องสนิทของ JMESPath ด้วย feedback ทันทีแบบเดียวกัน
- JSON Formatter — จัดรูปและสำรวจ payload ก่อนเอามา query
- GraphQL Formatter — จัดรูปและตรวจ GraphQL query อย่างใส่ใจเท่ากัน
ขอให้ projection ของคุณ flatten ตรงใจทุกครั้ง
คำถามที่พบบ่อย
ถ: JSON ของฉันถูกส่งไปที่ server ไหม?
ตอบ: ไม่ parsing และการประเมินผลเกิดขึ้นทั้งหมดใน browser ของคุณ เครื่องมือนี้เป็น client-side 100 เปอร์เซ็นต์ payload ที่อ่อนไหวจึงไม่มีทางออกจากเครื่อง และใช้ต่อแบบ offline ได้หลังโหลดหน้าเสร็จ
ถ: JMESPath ต่างจาก jq อย่างไร?
ตอบ: ทั้งคู่ query ข้อมูล JSON เหมือนกัน JMESPath เป็น specification มาตรฐานที่ฝังอยู่ในเครื่องมือ AWS, boto3 และ SDK จำนวนมาก จึงเป็นตัวเลือกที่ถูกทางในจุดนั้น ส่วน jq มีภาษาของตัวเองที่ใหญ่กว่าและฟีเจอร์เยอะกว่า แลกกับเส้นโค้งการเรียนรู้ที่ชันกว่า
ถ: ทำไม query ของฉันได้ null แทนที่จะเป็น error?
ตอบ: JMESPath ให้ null เมื่อ key ไม่มีอยู่ แทนที่จะโยน error null ที่เงียบ ๆ แทบหมายถึงพิมพ์ identifier ผิดหรือลงระดับผิด ส่วน filter จะให้ list ว่างเมื่อไม่มีอะไร match
ถ: การเทียบตัวเลขใน filter ต้องใช้ backtick ไหม?
ตอบ: ใน JMESPath แบบเคร่งครัด literal ในการเปรียบเทียบจะเขียนเป็น raw literal ใน backtick อย่าง [?score > `50`] หลาย implementation รับตัวเลขเปล่า ๆ ด้วย tester จะชี้ให้เห็นทันทีว่า query engine ของคุณรับแบบไหน
ถ: ใช้งานได้โดยไม่ต้องมีอินเทอร์เน็ตหรือ?
ตอบ: ได้ หลังโหลดหน้าเสร็จ ทุกอย่าง — parsing, การประเมินผล และ error report — รันในเครื่องคุณทั้งหมด ไม่มีการติดต่อ server