JSON Graph Visualizer: นำทาง JSON ที่ซ้อนกันด้วย interactive tree ที่คลิกสำรวจได้
เปลี่ยน JSON ที่ซ้อนกันลึกให้เป็น interactive tree ที่ collapse ได้ พร้อม node stats, JSONPath-style path และ text export ประมวลผลฝั่ง client ทั้งหมด คู่มืออ่าน API payload ให้เห็นเป็นแผนที่ที่คลิกสำรวจได้
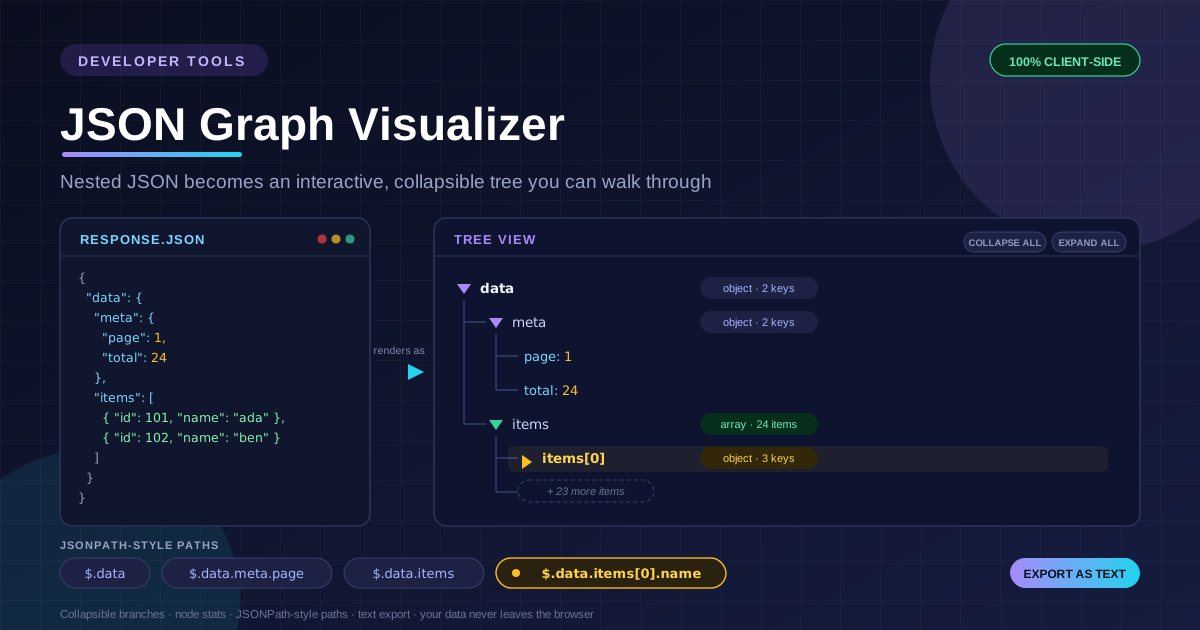
Table of Contents
JSON Graph Visualizer: นำทาง JSON ที่ซ้อนกันด้วย interactive tree ที่คลิกสำรวจได้
API response ยุคนี้แทบไม่มีที่ไหนตื้นแล้ว การยิง REST เพียงครั้งเดียวอาจได้กลับมาทั้ง pagination metadata, array ของ records, object ของ owner ที่ซ้อนอยู่ข้างใน และ error details ที่แทรกมาด้วย ลึกห้าชั้นกว่าจะเจอค่าที่ตัวเองตามหา การไล่อ่าน payload แบบนี้จากข้อความที่จัดรูปแล้วเหมือนเดินเข้าไปในเขาวงกตของวงเล็บ ต้องนับปีกกาไล่ว่าตัวเองยืนอยู่ตรงไหน JSON Graph Visualizer เปลี่ยนเขาวงกตนั้นให้เป็นแผนที่ที่คลิกสำรวจได้ ทุก branch คือ node ที่คุณ expand, collapse และอ้างที่อยู่ได้
ปัญหาไม่ใช่การอ่าน JSON แต่เป็นการหา "ตำแหน่งตัวเอง" ภายใน document formatter ช่วยจัดย่อหน้าให้สวยแล้ว แต่คุณยังต้องไล่ความลึกด้วยย่อหน้าและเก็บ stack ในหัวว่าตอนนี้ยืนอยู่ใน object ไหน ซึ่งใน payload ยาว ๆ stack ในหัวนี้ล้มบ่อยมาก
JSON Graph Visualizer เปลี่ยน stack ในหัวให้เป็นโครงสร้างที่มองเห็น วาง JSON อะไรลงไปก็ได้ แล้วเครื่องมือจะ render เป็น interactive tree ที่ collapse ได้ ทุก node แสดง stats ของตัวเอง ทุก branch มี address แบบ JSONPath และส่งออกทั้ง view เป็นข้อความได้ ทุกอย่างประมวลผลฝั่ง client payload จริงของคุณจึงไม่หลุดออกจากเบราว์เซอร์
ทำไมต้องใช้ JSON Graph Visualizer?
- วงเล็บกลายเป็นแผนที่ — นำทางด้วยจุดสังเกตแทนการนับย่อหน้า: envelope ชั้นนอก, array ของ items, ก้อน meta ไม่ต้องหลงทางอีก
- Collapse สิ่งรก ขยายสิ่งสำคัญ — payload ที่มีข้อมูลสำคัญสามฟิลด์กับขยะอีกสองร้อยฟิลด์ จะเหลือแค่สาม branch ที่เปิดอยู่กับ caret ปิดหลายอัน
- เห็น node stats ทันที — จำนวน children และ type ของแต่ละ node ทำให้ label อย่าง "array · 24 items" บอกขนาดของ collection ได้ก่อนจะกดเปิด
- มี JSONPath-style path ให้ทุก node — คลิก node ไหนก็เห็น address อย่าง $.data.items[0].name ซึ่งเป็น reference ที่ test หรือ query tool ต้องใช้พอดี
- Text export สำหรับแชร์ — แปลง tree เป็น outline แบบเยื้องบรรทัด วางลง ticket หรือ review ได้เลย โดยที่ JSON ดิบอ่านยากกว่ามาก
- ฝั่ง client 100% — parsing, rendering และ export เกิดในเบราว์เซอร์ทั้งหมด ไม่มีอะไรถูกอัปโหลดหรือ log
ฟีเจอร์หลัก
| ฟีเจอร์ | ประโยชน์ที่ได้ |
|---|---|
| Interactive tree ที่ collapse ได้ | branch ที่กดเปิดปิดได้ทีละอัน |
| Node stats | จำนวน children และ type ต่อ node ทำให้ branch อ้วนผิดปกติเด่นขึ้นมาเอง |
| JSONPath-style paths | address อย่าง $.data.items[0].name สร้างให้อัตโนมัติทุก node |
| Text export | outline ข้อความแบบเยื้องบรรทัด พร้อมวางไปใช้ที่ไหนก็ได้ |
| ปุ่ม expand และ collapse | เปิดทีละ branch หรือยุบทั้งหมดเหลือโครงระดับบนสุด |
| ประมวลผลฝั่ง client 100% | parsing และ rendering เกิดในเบราว์เซอร์ทั้งหมด |
เพราะ path ถูกสร้างให้ทุก node tree นี้ยังเป็นเครื่องมือสอนไปในตัว คลิกไปไม่กี่นาทีก็อ่าน JSONPath ได้คล่องโดยไม่ต้องเปิด tutorial สักหน้า
วิธีใช้งาน
- วาง JSON ของคุณ — จะเป็น response body, config file หรือ log ก็ได้ ถ้า JSON เสียเครื่องมือจะรายงาน error ก่อน render tree เสมอ
- อ่าน root ก่อน — มุมมองแบบยุบจะแสดง key ระดับบนสุดกับ type ของมัน ซึ่งคือโครงของ document ทั้งก้อน
- Expand อย่างมีกลยุทธ์ — เปิด branch ทีละอันโดยดูจาก stats: object 3 key เปิดดูได้ไม่ลำบาก ส่วน array 500 ชิ้นปล่อยปิดไว้ก่อนจนกว่าจะจำเป็น
- เลือก node เพื่อดู address — คลิก node ไหนก็เห็น JSONPath-style path และ stats ของมัน แล้วคัดลอก address ไปใช้ในโค้ดหรือ query tool
- Export เมื่อต้องแชร์ — สร้าง outline แบบเยื้องบรรทัด แล้ววางลงเอกสาร, pull request หรือช่องแชทของทีม
สำรวจ JSON เหมือนเดินดูแผนที่
แนวคิดที่ทำให้เครื่องมือนี้ "คลิก" คือการนำทาง ลองมอง JSON document เป็นประเทศเล็ก ๆ: root คือเมืองหลวง, key ระดับบนคือเขตต่าง ๆ, array คือถนนที่มีบ้านเลขที่เรียงกัน และ leaf value คือป้ายหน้าบ้าน tree ที่ collapse ได้ render แผนที่นี้แบบ interactive ส่วน JSONPath-style address ของแต่ละ node ก็คือที่อยู่บนป้าย
ลองดู paginated API response แบบทั่วไป:
{
  "data": {
    "meta": { "page": 1, "total": 24 },
    "items": [
      {
        "id": 101,
        "name": "alpha",
        "owner": { "email": "[email protected]" }
      }
    ]
  }
}
ใน tree, branch data จะ expand เป็นสอง children: meta เปิดออกเป็น leaf page กับ total ส่วน items มี stat ติดไว้ว่า "array · 24 items" ซึ่งบอกว่านี่คือส่วนอ้วนที่สุดของ payload ปล่อย collapse ไว้จนกว่าจะต้องใช้ item ชิ้นใดชิ้นหนึ่ง ลอง expand items[0] จะได้สาม children แล้ว expand owner ต่อ เมื่อคลิกที่ email ก็จะเห็น address เต็ม: $.data.items[0].owner.email
จุดที่ "เรียนรู้แบบเงียบ ๆ" เกิดขึ้นคือตอนอ่าน path ออกจาก tree ทุก segment ต่อหนึ่ง branch ที่คลิก คือบทเรียนของ notation ที่ปกติต้องท่อง: response ถูกห่อด้วย data, records อยู่ใต้ items, array เข้าถึงด้วย index อีกไม่กี่ครั้งคุณจะทาย address ได้ก่อนกดคลิก ซึ่งเป็นความคล่องแบบเดียวกับที่เขียน query ด้วยมือต้องใช้
Node stats ได้ผลสุด ๆ กับ document ใหญ่: branch ที่ติด label "object · 47 keys" มักเป็นกลิ่นบ่งชี้ว่ามีบางอย่างแปลก (เช่น settings object ที่ถูกฝังมาทั้งก้อน) และตัวเลขนี้เห็นตั้งแต่ตอนที่ branch ยังปิดอยู่ text export ปิดวงจร: outline แบบเยื้องบรรทัดสื่อสารลำดับชั้นได้โดยไม่มีเครื่องหมายรก ๆ ของ JSON และเพื่อนร่วมทีมใช้เวลาไม่กี่วินาทีก็เข้าใจ
กรณีการใช้งานจริง
ทำความเข้าใจ API response ที่ไม่คุ้น
ชี้เครื่องมือนี้ไปที่ endpoint ที่คุณไม่ได้เขียน tree แบบยุบจะแสดงโครง envelope ได้ในแวบเดียว: records อยู่ตรงไหน, metadata ซ่อนอยู่ตรงไหน, error มาทาง branch ไหน ปกติเปิดสองสาม branch ก็เข้าใจ contract ทั้งหมด และ path ต่อ node บอกได้เลยว่าจะอ้างถึงแต่ละฟิลด์ใน client code อย่างไร
เขียน query แบบ jq และ JMESPath
query tool ต้องการ path ที่แม่นยำ ให้สำรวจ document ใน tree ก่อน อ่าน address ของ node ที่สนใจ แล้วปรับเป็น syntax ของเครื่องมือที่ใช้: $.data.items[0].name ที่คัดลอกมาอยู่ห่างจาก .data.items[].name ใน jq แค่ก้าวเดียว tree ทำหน้าที่ลาดตระเวนโครงสร้างให้ การเขียน query จึงเหลือแค่งานกล ๆ จากนั้นไปฝึกต่อที่ jq Playground ได้เลย
Debug payload ของ GraphQL และ REST
เมื่อฟิลด์หายหรือเป็น null การวินิจฉัยที่เร็วที่สุดคือดูโครงสร้าง: key หายไปเลย หรือมีอยู่แต่ค่าเป็น null? array ที่ว่าใช่จริง ๆ อยู่ใต้ branch ไหน? stats ช่วยได้ด้วย: array ที่ควรมีสิบชิ้นแต่ขึ้น "array · 1 item" ชี้ว่า filter ปลายทางทำงานเกินหน้า และ path ก็บอกว่าต้องไปแก้ที่ resolver หรือ handler ตรงไหน
เขียนเอกสารและสื่อสารกับทีม
ประโยค "มี user object อยู่ใต้ data และแต่ละ user มี owner ฝังอยู่" คลุมเครือ แต่ outline ที่ export ออกมาแม่นยำ วางลง onboarding doc และ review comment เพื่อให้ทุกคนคุยโครงสร้างเดียวกันด้วยชื่อเดียวกัน และใช้ JSONPath-style address เป็นภาษากลาง: "ค่าที่ $.data.items[0].id" ชัดเจนกว่าข้อความโปรย ๆ เสมอ
แนวปฏิบัติที่ดี
- Collapse branch ที่ไม่เกี่ยวให้เร็ว — tree ที่มี caret ปิดห้าอันคือบทสรุป ส่วน tree ที่เปิดหมดคือกำแพงข้อความเดิมที่คุณเริ่มจาก
- จด path ที่ใช้จริง — path ที่อ่านจาก tree แม่นยำเสมอ ส่วนที่คิดจากความจำทีหลังไม่แน่
- จับคู่กับ formatter — ให้ JSON Formatter จัดการ raw text ส่วน tree ไว้ใช้หาตำแหน่ง ถ้า input เป็น minified ให้ format ก่อนแล้วค่อยสำรวจ
- ใช้ stats จัดลำดับการสำรวจ — เปิด branch ใหญ่ก่อน สอง branch แรกมักมีโครงสร้างที่น่าสนใจเกือบทั้งหมดของ payload
- Export ก่อนอธิบาย — outline สร้างเสร็จไวกว่าพรรณนาเป็นข้อความ และอ่านผิดยากกว่าด้วย
- เก็บ sample ไว้ฝั่ง client — การประมวลผลเกิดในเครื่อง จึงสำรวจ response จริงที่มีข้อมูล user จริงได้อย่างปลอดภัย แต่ควรลบ credential ก่อนแชร์ต่อ
ลองใช้เลย
เปิด JSON Graph Visualizer วาง API response ที่หลอกหลอนคุณล่าสุดลงไป แล้ว collapse ทิ้งทั้งหมด จากนั้นขยายทีละ branch อ่าน path ไปเรื่อย ๆ และ export outline เมื่อมันเริ่มเข้าใจ สิบนาทีของการอ่าน JSON เหมือนดูแผนที่จะเปลี่ยนวิธีอ่าน payload ของคุณไปตลอด
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- JSON Formatter — จัดรูปและตรวจสอบ JSON ดิบให้พร้อมใช้
- jq Playground — ฝึกเขียน jq filter พร้อมเห็นผลลัพธ์ทันที
- JSON Schema Visualizer — สำรวจ properties, types และ references ของ schema แบบ interactive
สำรวจโครงสร้างก่อน แล้วค่อย query ทุก branch ใน JSON Graph Visualizer มีชื่อ มีที่อยู่ และมีขนาดของตัวเอง payload ไหนจึงไม่ต้องเป็นเขาวงกตของวงเล็บอีกต่อไป
คำถามที่พบบ่อย
ถ: ข้อมูล JSON ของฉันถูกอัปโหลดขึ้นเซิร์ฟเวอร์หรือไม่?
ตอบ: ไม่ครับ parsing และ rendering เกิดขึ้นในเบราว์เซอร์ทั้งหมด สิ่งที่คุณวางไม่ถูกส่ง เก็บ หรือ log ที่ใดเลย payload ภายในและตัวอย่างจาก production จึงสำรวจได้อย่างปลอดภัย
ถ: JSONPath-style path คืออะไรกันแน่?
ตอบ: คือ address แบบอ่านอย่างเดียวที่ประกอบจาก key และ index ระหว่าง root กับ node นั้น เช่น $.data.items[0].name คือฟิลด์ name ของ item แรกใน array items ภายใต้ data เครื่องมือสร้าง path ให้ทุก node โดยอัตโนมัติ คุณจึงคัดลอก reference ที่ถูกต้องแทนการเดาเอง
ถ: ต่างจาก JSON formatter อย่างไร?
ตอบ: formatter ช่วยเรื่อง raw text ส่วน tree เพิ่มการนำทาง โครงสร้าง และ address บน document ที่ parse แล้ว ทั้งสองเสริมกัน: format input ที่รกไว้ก่อน แล้วใช้ tree หาตำแหน่งและ path
ถ: text export มีอะไรในนั้นบ้าง?
ตอบ: outline ข้อความแบบเยื้องบรรทัดที่มีชื่อ branch, type และจำนวน children โดยไม่มีเครื่องหมายของ JSON ดิบ เหมาะกับ ticket, เอกสาร และแชท ที่บทสรุปโครงสร้างมีประโยชน์กว่า payload เต็ม