JSON Schema Faker: สร้าง mock data ที่สมจริงจาก JSON Schema ในเบราว์เซอร์
เรียนรู้วิธีใช้ JSON Schema Faker เปลี่ยน JSON Schema เป็น mock JSON ที่สมจริงและทำซ้ำได้ ด้วย seeded determinism, format-aware strings, การ resolve $ref และ example/default precedence — ทำงานในเบราว์เซอร์ทั้งหมด
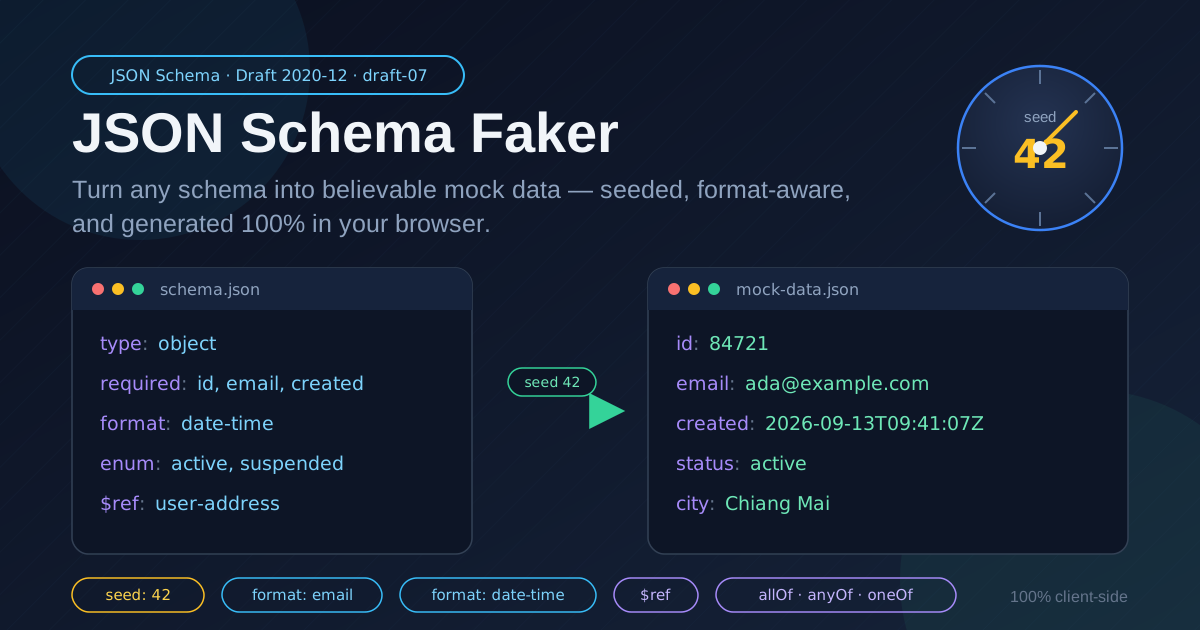
Table of Contents
JSON Schema Faker: สร้าง mock data ที่สมจริงจาก JSON Schema ในเบราว์เซอร์
ทีม frontend หลายทีมต้องเคยเจอสถานการณ์เดียวกัน: API contract ตกลงกันเรียบร้อยแล้ว คอมโพเนนต์ออกแบบเสร็จแล้ว แต่ backend ยังต้องรออีกหลายสัปดาห์ ระหว่างนั้น array กันชนอย่าง [{ id: 1 }, { id: 2 }] ที่วางไว้ในโค้ดไม่ได้บอกอะไรเลยว่า UI จริงจะทำงานอย่างไรเมื่อเจอชื่อผู้ใช้ timestamp หรือค่าขอบเขตต่าง ๆ JSON Schema Faker ปิดช่องว่างนี้ได้ทันที เพียงวาง JSON Schema — รองรับทั้ง Draft 2020-12, 2019-09 และ draft-07 — เครื่องมือจะสร้าง mock JSON ที่เคารพทุก type, constraint และ format ที่คุณประกาศไว้ โดยทำงานในเบราว์เซอร์ 100%
สิ่งที่แยก mock data ที่น่าเชื่อถือออกจากข้อมูลสุ่ม ๆ ก็คือความสมจริง ข้อความแบบ lorem ipsum อายุติดลบ หรือช่อง email ที่เต็มไปด้วยตัวอักษรมั่ว จะลอดผ่าน UI ไปได้จนกระทั่งข้อมูลจริงมาถึงแล้วทำให้พัง JSON Schema Faker อ่าน contract ที่คุณเขียนไว้แล้วสร้างข้อมูลที่เป็นไปตามนั้น: format: email ให้ที่อยู่อีเมลที่ดูน่าเชื่อ, minimum และ maximum จำกัดทุกตัวเลข, ค่า enum มาจากชุดที่อนุญาตเท่านั้น และฟิลด์ required ปรากฏเสมอ ทั้งหมดนี้เกิดขึ้นบนเครื่องคุณ ไม่มีข้อมูลใดถูกส่งขึ้นเซิร์ฟเวอร์
คู่มือนี้จะพาไปดูว่าทำไมการสร้างข้อมูลจาก schema จึงดีกว่าการเขียน fixture ด้วยมือ วิธีใช้เครื่องมือทีละขั้นตอน และรายละเอียดที่สำคัญเมื่อใช้งานจริงจัง: การ resolve $ref, composition keywords อย่าง allOf, anyOf, oneOf, example/default precedence และ seeded determinism เพื่อทำ test fixture ที่ทำซ้ำได้
ทำไมต้องใช้ JSON Schema Faker?
- Schema ของคุณคือ specification อยู่แล้ว คุณเขียน JSON Schema เพื่ออธิบาย payload อยู่แล้ว การสร้าง mock data จากมันหมายความว่า fixture จะไม่มีวันเหลื่อมกับ contract เมื่อ schema เปลี่ยน แค่ regenerate แทนการแก้ไฟล์ด้วยมือหลายสิบไฟล์
- Seeded determinism ทำให้ผลลัพธ์ทำซ้ำได้ seed เดิมให้ผลลัพธ์เดิมเสมอ คุณสมบัตินี้เพียงข้อเดียวเปลี่ยนข้อมูลที่สร้างจาก "ของสุ่มที่ดีบั๊กยาก" ให้เป็น test fixture ตัวจริงที่ commit, diff และ assert ได้
- Format-aware strings ดูสมจริง ฟิลด์ที่ระบุ email, date-time, uri หรือ uuid จะออกมาในรูปที่ถูกต้อง ทำให้ชั้น validation, formatter และ date picker ใน UI ได้ทดสอบกับค่าที่จะเจอจริงใน production
- Schema ซับซ้อนรองรับครบ ไม่ใช่แค่ตัวอย่างง่าย ๆ pointer $ref resolve ได้ทั่วทั้งเอกสาร และ composition แบบ allOf, anyOf, oneOf ถูกเข้าใจอย่างถูกต้อง ดังนั้น schema เชิงลึกที่ทีม API ส่งมาให้ก็ใช้ได้เลย
- ข้อมูลที่คุณประกาศไว้มีสิทธิ์ชนะ ถ้า property ระบุ example หรือ default ค่านั้นจะมาก่อนการสุ่ม ใช้จุดนี้ pin ฟิลด์ที่ UI พึ่งพา แล้วให้ตัว generator เติมส่วนที่เหลือ
- ไม่ต้องอัปโหลด ไม่ต้องติดตั้ง ไม่มี CLI ให้ลง ไม่มีการเรียกเซิร์ฟเวอร์ เปิดหน้าเว็บ วาง schema ปรับ seed แล้วคัดลอกผลลัพธ์ schema ที่มีชื่อฟิลด์ภายในก็ไม่เคยออกจากเบราว์เซอร์ของคุณ
ฟีเจอร์หลัก
| ฟีเจอร์ | ความหมายต่อการใช้งานของคุณ |
|---|---|
| รองรับ Draft 2020-12, 2019-09 และ draft-07 | ใช้กับ schema ใหม่และเก่าได้โดยไม่ต้องแปลงก่อน |
| Seeded determinism | seed เดิมให้ output เหมือนกันทุกไบต์ เหมาะกับ fixture ที่นิ่ง |
| Format-aware strings | email, date-time, uri และ format ทำนองเดียวกันให้ค่าที่สมจริง |
| Types, required และ enums | ข้อมูลที่สร้างเป็นไปตาม constraint ที่ประกาศเสมอ |
| ขอบเขตตัวเลข | เคารพ minimum, maximum และ exclusiveMinimum/exclusiveMaximum |
| การ resolve $ref | reference ภายใน resolve ได้ทั้งเอกสาร รวมถึง object ซ้อนกัน |
| allOf / anyOf / oneOf | composition keywords ถูกตีความ ไม่ถูกข้าม |
| example และ default precedence | ค่าที่ประกาศไว้มาก่อนการสุ่มเสมอ |
| ทำงาน client-side 100% | ประมวลผลในเบราว์เซอร์ ไม่มีการอัปโหลดหรือบันทึกข้อมูล |
บางฟีเจอร์ควรเน้นเป็นพิเศษ ประการแรก การควบคุม seed คือเส้นแบ่งระหว่าง "ข้อมูลสุ่มก้อนหนึ่ง" กับ "fixture" — ตั้ง seed หนึ่งครั้ง บันทึกไว้ในไฟล์ทดสอบ แล้วทุกคนในทีมจะได้ข้อมูลชุดเดียวกันเป๊ะ ๆ ประการที่สอง กฎ precedence ทำให้เครื่องมือนี้เป็นผู้ช่วยที่เข้าใจงานร่วมกัน ฟิลด์ที่คุณ pin ด้วย example จะอยู่นิ่งขณะที่รอบ ๆ เปลี่ยนไป ประการที่สาม เนื่องจากการสร้างทำงานในเครื่องทั้งหมด จึงปลอดภัยกับ schema ที่อ้างถึงระบบภายในหรือชื่อฟิลด์ที่เป็นความลับ
วิธีการใช้งาน
- เปิดเครื่องมือ เข้าไปที่หน้า JSON Schema Faker editor พร้อมใช้ทันทีตั้งแต่เปิดหน้า ไม่ต้องสมัคร ไม่ต้องตั้งค่า
- วาง JSON Schema ของคุณ วางได้ตั้งแต่ object เล็ก ๆ สอง property จนถึงเอกสารหลายร้อยบรรทัดที่มี definitions และ references เครื่องมือจำแนก Draft 2020-12, 2019-09 และ draft-07 ให้เองโดยอัตโนมัติ
- ตั้งค่า seed (ไม่บังคับแต่แนะนำ) ใส่ตัวเลขใดก็ได้เป็น seed เมื่อ schema เดิมผสมกับ seed เดิมจะได้ output เดิมเสมอ ซึ่งเป็นสิ่งที่คุณต้องการสำหรับ fixture ที่ commit ลง repo
- Generate และตรวจผลลัพธ์ กด generate แล้วอ่าน mock JSON ที่ได้ ตรวจว่าฟิลด์ required ครบ ค่า enum มาจากชุดที่อนุญาต string ที่มี format ดูสมจริง และ object ที่ถูก reference resolve ครบถ้วน
- คัดลอกหรือ regenerate นำผลลัพธ์ไปใส่ mock server, test suite หรือ component story ของคุณ อยากได้ชุดข้อมูลใหม่? เปลี่ยน seed ส่วน schema เปลี่ยนก็ regenerate เพื่อให้ fixture ตาม contract เสมอ
จาก Schema สู่ข้อมูลที่น่าเชื่อถือ
วิธีเข้าใจเครื่องมือนี้ที่ตรงที่สุดคือมองว่ามันเป็นตัวตีความ (interpreter) ของ schema คุณ ทุกโหนดจะถูกถามคำถามเดียวกัน: type ที่ประกาศคืออะไร, constraint ใดบังคับอยู่ และมีค่าที่ควรเคารพแทนการสุ่มขึ้นมาเองหรือไม่
Type และ constraint มาก่อน string ที่ไม่ระบุ format จะกลายเป็นคำที่อ่านได้ แต่พอเพิ่ม "format": "email" มันจะกลายเป็นอะไรแบบ [email protected] ตัวเลขเคารพ minimum และ maximum — ฟิลด์ age ที่กำหนดช่วง 18 ถึง 90 จะไม่มีวันติดลบ ค่า enum สุ่มจาก array enum เท่านั้น, property required ถูกปล่อยออกมาเสมอ และการซ้อนของ object เดินตาม properties ที่คุณนิยามไว้
จุดที่ generator ทั่วไปมักยอมแพ้คือ reference และ composition ที่นี่ pointer $ref resolve ภายในเอกสาร ดังนั้น definition ที่ใช้ร่วมกันอย่าง Address จะให้รูปทรงเดียวกันทุกที่ที่ใช้ allOf รวมทุก branch เป็น object เดียว, anyOf เลือกหนึ่ง branch และ oneOf เลือกเฉพาะหนึ่งอย่างที่ตรงเงื่อนไข นั่นแปลว่า schema API แบบที่พบจริง — ชนิดที่มี base type ต่อยอดด้วย composition — generate ได้ถูกต้องโดยไม่ต้องแปลงล่วงหน้า
ส่วน precedence คือชั้นสุดท้ายของความประณีต เมื่อ property ประกาศ example หรือ default ค่านั้นจะชนะการสุ่ม:
{
  "type": "object",
  "required": ["id", "email", "role"],
  "properties": {
    "id": { "type": "integer", "minimum": 1, "maximum": 99999 },
    "email": { "type": "string", "format": "email" },
    "role": { "type": "string", "enum": ["admin", "editor", "viewer"] },
    "joined": { "type": "string", "format": "date-time" }
  }
}
ด้วย seed 42 ตัว generator อาจให้ผลลัพธ์แบบนี้:
{
  "id": 84721,
  "email": "[email protected]",
  "role": "viewer",
  "joined": "2026-09-13T09:41:07Z"
}
ทุกฟิลด์เป็นไปตาม schema: id อยู่ในช่วง, email รูปแบบถูกต้อง, role มาจาก enum และ timestamp อ่านได้ในรูปแบบ ISO 8601 รันอีกครั้งด้วย seed เดิมจะได้ไบต์เดิมเป๊ะ เปลี่ยน seed เป็น 43 รูปทรงยังเหมือนเดิมแต่ค่าเปลี่ยน — เหมาะกับการสร้างชุด fixture ทั้งชุดจาก schema เดียว
ทำไมความทำซ้ำได้จึงสำคัญกับการทดสอบ? เพราะ fixture ที่ไม่นิ่งแย่กว่าไม่มี fixture เสียอีก การทดสอบที่พังทุกครั้งที่ generator บังเอิญสุ่มได้ชื่อที่มี apostrophe จะฝึกให้ทีมเมินกับความล้มเหลว seed-based generation ให้ทั้งความสมจริงของข้อมูลหลากหลายรูปแบบและความนิ่งของไฟล์ที่ commit ไว้ — บันทึก seed ไว้แล้ว fixture จะ deterministic เท่าข้อความลิเทอรัล แต่แค่เปลี่ยนตัวเลขหนึ่งตัวก็ได้ edge case ชุดใหม่เมื่อต้องการ
กรณีการใช้งานจริง
พัฒนา frontend ก่อน backend เสร็จ
ทีมแบบ contract-first อยู่กับสถานการณ์นี้ตลอด schema ตกลงแล้ว backend ยังห่างไกลอีกหลาย sprint แต่ UI ต้องการ payload ที่สมจริงตั้งแต่วันนี้ Generate mock response แบบมี seed, ต่อเข้ากับ mock server หรือ component harness แล้วสร้างทุกสถานะ — loading, loaded, empty, overflow — บนข้อมูลที่ตรงกับ contract ในอนาคต เมื่อ endpoint จริงมาถึงการสลับเป็นแค่เปลี่ยน URL ไม่ใช่เขียนใหม่ทั้งหมด
Test fixtures ที่ไม่สะดุด
การทดสอบแบบ integration ต้องการข้อมูลที่หลากหลายพอจะมีความหมายและนิ่งพอจะ assert ได้ การ generate ด้วย seed ให้ทั้งสองอย่าง: pin seed ไว้ใน CI เพื่อให้ทุกรันเห็น input ชุดเดียวกัน และถือว่า output เป็น fixture ที่มีเวอร์ชัน เมื่อ schema พัฒนาไป ก็ regenerate, รีวิว diff แล้วอัปเดต assertion อย่างตั้งใจ แทนการไล่ตามความล้มเหลวแบบสุ่ม
สภาพแวดล้อมสาธิตที่ดูเป็นจริง
เดโมที่ทุกฟิลด์เขียนว่า test test test ทำลายภาพลักษณ์สินค้าทันที Generate เอกสารสักสองสามชุดด้วย seed ต่างกัน ให้แต่ละชุดดูสมจริงและสอดคล้องกันภายใน แล้วโหลดเข้าฐานข้อมูลเดโมหรือ local environment ผู้มีส่วนเกี่ยวข้องจะเห็นชื่อ วันที่ และสถานะที่น่าเชื่อ โดยไม่มีใครต้องป้อนข้อมูลด้วยมือหรือแตะข้อมูล production
ตัวอย่างสำหรับเอกสาร API
เอกสารที่มีตัวอย่างว่างเปล่าหรือหน้าตาปลอม ๆ บั่นทอนความเชื่อมั่นต่อ API นั้น Generate ตัวอย่างจาก schema เดียวกับที่นิยาม endpoint วางลงในเอกสาร แล้วให้ทุกอย่าง sync กันอัตโนมัติ — schema เปลี่ยน ตัวอย่าง regenerate ผู้อ่านจึงเห็น payload ที่ validate ผ่านจริงเสมอ
แนวปฏิบัติที่ดี
- Pin seed เพื่อความนิ่งของการทดสอบ ทุกครั้งที่ข้อมูลที่สร้างถูกใช้ใน automated test หรือ fixture ที่ commit ให้บันทึก seed ไว้ข้าง ๆ และถือว่าคู่ของ schema-plus-seed คือแหล่งความจริงของ fixture นั้น
- รักษาความจริงใจของ schema เครื่องมือสมจริงได้เท่ากับ contract ที่ให้ไป เพิ่มรายการ required, enum, ขอบ minimum/maximum และ format ในจุดที่มันเป็นจริง — ทุก constraint ที่ประกาศคือ output ที่ไม่สมจริงอีกหนึ่งประเภทที่ถูกกำจัดไป
- ใช้ format เพื่อ string ที่สมจริง การกำกับฟิลด์ว่าเป็น email, date-time, uri หรือ uuid ยกระดับผลลัพธ์จาก "string อะไรก็ได้" เป็น "string ที่โค้ดคุณ parse ได้" ต้นทุนแค่ keyword เดียวต่อฟิลด์
- เลือก example และ default สำหรับค่าที่รับน้ำหนักงาน ถ้าหน้าจอไหนแสดงฟิลด์ใดเด่นเป็นพิเศษ ให้ pin ด้วย example เพื่อให้ภาพหน้าจอและเดโมนิ่ง แล้วปล่อยให้ generator ทำส่วนอื่นให้หลากหลาย
- Regenerate หลัง schema เปลี่ยน ทำให้การ regenerate เป็นส่วนหนึ่งของ definition-of-done สำหรับการเปลี่ยน contract fixture ที่สร้างจาก schema เก่ากำลังทดสอบ payload ที่ API ไม่ผลิตอีกต่อไปโดยที่คุณไม่รู้ตัว
- รีวิวข้อมูลที่สร้างก่อนนำไปใช้ deterministic ไม่ได้แปลว่าเหมาะสมกับบริบทเสมอไป สแกนผลลัพธ์หนึ่งรอบเพื่อหาค่าที่อาจดูแปลกในโดเมนของคุณ แล้วปรับ seed หรือเพิ่ม constraint ตามจำเป็น
ลองใช้เลย
หยุดเขียน fixture ด้วยมือได้แล้ว เปิด JSON Schema Faker วาง schema จาก API contract ล่าสุดของคุณ ตั้ง seed ที่จำได้ แล้วคัดลอก mock data ระดับ production ภายในไม่กี่วินาที และอย่าลืมใช้ JSON Schema Visualizer ช่วยตรวจโครงสร้างของ schema ก่อน generate ด้วย
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- OpenAPI to TypeScript Converter — แปลง OpenAPI specification เป็น TypeScript interface ที่มี type ครบ ใช้คู่กับ mock data ที่สร้างได้อย่างลงตัว
- JSON Schema Visualizer — เรนเดอร์ schema ที่ซับซ้อนเป็นแผนภาพที่อ่านง่าย เพื่อรีวิวโครงสร้างก่อนสร้าง fixture
- JSON Formatter — จัดรูปแบบ ตรวจสอบ และย่อ JSON ที่สร้างได้ก่อน commit ลงโปรเจกต์
ขอให้ fixture ของคุณสมจริง และการทดสอบของคุณเขียวขจีตลอดไป
คำถามที่พบบ่อย
ถ: เครื่องมือรองรับ JSON Schema draft รุ่นใดบ้าง?
ตอบ: รองรับทั้ง Draft 2020-12, Draft 2019-09 และ draft-07 ในกรณีส่วนใหญ่คุณวาง schema ได้เลยโดยไม่ต้องแปลง generator เข้าใจ keyword ของแต่ละ draft รวมถึงของใหม่อย่างการย้ายตำแหน่ง definitions ใน 2020-12 และ array แบบ prefixItems
ถ: Seeded determinism ทำงานอย่างไร?
ตอบ: generator ใช้ seed ของคุณเป็นจุดเริ่มของการสุ่มทุกครั้ง ลำดับค่าที่ถูกสร้างจึงถูกกำหนดล่วงหน้าด้วยคู่ของ schema และ seed schema เดิมกับ seed เดิมให้ผลลัพธ์เหมือนกันทุกครั้งและทุกเครื่อง ซึ่งทำให้ข้อมูลที่สร้างปลอดภัยที่จะใช้เป็น test fixture ที่ commit ลง repo
ถ: ถ้า property มีทั้ง example และ default จะเกิดอะไรขึ้น?
ตอบ: ค่าที่ประกาศไว้จะมาก่อนการสุ่มเสมอ ถ้า property ระบุ example ไว้ generator จะปล่อยค่า example นั้นออกมา ถ้าไม่มีจะถอยไปใช้ default เมื่อมีการระบุไว้ และจะสุ่มค่าที่ถูกต้องตาม type, constraint และ format ขึ้นมาเองก็ต่อเมื่อไม่มีทั้งสองอย่าง
ถ: รองรับ schema ขนาดใหญ่ที่มี $ref และ composition keywords ได้หรือไม่?
ตอบ: ได้ pointer $ref ภายใน resolve ได้ทั่วทั้งเอกสาร รวมถึงการอ้างถึงระหว่าง definitions, allOf รวมทุก branch เข้าด้วยกัน ส่วน anyOf และ oneOf เลือก branch ที่ตรงเงื่อนไข schema API จริงที่ซ้อนกันลึกจึง generate ได้ถูกต้องโดยไม่ต้องเตรียมการเพิ่ม
ถ: schema ของฉันถูกอัปโหลดไปที่ใดหรือไม่?
ตอบ: ไม่ การสร้างทำงานในเบราว์เซอร์ของคุณทั้งหมดด้วย JavaScript ฝั่ง client schema และผลลัพธ์ที่สร้างไม่เคยออกจากเครื่อง จึงใช้กับ API contract ที่เป็นข้อมูลภายในหรือความลับได้อย่างมั่นใจ