JSONL Validator: ตรวจสอบและแก้ไขบรรทัดที่พังในไฟล์ JSONL
Validate ไฟล์ JSONL และ NDJSON ทีละบรรทัด ระบุบรรทัดที่พังพร้อมเลข line และแปลงเรคคอร์ดที่ผ่านเป็น JSON array สะอาด - ฟรีและทำงานบนเบราว์เซอร์ 100%
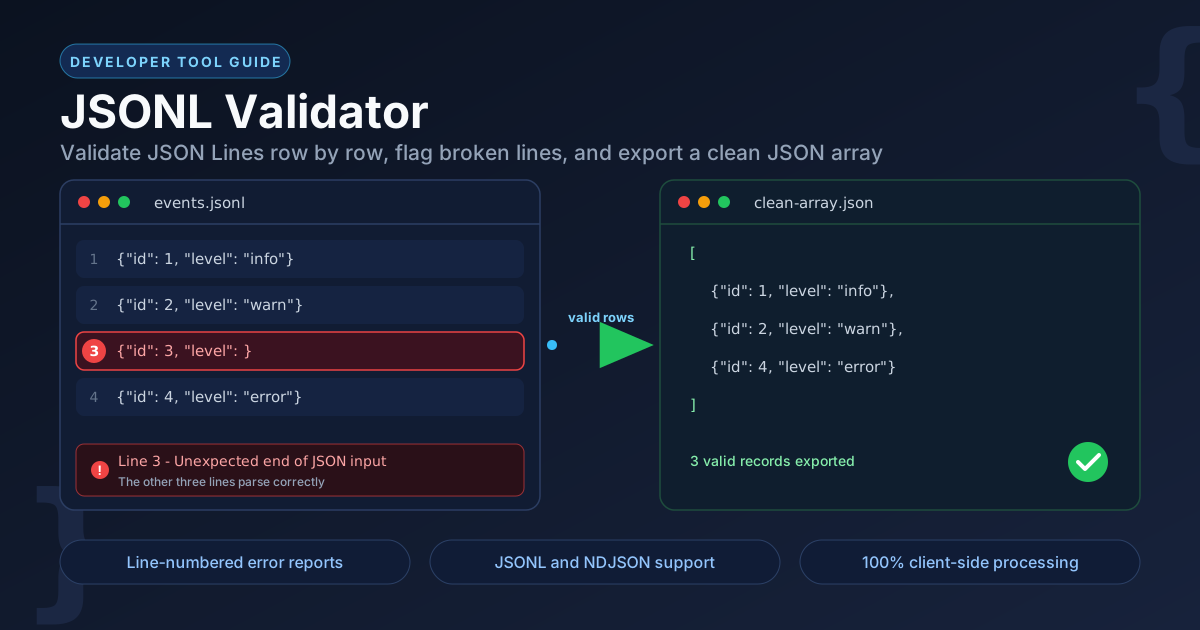
Table of Contents
JSONL Validator: ตรวจสอบและแก้ไขบรรทัดที่พังในไฟล์ JSONL
โครงสร้างพื้นฐานด้าน machine learning และ data สมัยใหม่จำนวนมากใช้ JSON ในรูปแบบเฉพาะอย่างหนึ่งคือ JSON Lines ไม่ว่าจะเป็น OpenAI ที่กำหนดให้ไฟล์สำหรับ fine-tuning และ batch ต้องเป็น JSONL, stream processor อย่าง Kafka และ Spark ที่อ่านเรคคอร์ดแบบ newline-delimited หรือระบบ structured logging ที่เขียน JSON object หนึ่งตัวต่อหนึ่ง line รูปแบบนี้เรียบง่ายมาก จนกระทั่งมีบรรทัดที่ JSON พังแทรกเข้ามาหนึ่ง line เพราะ parser จะหยุดที่ syntax error ตัวแรก ทำให้ไฟล์ที่มีเรคคอร์ดดีหลายพัน line ดูใช้งานไม่ได้ทั้งไฟล์ และนั่นคือเหตุผลที่เครื่องมือฟรี JSONL Validator ถูกสร้างขึ้นมา
ใครเคยลองวางไฟล์ JSONL ลง parser ธรรมดาจะรู้ดีว่าน่าหงุดหงิดแค่ไหน คุณจะได้แค่ข้อความกำกวมหนึ่งประโยคเรื่อง unexpected token โดยไม่รู้เลยว่าบรรทัดไหนใน 40,000 line เป็นตัวการ JSONL Validator เลือกทางที่ต่างออกไป นั่นคืออ่านไฟล์ตามที่ JSONL ถูกออกแบบไว้จริง ๆ คือทีละ line แล้วรายงานทุกบรรทัดที่พังแยกกัน พร้อมเลข line และ parser error ที่เกิดขึ้น
เครื่องมือนี้ยังเข้าใจความจริงของข้อมูลที่ไม่สมบูรณ์ คือเรามักอยากเก็บเรคคอร์ดที่ดีไว้ต่อ แม้บาง line จะเสียจนแก้ไม่ไหว ตัวเครื่องมือจะแปลงทุก row ที่ valid เป็น JSON array มาตรฐานที่คุณ copy หรือ download ได้ ส่วนบรรทัดที่พังจะถูก flag แยกไว้ และทั้งหมดทำงานแบบ client-side 100% ข้อมูล training และ log ที่เป็นความลับจึงไม่เคยออกจากเครื่องของคุณ
ทำไมต้องใช้ JSONL Validator?
- รายงาน error พร้อมเลข line แม่นยำ แทนที่จะได้ข้อความ parser กำกวมเพียงประโยคเดียว คุณจะเห็นเลข line ที่ชัดเจนและรายละเอียด error ของทุกบรรทัดที่พัง ทำให้แก้เสร็จในไม่กี่วินาทีแทนที่จะเป็นหลายชั่วโมง
- รองรับทั้ง JSONL และ NDJSON newline-delimited JSON มีสองชื่อเรียกแต่รูปร่างเดียวกัน เครื่องมือนี้ parse ทั้งสองแบบเหมือนกันคือหนึ่ง JSON value ต่อหนึ่ง line
- ช่วยเหลือส่วนที่ยังดูได้ ไม่ใช่แค่ผ่านหรือไม่ผ่านทั้งไฟล์ เพราะเรคคอร์ดที่ valid จะถูกรวบรวมและ export เป็น JSON array ได้ทันที แม้บรรทัดอื่นจะยังพังอยู่
- ออกแบบมาสำหรับไฟล์ใหญ่ การ parse แบบ row by row ทำให้เครื่องมือทำงานได้เสถียรกับไฟล์ขนาดใหญ่ ประมวลผลเรคคอร์ดไปเรื่อย ๆ ตามที่อ่านเจอ
- เป็นส่วนตัว 100% ทุกอย่าง validate ในเบราว์เซอร์ของคุณ ไม่มีการ upload ไม่มีการสมัครสมาชิก และไม่มีการประมวลผลข้อมูลบนเซิร์ฟเวอร์
- ไม่ต้องติดตั้งอะไรเลย เปิดหน้าเว็บ วางไฟล์หรือลากไฟล์มาวาง แล้วดูผลลัพธ์ได้ทันที ทั้งหมดนี้ฟรี
ฟีเจอร์หลัก
| ฟีเจอร์ | สิ่งที่ทำ |
|---|---|
| Validate แบบ row by row | Parse แต่ละ line เป็น JSON value อิสระ เหมือนวิธีที่ระบบที่ใช้ JSONL อ่านไฟล์จริง |
| Flag บรรทัดที่พังพร้อมเลข line | ไฮไลต์บรรทัดที่พังพร้อมเลข line และข้อความ parser error ที่แท้จริง |
| Export เรคคอร์ดที่ผ่าน | แปลงทุก line ที่ parse ได้เป็น JSON array มาตรฐาน พร้อม copy หรือ download |
| รองรับ NDJSON | อ่านไฟล์ NDJSON (newline-delimited JSON) ด้วย parser ตัวเดียวกัน |
| ประมวลผลฝั่ง client-side | ทำงานทั้งหมดในเบราว์เซอร์ของคุณ 100% |
รายละเอียดที่ควรรู้เพิ่มเติม:
- ข้อความ error มาจาก JSON parser โดยตรง จึงบอกปัญหาจริงได้ เช่น unexpected token, unterminated string หรือ closing brace ที่หายไป
- JSON array ที่ได้จะรักษาลำดับของ line ที่ valid ตามต้นฉบับ ลำดับเรคคอร์ดจึงไม่ถูกรบกวน
- เนื่องจากเครื่องมือไม่ส่งข้อมูลไปเซิร์ฟเวอร์ จึงปลอดภัยกับ dataset ลับ ข้อมูล log ของลูกค้า และไฟล์ export ภายในองค์กร
วิธีใช้งาน
- เปิดเครื่องมือ เข้าไปที่หน้า JSONL Validator ด้วยเบราว์เซอร์สมัยใหม่ตัวไหนก็ได้
- วางหรือลากไฟล์ วางข้อความ JSONL ลงในช่อง input หรือลากไฟล์ .jsonl หรือ .ndjson มาวางลงไปตรง ๆ
- ดูรายงานผล บรรทัดที่พังจะถูก flag เป็นสีแดงพร้อมเลข line และรายละเอียด error พร้อมสรุปว่ามีกี่ line ที่ parse ผ่าน
- Export ข้อมูลที่ดี copy หรือ download JSON array ของเรคคอร์ดที่ valid เพื่อใช้กับเครื่องมือที่ต้องการ JSON มาตรฐาน
- แก้แล้ว validate ซ้ำ แก้บรรทัดที่ถูก flag ในไฟล์ต้นฉบับ แล้ว validate อีกครั้งจนกว่ารายงานจะสะอาด
หนึ่งเรคคอร์ดต่อหนึ่งบรรทัด: หลักการทำงานของ JSONL และ NDJSON
JSONL (JSON Lines) และ NDJSON (Newline-Delimited JSON) หมายถึงแนวคิดเดียวกัน แทนที่จะเก็บ JSON document ใหญ่ไฟล์เดียว ไฟล์จะเก็บ JSON value หนึ่งตัวต่อหนึ่ง line โดยใช้ตัวอักษร newline เป็นตัวคั่น ไฟล์ที่ปกติดีจะหน้าตาแบบนี้:
{"user": "ana", "action": "login", "ok": true}
{"user": "bo", "action": "click", "ok": true}
{"user": "cy", "action": "submit", "ok": true}
ทีนี้ลองนึกภาพ export job ล่มกลางทางแล้วทิ้งเรคคอร์ดที่ถูกตัดขาดไว้หนึ่ง line:
{"user": "dee", "action": "submit", "ok": }
parser ธรรมดาจะอ่านทั้งไฟล์เป็น document เดียวแล้วยอมแพ้ทันที แต่ validator แบบ line-oriented ทำสิ่งที่มีประโยชน์กว่ามาก นั่นคือแยกจุดที่พังออกมาแล้วรายงานว่า Line 4: Unexpected token } ขณะที่ทุก line อื่นยังถือว่า valid
แล้วทำไมรูปแบบนี้ถึงมีอยู่จริง? มีเหตุผลเชิงปฏิบัติสามข้อ:
- Streaming ผู้ใช้สามารถประมวลผลเรคคอร์ดทีละตัวขณะข้อมูลไหลเข้ามา โดยไม่ต้องรอวงเล็บปิดท้ายที่อาจอยู่ไกลหลายกิกะไบต์
- เขียนแบบ append-only ระบบ log เขียน line ใหม่ต่อ event หนึ่งอัน การ append ถูกและทนต่อการล่ม ส่วนการเขียน array ยักษ์ใหม่ทั้งก้อนทุกครั้งที่มีเรคคอร์ดใหม่นั้นไม่ใช่
- ไฟล์ขนาดใหญ่ ไฟล์แบบตาม line แบ่งข้าม worker, shard และ chunk ของ network ได้อย่างสะอาด ซึ่งเป็นสิ่งที่ big-data และ ML pipeline ต้องการพอดี
ข้อแลกเปลี่ยนคือเครื่องมือปลายทางจำนวนมากอยากได้ JSON document แบบมาตรฐาน จุดนี้เองที่ขั้นตอน export เข้ามาช่วย JSONL Validator จะรวบรวมทุก row ที่ valid เป็น JSON array มาตรฐาน ซึ่ง spreadsheet, dashboard และ HTTP API ส่วนใหญ่รับได้ทันที:
[
  { "user": "ana", "action": "login", "ok": true },
  { "user": "bo", "action": "click", "ok": true },
  { "user": "cy", "action": "submit", "ok": true }
]
กรณีการใช้งานจริง
เตรียมข้อมูลสำหรับ LLM training
endpoint สำหรับ fine-tuning กำหนดให้ JSONL ต้อง valid อย่างเคร่งครัด หนึ่งตัวอย่างต่อหนึ่ง line ไม่มีข้อยกเว้น เรคคอร์ดที่พังเพียง record เดียวอาจทำให้การ upload ทั้งไฟล์ถูกปฏิเสธและเสียรอบการทำงานที่มีค่าใช้จ่าย ให้ validate ทุกไฟล์ training ก่อน upload เสมอ แล้วค่อยแก้เฉพาะ line ที่ถูก flag
ดีบักไฟล์ log
structured log ในทางปฏิบัติคือไฟล์ JSONL และมันพังในรูปแบบที่คาดเดาได้ เช่น process ล่มกลางการเขียนจนเหลือ line ที่ถูกตัดขาด หรือข้อความ log ที่มี newline จริง ๆ ใน field ทำให้หนึ่งเรคคอร์ดแตกเป็นสองเรคคอร์ดที่ invalid รายงานพร้อมเลข line จะชี้ไปที่เรคคอร์ดที่พังได้ในไม่กี่วินาที
ตรวจสอบจุดต่อของ ETL pipeline
ก่อนนำไฟล์ staging เข้า warehouse หรือ API ให้ validate ที่จุดต่อเสมอ การ validate แบบ row by row จะจับ format drift จากต้นน้ำได้ เช่น field ใหม่ที่แทรกเข้ามา, export ที่เสีย หรือปัญหา encoding ก่อนที่มันจะกลายเป็น load job ที่ล้มเหลวหลังจากนั้นเป็นชั่วโมง
ทำความสะอาด dataset
dataset จากการ scrape หรือการ merge แทบจะมี row ที่พังเสมอ validate ไฟล์ดังกล่าว ทิ้งหรือแก้บรรทัดที่ถูก flag แล้ว export เรคคอร์ดที่สะอาดเป็น JSON array เพื่อนำไปวิเคราะห์หรือ import ต่อที่อื่น
แนวปฏิบัติที่ดี
- แก้ error แรกแล้ว validate ซ้ำ error ถัด ๆ ไปอาจเกิดจาก error แรกเป็นตัวต้นเหตุ ปัญหาช่วงต้นของ line หนึ่งอาจแฝงมาเป็นความล้มเหลวหลายจุดข้างหลัง ให้แก้จากบนลงล่างและ validate ระหว่างรอบ
- อย่ามีบรรทัดว่าง blank line ไม่ใช่ JSON value ที่ valid จึงถูก flag เกือบทุก validator ควรลบบรรทัดว่างท้ายไฟล์ออกก่อน validate หรือ upload
- Validate ก่อน upload เข้า API training endpoint และ ingestion API มักปฏิเสธทั้งไฟล์เมื่อเจอ line ที่พังเพียง line เดียว การใช้เวลาตรวจ 30 วินาทีช่วยประหยัดรอบ upload ที่ล้มเหลวได้
- หนึ่งเรคคอร์ดต่อหนึ่ง line เท่านั้น อย่า pretty-print ไฟล์ JSONL ลงในไฟล์เดิมเด็ดขาด เพราะเรคคอร์ดหลายบรรทัดจะทำให้ format พัง ถ้าอยากดูรายละเอียดเรคคอร์ดไหน ให้ format สำเนาแทน
- ระวัง string ที่มี newline line break จริง ๆ ภายใน string จะแยกหนึ่งเรคคอร์ดเป็นสองเรคคอร์ด ให้ escape เป็น \n ในข้อมูลต้นทาง
- Export ส่วนที่สะอาดออกมาก่อน เก็บเรคคอร์ดที่ valid ไว้ทันที แล้วค่อยกลับมาแก้บรรทัดที่พังแยกต่างหากตามจังหวะของคุณ
พร้อมจัดการไฟล์ JSONL ของคุณแล้วหรือยัง?
ไม่ว่าคุณจะกำลังเตรียม dataset สำหรับ fine-tuning ตามหา log line ที่พัง หรือตรวจการส่งมอบงานระหว่าง pipeline JSONL Validator ให้คำตอบที่แม่นยำถึงระดับ line ภายในไม่กี่วินาที ทำงานในเบราว์เซอร์ของคุณโดยตรงและไม่มีการ upload ข้อมูลไปที่ใด ลองวางไฟล์ของคุณลงไปแล้วดูว่า line ไหนต้องแก้บ้าง
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- JSON Formatter — จัดรูปแบบ, minify และ validate JSON document ทั่วไป
- MongoDB ObjectId Decoder — ถอด timestamp และข้อมูลเครื่องจาก MongoDB ObjectId
- CSV to JSON Converter — แปลงไฟล์จาก spreadsheet เป็น JSON record ที่มีโครงสร้าง
ขอให้สนุกกับการ validate ข้อมูลครับ
คำถามที่พบบ่อย
ถ: JSONL กับ NDJSON ต่างกันอย่างไร?
ตอบ: ในทางปฏิบัติแทบไม่ต่างกันเลย ทั้งคู่หมายถึง JSON value หนึ่งตัวต่อหนึ่ง line โดยคั่นด้วยตัวอักษร newline JSON Lines เป็นชื่อตามธรรมเนียมของ jsonlines.org ส่วน NDJSON เป็นชื่อตาม specification ของ newline-delimited JSON เครื่องมือที่รับแบบหนึ่งมักรับอีกแบบได้ด้วย และ validator ตัวนี้ parse ทั้งสองแบบเหมือนกัน
ถ: เครื่องมือนี้ upload ข้อมูลของฉันขึ้นเซิร์ฟเวอร์หรือไม่?
ตอบ: ไม่ การ validate ทำงานแบบ client-side 100% ในเบราว์เซอร์ของคุณด้วย JavaScript ไฟล์ของคุณไม่ถูกส่ง เก็บ หรือ log ที่ใดเลย เครื่องมือจึงปลอดภัยกับข้อมูล training ที่เป็นความลับและ log จากระบบ production
ถ: บรรทัดที่พังจะเป็นอย่างไรเมื่อ export?
ตอบ: จะถูกข้ามไป JSON array ที่ export ออกมาจะมีเฉพาะเรคคอร์ดที่ parse สำเร็จตามลำดับเดิม ส่วนรายงานจะยังชี้บรรทัดที่พังให้ต่อไป เพื่อให้คุณกลับไปแก้ในไฟล์ต้นฉบับได้
ถ: มีขีดจำกัดขนาดไฟล์หรือไม่?
ตอบ: ไม่มีขีดจำกัดตายตัว แต่เนื่องจากการ parse เกิดขึ้นในเบราว์เซอร์ หน่วยความจำที่มีจึงเป็นเพดานในทางปฏิบัติ ไฟล์ที่มีเรคคอร์ดสั้น ๆ หลายแสน line มักประมวลผลได้สบายบนเครื่องสมัยใหม่