LLM Context Packer: บริหาร Context Window ให้พอดีในหนึ่งพรอมป์
LLM Context Packer ช่วยแพ็กไฟล์และข้อความลง context window พร้อมตัวเลขประมาณการ token รายไฟล์ ปุ่มเปิด-ปิดรายไฟล์ และ bundle แบบ XML tag ที่พร้อมวางลงแชทได้ทันที
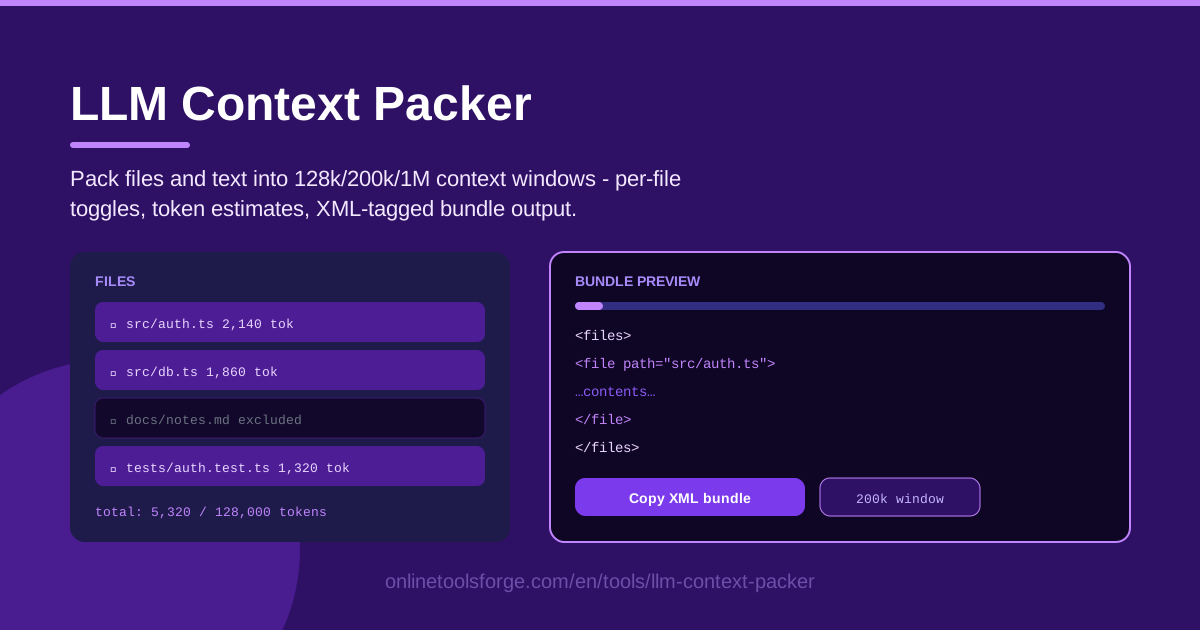
Table of Contents
นักพัฒนาที่ทำงานร่วมกับ AI ต้องเคยเจอพิธีกรรมเดิม ๆ: คำตอบที่ต้องการอยู่ในโค้ด แต่ช่องแชทรับได้แค่สิ่งที่วางลงไป ก็อปปี้ไฟล์ทีละไฟล์ วางจนชนเพดาน token ที่มองไม่เห็น แล้วหวังว่าโมเดลจะเติมช่องว่างที่เหลือเอง LLM Context Packer เกิดมาเพื่อปิดเกมการเดาแบบนี้
เครื่องมือนี้ให้คุณเพิ่มไฟล์และ text snippet เลือกขนาด context window — 128k, 200k หรือ 1M token — แล้วเปิด-ปิดไฟล์รายไฟล์ได้ในคลิกเดียว ระหว่างประกอบ bundle เครื่องมือจะประมาณจำนวน token ทั้งรายไฟล์และยอดรวม แล้วสร้าง bundle แบบ XML tag ที่พร้อมวางลงหน้าแชทไหนก็ได้ทันที
บทความนี้จะพาไปดูว่าทำไมการแพ็ก context อย่างตั้งใจจึงสำคัญ วิธีใช้เครื่องมือทีละขั้นตอน และวิธีเปลี่ยนมุมมองว่า context window คืองบประมาณที่ต้องบริหารจริง ๆ
ทำไมต้องใช้ LLM Context Packer?
- ใส่โค้ดทั้งโปรเจกต์ลงในพรอมป์เดียว — แทนที่จะวางสามไฟล์แล้วอธิบายไฟล์ที่สี่ด้วยคำพูด ให้แพ็กทั้งโมดูล หรือด้วย window 1M token แพ็กทั้งโปรเจกต์ขนาดเล็กลงในพรอมป์เดียวที่โมเดลไล่อ่านได้จริง
- เลิกเดาจำนวน token — การจ้องประเมินว่าสี่สิบไฟล์จะพอหรือเปล่าเป็นเกมที่แพ้ตั้งแต่ต้น ตัวเลขประมาณการรายไฟล์และยอดรวมบอกตำแหน่งปัจจุบันเทียบกับ window ที่เลือกไว้เสมอ
- คัดเฉพาะสิ่งที่โมเดลต้องเห็น — ปุ่มเปิด-ปิดรายไฟล์ช่วยตัดโค้ดที่ generate มา ไฟล์ fixture ใหญ่ ๆ และโฟลเดอร์ที่ไม่เกี่ยวข้อง โดยไม่ต้องสร้าง bundle ใหม่
- ให้เขตแดนที่ชัดเจนด้วย XML tag — tag บอกจุดเริ่มและจุดจบของแต่ละไฟล์ ลดปัญหาคลาสสิกที่โมเดลเอาโค้ดจากไฟล์หนึ่งไปยุบรวมกับอีกไฟล์หนึ่ง
- โค้ดอยู่กับเบราว์เซอร์ของคุณ — เครื่องมือทำงานฝั่ง client ล้วน ๆ ไม่มีการอัปโหลดขึ้นเซิร์ฟเวอร์ใด ๆ
- เปลี่ยนโมเดลโดยไม่ต้องเริ่มใหม่ — เลือกขนาด window ใหม่ แล้วงบประมาณจะคำนวณใหม่ให้ทันที
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| เพิ่มไฟล์และข้อความ | ใส่ไฟล์ซอร์สโค้ดและ text snippet อิสระ เช่น โน้ต, stack trace หรือคำสั่งให้โมเดล ลงใน bundle เดียวกัน |
| เลือกขนาด context window | เลือก 128k, 200k หรือ 1M token ให้ตรงกับโมเดลที่จะใช้ |
| เปิด-ปิดรายไฟล์ | คลิกเดียวเพิ่มหรือตัดไฟล์ใดก็ได้ แล้วดูยอดรวมอัปเดตทันที |
| ประมาณการ token | เห็นจำนวน token โดยประมาณของทุกไฟล์ พร้อมยอดวิ่งเทียบกับงบที่ตั้งไว้ |
| bundle แบบ XML tag | สร้าง bundle พร้อมวาง โดยมี tag ครอบแต่ละไฟล์อย่างชัดเจน |
| ทำงานในเบราว์เซอร์ | ทุกอย่างเกิดขึ้นในเครื่อง ไม่ต้องสมัคร ไม่อัปโหลด ไม่มีค่าใช้จ่าย |
จุดที่ควรรู้เพิ่มเติม:
- ประมาณการใช้สูตรเร็วที่จูนมาสำหรับโค้ดและข้อความ แม่นพอสำหรับการวางงบ เพราะตัวเลขเป๊ะ ๆ ต่างกันเล็กน้อยระหว่าง tokenizer ของแต่ละโมเดล
- text snippet และไฟล์อยู่เคียงกันใน bundle โดยแยกเป็น section ที่มี tag ของตัวเอง รายงานบั๊กหรือคำอธิบายงานจึงอยู่ติดกับโค้ดที่มันเกี่ยวข้อง
วิธีใช้ LLM Context Packer
- เพิ่มไฟล์และข้อความ — ใส่ไฟล์ซอร์สโค้ดที่เกี่ยวกับงาน แล้วเพิ่ม text snippet เช่น ข้อความ error, รายงานบั๊ก หรือคำสั่งที่ต้องการให้โมเดลทำตาม
- เลือกขนาด context window — ตั้งเป็น 128k, 200k หรือ 1M token ให้ตรงกับโมเดลเป้าหมาย
- เปิด-ปิดรายไฟล์ — ไล่ลงรายการแล้วตัดสิ่งที่งานไม่ต้องใช้ ทั้งโค้ดที่ generate ไฟล์เวอร์ชันเก่า และโมดูลที่ไม่เกี่ยวข้อง
- จับตาดู token budget — ตัวเลขรายไฟล์และยอดรวมบอกว่าใช้ window ไปแล้วเท่าไร และเหลือที่ว่างอีกเท่าไร
- คัดลอก XML bundle — คลิกเดียวได้ bundle ที่แท็กครบ พร้อมวางไว้ต้นแชท
Context Window คืองบประมาณที่ต้องบริหาร
มอง context window เป็นงบประมาณคงที่ที่ต้องจ่ายทุกพรอมป์ ทุกไฟล์ ทุกคอมเมนต์ และทุกช่องว่าง ล้วนหักจากบัญชีเดียวกัน และสิ่งที่โมเดลเขียนตอบก็หักจากงบนี้เช่นกัน การแพ็กให้ดีจึงแทบหมายถึงการจ่ายงบให้กับ token ที่เปลี่ยนคำตอบจริง ๆ เท่านั้น
แล้วอะไรพออยู่ใน window? ขนาด 128k token จุข้อความภาษาอังกฤษได้ราว 90,000-100,000 คำ แต่โค้ดกิน token ต่อความยาวมากกว่า ในทางปฏิบัติจึงจุโมดูลขนาดกลางได้สบาย ๆ ประมาณ 40-60 ไฟล์ซอร์สทั่วไป ที่ 200k คุณหอบ src ทั้งไดเรกทอรีของโปรเจกต์เล็กมาได้ รวมถึงเทสต์ด้วย ส่วน 1M พาทั้งโปรเจกต์ขนาดเล็กถึงกลางมาได้เลย ทั้งซอร์ส เทสต์ และเอกสาร พร้อมที่ว่างเหลือให้คิด
ตัวเลขประมาณการสำคัญเพราะการล้น window มักไม่มีเสียงเตือน เมื่อพรอมป์เกินลิมิต หลายอินเทอร์เฟซตัดท้ายเงียบ ๆ แปลว่าไฟล์ที่วางท้ายสุดอาจไม่เคยถูกอ่านเลย แม้ยังไม่ชนลิมิตจริง คุณภาพคำตอบก็ดิ่งลงเมื่อ context ยาวมาก ๆ เพราะ attention เริ่มบาง การเห็นตัวเลขแบบเรียลไทม์ช่วยให้คุณหยุดก่อนหน้าผา
ทุก token ไม่เท่ากัน ซอร์สโค้ดสมควรได้ที่อันดับแรกเพราะเป็นความจริงที่ตรงที่สุด เทสต์มาเป็นอันดับสอง เพราะบอกเจตนาและพฤติกรรมที่คาดหวังในรูปแบบที่โมเดลใช้ตรรกะวิเคราะห์ได้ ส่วนเอกสารมาท้ายสุด เพราะมักล้าสมัยและเดาได้เยอะจากโค้ดอยู่แล้ว สำหรับทุกไฟล์ให้ถามคำถามเดียว: ถ้าไม่มีไฟล์นี้ คำตอบจะเปลี่ยนจริงหรือไม่ ถ้าไม่เปลี่ยนก็ตัดทิ้ง
โครงสร้างก็คุ้มค่า token เช่นกัน การครอบแต่ละไฟล์ด้วย XML tag ให้เขตแดนที่ไม่มีทางกำกวม โมเดลรู้ว่าไฟล์ไหนจบตรงไหน อ้างชื่อ path กลับมาให้คุณได้ และมีโอกาสน้อยมากที่จะเอาโค้ดข้ามไฟล์มายำรวมกัน และอย่าลืมเว้นที่ให้คำตอบ: ถ้ายัดโค้ด 126k ใน window 128k คุณจะได้คำตอบสั้น ๆ ตื้น ๆ ตั้งเป้าใช้ราว 80% ของ window แล้วปล่อยที่เหลือให้โมเดลใช้คิดและเขียนคำตอบ
ตัวอย่างการใช้งานจริง
รีวิวโค้ดทั้งโมดูลในพรอมป์เดียว
แพ็กทุกไฟล์ในโมดูลที่จะรีวิว เติม text snippet สั้น ๆ อธิบายว่าโมดูลนี้ทำหน้าที่อะไร แล้วขอรีวิวแบบมีโครงสร้าง เพราะโมเดลเห็นทุก call site พร้อมกัน จึงจับปัญหาข้ามไฟล์ได้ เช่น การจัดการ error ที่ไม่สอดคล้อง ตรรกะซ้ำซ้อน หรือฟังก์ชันสาธารณะที่มี caller คนหนึ่งเรียกสวน contract ซึ่งการรีวิวทีละไฟล์มักพลาดเสมอ
แพ็กเอกสารและโค้ดไว้ถาม-ตอบ
รวม README และเอกสาร API เข้ากับไฟล์ซอร์สที่มันอธิบาย แล้วถามคำถามสำหรับคนเพิ่งเข้าทีม เช่น authentication ไหลผ่านระบบอย่างไร, rate limiting ถูกบังคับตรงไหน หรือเมื่อ webhook ล้มเหลวแล้วเกิดอะไรขึ้น การให้คำตอบยึดทั้งเอกสารและโค้ดช่วยเผยจุดที่เอกสารขัดกับความเป็นจริง
Context Pack สำหรับรายงานบั๊ก
วาง stack trace เป็น text snippet ใส่ทุกไฟล์ที่ถูกอ้างใน trace ตัดที่เหลือทิ้ง แล้วขอวิเคราะห์ root cause ขอบเขตที่แคบช่วยให้ความสนใจของโมเดลอยู่กับเส้นทางที่พัง แทนที่จะลายไปทั้งรีโพ และ bundle ที่มี tag ยังทำให้โมเดลอ้างบรรทัดที่เชื่อว่าเป็นต้นเหตุได้เป๊ะ ๆ
วิเคราะห์สถาปัตยกรรมในภาพรวม
สลับไปใช้ window 1M แพ็ก entry point, route definition, config และโมดูลใหญ่ ๆ แล้วขอสรุปสถาปัตยกรรม: เลเยอร์หลักมีอะไร ทิศทาง dependency เป็นอย่างไร จุดที่ coupling หนาแน่นอยู่ตรงไหน และควรแยกส่วนไหนออกมา เป็นวิธีที่เร็วที่สุดในการได้แผนที่ของโค้ดที่คุณไม่ได้เขียนเอง
แนวปฏิบัติที่ดี
- ตัด build artifact อย่างเด็ดขาด — lockfile, bundle ที่ minify แล้ว โค้ดที่ generate และ dependency ที่ vendor มา กิน token เป็นหมื่น ๆ โดยไม่บอกอะไรโมเดลเลย
- วางคำสั่งไว้ต้นแชท — บอกงานและเงื่อนไขก่อน แล้วค่อยวาง bundle เพื่อให้โมเดลรู้ว่ากำลังมองหาอะไรก่อนเริ่มอ่านข้อมูล
- เว้น headroom ไว้ 20% — หยุดแพ็กที่ประมาณ 80% ของ window เพื่อให้โมเดลมีที่ว่างคิดและเขียนคำตอบ
- แพ็กใหม่เมื่อเปลี่ยนโมเดล — bundle ที่ตั้งไว้สำหรับโมเดล 200k เปลืองกับโมเดล 128k และใช้ไม่เต็มที่กับโมเดล 1M เลือกขนาด window ใหม่แล้วปรับปุ่มเปิด-ปิดให้สมดุลอีกครั้ง
- ใส่ interface ไม่ใช่แค่ implementation — type, schema และ signature สาธารณะมักอธิบายระบบได้ด้วย token เพียงเสี้ยวเดียวของซอร์สเต็ม
- ปรับที่ bundle ไม่ใช่ที่แชท — ถ้าคำตอบเพี้ยน ให้ปรับปุ่มเปิด-ปิดแล้วแพ็ก context ใหม่ที่สะอาดกว่า ดีกว่าการเท follow-up ซ้อนลงบนบริบทที่ขุ่นมัว
พร้อมเลิกเดาแล้วหรือยัง? เปิด LLM Context Packer ใส่ไฟล์ เลือกขนาด window แล้วคัดลอก bundle ที่แท็กเรียบร้อยภายในไม่ถึงนาที — ทำงานในเบราว์เซอร์ทั้งหมด ไม่มีการอัปโหลดไปที่ใด
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Token Counter — นับจำนวน token ของข้อความใด ๆ แบบเป๊ะ
- LLM Response Cleaner — เก็บกวาด artifact และสัญญาณรบกวนออกจากคำตอบของโมเดล
- LLM VRAM Calculator — คำนวณหน่วยความจำ GPU ก่อนรันโมเดลในเครื่อง
ขอให้สนุกกับการแพ็ก context!
คำถามที่พบบ่อย
ถ: ตัวเลขประมาณการ token แม่นยำแค่ไหน? ตอบ: เครื่องมือใช้สูตรประมาณการแบบเร็วที่จูนมาสำหรับโค้ดและข้อความ แม่นพอสำหรับการวางงบประมาณ เพราะจำนวนเป๊ะ ๆ ต่างกันเล็กน้อยตาม tokenizer ของแต่ละโมเดล จึงควรเว้นที่ว่างไว้บ้างแทนการยัด window จนเต็ม 100%
ถ: โค้ดของฉันถูกอัปโหลดไปที่ไหนหรือเปล่า? ตอบ: ไม่ เครื่องมือทำงานในเบราว์เซอร์ทั้งหมด ไฟล์ถูกอ่านในเครื่อง และ bundle ที่สร้างได้จะไม่ออกจากเครื่องคุณ จนกว่าคุณจะนำไปวางในแชทที่ต้องการเอง
ถ: ควรเลือกขนาด context window แบบไหน? ตอบ: ให้ตรงกับโมเดลที่ใช้ส่งพรอมป์ โดย 128k เหมาะกับโมเดลขนาดกะทัดรัดและขนาดกลางส่วนใหญ่, 200k ตรงกับ assistant ยอดนิยมที่รับ context ยาว, และ 1M สำหรับโมเดล long-context ที่รับงานทั้งโปรเจกต์
ถ: ผสมไฟล์กับข้อความธรรมดาใน bundle เดียวได้ไหม? ตอบ: ได้ โดย text snippet และไฟล์จะถูกรวมกันใน bundle เดียว แยกเป็น section ที่มี tag ของตัวเอง รายงานบั๊กหรือคำสั่งงานจึงอยู่คู่กับซอร์สโค้ดที่เกี่ยวข้องได้ทันที