LLM Response Cleaner: ดึง JSON สะอาดจาก output ของโมเดล
ลบ markdown fences, thinking tags และประโยคพูดจาออกจาก output ของ LLM เพื่อดึง JSON หรือข้อความล้วน — ทันที เป็นส่วนตัว ฝั่ง client ทั้งหมด
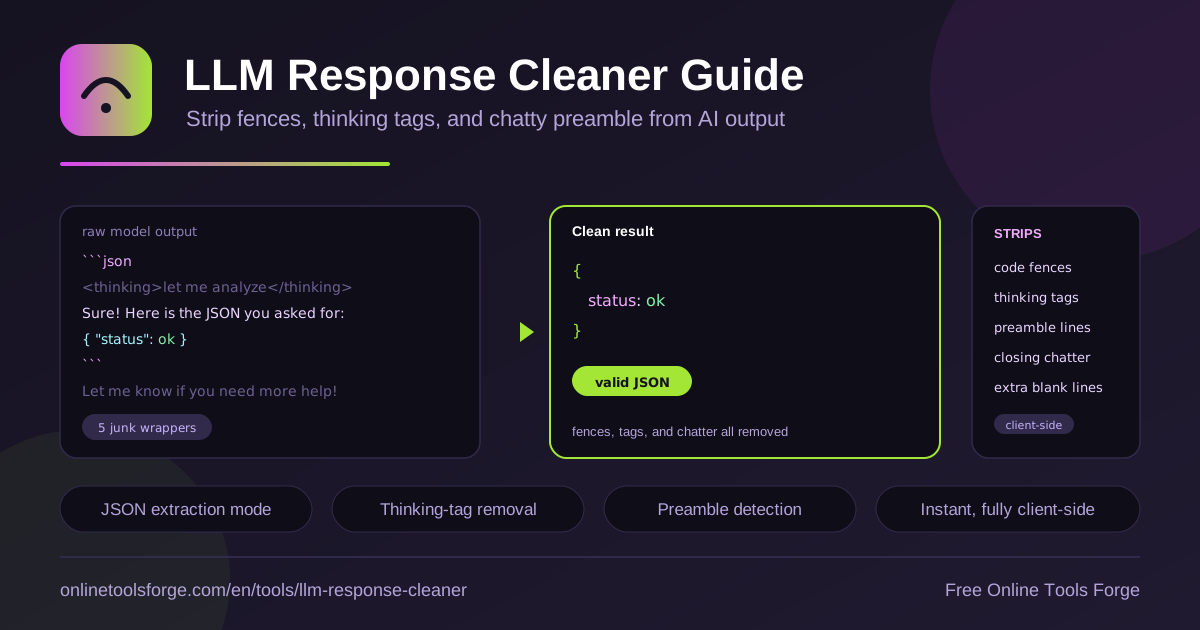
Table of Contents
ใครที่เขียน prompt สั่งโมเดลให้ตอบเป็น JSON คงเคยเจอสถานการณ์เดียวกัน — คุณขอแค่ {"name": "..."} แต่สิ่งที่กลับมาคือบทพูด "Sure! Here is the JSON you requested:" ต่อด้วย code fence สามตัว backtick บางทีแถมมี thinking tag ของ reasoning model ปนมาก่อน และปิดท้ายด้วย "Let me know if you need anything else" ข้อความพวกนี้ทำให้ JSON.parse พังทันที และ pipeline ที่ต่ออยู่ข้างหลังก็ล้มตามไปด้วย
LLM Response Cleaner คือเครื่องมือฟรีที่แก้ปัญหานี้แบบตรงจุด — วาง output ดิบจากโมเดลลงไป มันจะลบ code fence, thinking tags แบบวงเล็บเหลี่ยม, บรรทัดพูดจาเปิด, ประโยคปิด และบรรทัดว่างเกินออกทั้งหมด เหลือเพียง payload ที่คุณต้องการ ไม่ว่าจะเป็น JSON สำหรับ parse ต่อ หรือข้อความล้วนสำหรับเอาไปใช้งาน ทุกอย่างทำงานทันทีฝั่ง client ใน browser ข้อมูลไม่ถูกส่งออกจากเครื่องคุณเลย
บทความนี้จะพาไปดูว่าทำไมโมเดลถึงชอบ "ห่อ" ผลลัพธ์ด้วยบทพูดและการจัดรูปแบบ, wrapper แบบไหนพบบ่อยที่สุด, และวิธีเอาเครื่องมือนี้ไปใช้ในงานจริงตั้งแต่การสร้าง agent pipeline ไปจนถึงการเตรียม test fixture
ทำไมต้องใช้ LLM Response Cleaner?
- ลบ code fence อัตโนมัติ — backtick สามตัวที่ห่อ JSON หรือ code ทั้งบล็อกเปิดและปิด รวมถึง label อย่าง json ต่อท้าย fence ถูกตัดออกให้พร้อม parse ทันที
- ตัด thinking tag ทิ้ง — output จาก reasoning model มักมีบล็อกแบบวงเล็บเหลี่ยมที่โมเดลใช้ "คิดก่อนตอบ" ปนมา ตัวนี้กรองออกทั้งก้อนโดยไม่กระทบเนื้อหาจริง
- ตัดบรรทัดพูดจาเปิดและปิด — ประโยคอย่าง "Sure! Here is..." หรือท้ายบทแบบ "Let me know if..." ที่ทำให้ parser พัง ถูกลบออกแบบ deterministic
- บีบบรรทัดว่างเกินให้กระชับ — blank line ที่ซ้ำกันหลายบรรทัดถูกยุบ ทำให้ payload เล็กลง เทียบ diff หรือเก็บเป็น fixture ได้ง่ายขึ้น
- ดึง payload ออกมาตรงจุด — เลือกได้ว่าจะเอา JSON หรือข้อความล้วน เหมาะทั้งนักทำ agent, prompt engineer และคนเตรียม dataset
- ฟรี ทันที และเป็นส่วนตัว — ทำงานฝั่ง client 100% ไม่ต้องสมัคร ไม่มี upload ข้อมูลขึ้น server ใด ๆ
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| ลบ markdown fences | ตัด backtick สามตัวที่ห่อ JSON หรือ code ออกทั้งฝั่งเปิดและปิด รวมถึง language label ต่อท้าย fence |
| ลบ thinking tags | กรองบล็อกแบบวงเล็บเหลี่ยมที่ reasoning model ใช้แสดงกระบวนการคิด ออกทั้งก้อน |
| ลบบรรทัดพูดจาเปิด | ตัดประโยคแนะนำอย่าง "Sure! Here is..." ที่โมเดลใช้เริ่มคำตอบ |
| ลบประโยคปิด | ตัดท้ายบทอย่าง "Let me know if..." หรือ "I hope this helps" ออก |
| บีบบรรทัดว่างเกิน | ยุบ blank line ที่ซ้ำ ๆ ให้เหลือเท่าที่จำเป็นต่อความอ่านง่าย |
| ดึง payload | แยกให้เหลือ JSON หรือข้อความล้วน พร้อมนำไปใช้ต่อใน pipeline ทันที |
จุดเด่นที่ควรรู้เพิ่ม:
- ทำงานทันที — วางแล้วผลลัพธ์อัปเดตสด ๆ ไม่ต้องกดปุ่ม ไม่ต้องรอ round-trip ไป server
- สองโหมดใช้งาน — output แบบ structured data จะถูก extract เป็น JSON สะอาด ส่วน output แบบ prose ก็จะเหลือข้อความล้วนที่เอาไปใช้ได้เลย
- ผลลัพธ์คาดเดาได้ — กฎการลบเป็นชุดเดียวกันทุกครั้ง input เดิมให้ผลลัพธ์เดิมเสมอ เหมาะกับงาน automation ที่ต้องการความสม่ำเสมอ
วิธีทำความสะอาด output ของ LLM
- เปิด LLM Response Cleaner ใน browser — ใช้ได้ทันที ไม่ต้องติดตั้ง ไม่ต้องสมัครสมาชิก
- คัดลอก output ดิบจาก LLM หรือ agent ของคุณ (ยังมี fence, thinking tag และบทพูดติดมาอยู่) แล้ววางลงช่อง input
- ดูผลลัพธ์ที่แสดงออกมาทันที — เครื่องมือจะลบ wrapper ทั้งหมดอัตโนมัติ พร้อมบอกชัดว่ามีอะไรถูกลบไปบ้าง
- เลือกรูปแบบ payload ที่ต้องการ: JSON สำหรับ parse ต่อในโค้ด หรือข้อความล้วนสำหรับเอาไปใช้เป็นเนื้อหา
- ก๊อปผลลัพธ์สะอาดไปใช้งาน — จะวางลงไฟล์ test fixture, ส่งต่อใน pipeline หรือเก็บลง dataset ก็พร้อมใช้ทันที
ทำไม output ของโมเดลถึงต้องทำความสะอาด
สาเหตุเชิงลึกคือ LLM ถูกฝึกมาให้เป็น "ผู้ช่วยสนทนา" ไม่ใช่ API ที่ตอบข้อมูลดิบ คุณค่าที่ training ตอบรับคือความช่วยเหลือ มารยาทและการอธิบาย ดังนั้นเมื่อคุณสั่ง "ตอบเป็น JSON เท่านั้น" โมเดลมักยังดึงนิสัยเดิมมาปน เช่น เกริ่นนำสั้น ๆ ก่อนข้อมูล, ครอบด้วย code fence เพราะคิดว่า JSON เป็น "code", หรือปิดท้ายด้วยข้อเสนอช่วยเพิ่ม ยิ่งเป็น reasoning model ด้วยแล้ว ยังมี thinking tag ที่เป็นกระบวนการคิดภายในหลุดมาใน output อีกชั้น
wrapper ที่พบบ่อยมีไม่กี่แบบ: code fence สามตัว backtick พร้อม label ภาษา, thinking tag แบบวงเล็บเหลี่ยม, ประโยคขอโทษหรือขออนุญาตอย่าง "I apologize for the confusion" และข้อเสนอปิดท้ายแบบ "Would you like me to..." ทั้งหมดนี้ดูไร้พิษภัยสำหรับคนอ่าน แต่โหดร้ายกับ parser — JSON.parse ต้องการให้อักษรตัวแรกคือ { หรือ [ เท่านั้น มีคำเกริ่นแม้แต่บรรทัดเดียวก่อนวงเล็บก็ throw ทันที และทุกครั้งที่ pipeline ล้ม คุณต้อง retry ซึ่งแปลว่าเสีย token เสียเวลาและเสียเงินจริง
ทางแก้ที่นักพัฒนามักเริ่มด้วยคือเขียน regex เอง แต่ regex ที่เดาตำแหน่ง JSON ด้วย pattern อย่าง "หา { ตัวแรกจนถึง } ตัวสุดท้าย" มักพังกับกรณีขอบ เช่น JSON ที่มี } อยู่ใน string, fence ที่มี label ต่างกัน หรือบทพูดที่ปนอยู่ทั้งก่อนและหลัง การทำความสะอาดแบบ deterministic ที่มีลำดับกฎชัดเจน — ตัด fence ก่อน ตัด tag ต่อ กรองบรรทัดพูดจา แล้ว extract payload สุดท้าย — ให้ผลลัพธ์ที่ทำซ้ำได้และทดสอบได้ ต่างจากการเดาด้วย regex ที่ละเอียดอ่อนไปตามแต่ละโมเดล
แน่นอนว่าวิธีป้องกันที่ดีที่สุดเริ่มตั้งแต่ฝั่ง prompt: ระบุว่า "ตอบด้วย JSON ล้วน ห้ามมีข้อความอื่น", ใช้ JSON mode หรือ structured outputs ของ provider ถ้ามี และยกตัวอย่าง schema ให้ชัด แต่แม้ทำครบแล้ว โมเดลก็ยังหลุดบางครั้ง โดยเฉพาะกับ input ที่ยาวหรือซับซ้อน การมีขั้นตอนทำความสะอาดเป็นเกราะสุดท้ายก่อน parse จึงเป็นแนวปฏิบัติที่ทีมที่ทำ agent จริงจังแทบทุกทีมใช้ ลองเห็นภาพก่อน-หลังง่าย ๆ:
ก่อน:  Sure! Here is the JSON you asked for:  ```json {"city":"Bangkok","temp":34} ```  Let me know if you need anything else!
หลัง:  {"city":"Bangkok","temp":34}
บรรทัดเดียวที่เหลือคือสิ่งเดียวที่ pipeline ของคุณต้องการ
กรณีใช้งานจริง
สร้าง agent pipeline ที่ parse ได้ทุกครั้ง
agent ที่เรียกโมเดลหลายขั้นตอนมักให้แต่ละขั้นตอนตอบเป็น JSON เพื่อส่งต่อให้ tool ถัดไป ปัญหาคือทุกครั้งที่โมเดลแต่ง wrapper เพิ่ม ทั้ง chain ก็ดับ ด้วย LLM Response Cleaner คุณวาง output ที่หลุดจาก format ลงไป ดึง JSON ออกมา แล้วใช้ผลลัพธ์นั้นทดสอบว่า parser ของ pipeline จัดการ wrapper แบบนี้ได้หรือไม่ ก่อนจะเจอใน production จริง
เตรียม test fixture สำหรับ prompt และ eval
การเขียน unit test ให้ตัว parse output ของโมเดล ต้องมี fixture ที่เลียนแบบความยุ่งของ output จริง — มีทั้งแบบสะอาด แบบมี fence, แบบมี thinking tag และแบบมีบทพูดครบชุด วิธีที่ไวที่สุดคือเอา output จริงจากการรัน prompt มาทำความสะอาดคู่กันเก็บทั้งเวอร์ชันดิบและเวอร์ชันสะอาดเป็นคู่ expected input/expected output ใน test suite ของคุณ
ทำความสะอาดบทสนทนาเพื่อทำเอกสาร
เวลาคุณคุยกับโมเดลเพื่อร่างเอกสาร บทความหรือคู่มือ ผลลัพธ์มักมีประโยคพูดจาเชิงสนทนาปนอยู่ อย่าง "แน่นอนครับ นี่คือร่างแรก" หรือ thinking tag ที่หลุดมาด้วย การวางลงตัวนี้ก่อนจะช่วยตัดสิ่งที่ไม่ใช่เนื้อหาออก เหลือข้อความล้วนที่ก๊อปลงเอกสารได้ทันทีโดยไม่ต้องไล่ลบมือ
ดึงข้อมูลมีโครงสร้างจาก log ของโมเดล
ถ้าคุณเก็บ log การเรียกโมเดลไว้วิเคราะห์ หรือขุดข้อมูล structured data อย่างรายการสินค้า ข้อมูลติดต่อหรือผลการจำแนก จาก output จำนวนมาก การเปิด log ทีละอันเพื่อหาว่า JSON อยู่ตรงไหนใช้เวลามาก วางเข้าเครื่องมือนี้แล้ว payload จะถูกดึงออกมาทันที เหลือแค่ก๊อปไปใช้หรือทำ batch ต่อได้ตามสะดวก
แนวทางปฏิบัติที่ดี
- สั่ง format ใน prompt ให้เด็ดขาด — บอกโมเดลให้ตอบ JSON ล้วน ห้ามเกริ่นนำ และใช้ JSON mode ของ provider เมื่อมี แต่ยังต้องมีขั้นทำความสะอาดรองรับเสมอ
- เก็บทั้งเวอร์ชันดิบและสะอาด — ใน test fixture ให้เก็บ input ดิบที่มี wrapper คู่กับผลลัพธ์ที่คาดหวัง เพื่อทดสอบทั้งตัวทำความสะอาดและ parser พร้อมกัน
- ทำความสะอาดก่อน validate — ลำดับที่ดีคือ clean แล้วค่อย JSON schema validation ถ้าสลับลำดับ จะเจอ error ที่อ่านยากจากอักษรแปลกปลอมแทนที่จะเป็นปัญหาข้อมูลจริง
- อย่าเดาด้วย regex เองใน pipeline — กฎชุดเดียวที่ deterministic ปลอดภัยกว่า pattern ที่เดาตำแหน่ง โดยเฉพาะเมื่อสลับไปใช้หลายโมเดล
- ตรวจสิ่งที่ถูกลบทุกครั้ง — สังเกตรายการสิ่งที่เครื่องมือลบออก ถ้ามีเนื้อหาสำคัญหลุดมาอยู่ในรายการนั้น แปลว่า prompt หรือ format ที่คุณสั่งควรปรับ
- ใช้เป็นขั้นตอนมาตรฐานใน CI สำหรับ eval — ทุกครั้งที่รันชุดทดสอบ prompt ให้ผ่านการทำความสะอาดก่อนเทียบผล จะได้ผลลัพธ์ที่เทียบกันได้อย่างเป็นธรรม
พร้อมให้ output ของโมเดลสะอาดขึ้นแล้วหรือยัง? ลองใช้ LLM Response Cleaner ได้ฟรีทันที — วาง output ดิบลงไป ไม่กี่วินาทีคุณก็ได้ JSON หรือข้อความล้วนที่ pipeline รับได้โดยไม่พัง ทำงานฝั่ง client ทั้งหมด ข้อมูลของคุณไม่หลุดออกจาก browser
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- AI Token Cost Estimator — ประเมินค่าใช้จ่าย token ของ prompt และ response ก่อนรันจริง
- Prompt Template Builder — ออกแบบ prompt ที่มีโครงสร้างชัด ลดโอกาสโมเดลหลุด format
- llms.txt Generator — สร้างไฟล์ llms.txt เพื่อบอกบริบทเว็บคุณให้โมเดลเข้าใจ
ขอให้ทำความสะอาดอย่างสนุก!
คำถามที่พบบ่อย
ถ: ข้อมูลที่วางลงไปถูกส่งไป server ไหม?
ตอบ: ไม่ เครื่องมือทำงานฝั่ง client 100% ใน browser ของคุณ ข้อมูล output ของโมเดลไม่ถูกอัปโหลดไปที่ใดทั้งสิ้น จึงใช้กับข้อมูลภายในองค์กรหรือข้อมูลลับได้อย่างสบายใจ
ถ: ใช้กับ output ที่ไม่ใช่ JSON ได้หรือไม่?
ตอบ: ได้ นอกจากโหมดดึง JSON แล้ว ยังมีโหมดข้อความล้วนที่ลบเพียง fence, thinking tag, บรรทัดพูดจาเปิด-ปิดและบรรทัดว่างเกิน เหมาะกับการเอาเนื้อหา prose ไปทำเอกสารหรือ dataset
ถ: ถ้าโมเดลห่อ JSON ด้วย fence และยังใส่บทพูดก่อนหน้าด้วย ต้องทำอย่างไร?
ตอบ: วางทั้งก้อนเข้าไปได้เลย เครื่องมือจะตัด fence ออกก่อน แล้วกรองบรรทัดพูดจาที่เหลือทำให้เหลือเพียง payload JSON ตัวจริงที่ parse ได้ทันที
ถ: ควรใช้แทน JSON mode หรือ structured outputs ของ provider ได้ไหม?
ตอบ: ควรใช้คู่กันมากกว่า JSON mode ช่วยลดโอกาสที่โมเดลหลุด format ตั้งแต่ต้นทาง แต่ยังมีกรณีหลุดอยู่เสมอ การมีขั้นทำความสะอาดเป็นเกราะสุดท้ายก่อน parse ทำให้ pipeline ทนต่อความผิดพลาดของโมเดลได้ดีขึ้น
ถ: เหมาะกับใครบ้าง?
ตอบ: prompt engineer ที่ทดสอบ format ของ output, นักสร้าง agent ที่ต้องการ chain ที่ parse ได้ทุกครั้ง และทีม QA ที่เตรียม test fixture จาก output จริงของโมเดล ล้วนใช้งานได้ทันทีโดยไม่ต้องเขียนโค้ดเลย