โมเดล LLM ในเครื่องของคุณต้องใช้ VRAM เท่าไร? คู่มือฉบับคำนวณจริง
LLM VRAM Calculator ช่วยประมาณ VRAM ที่ GPU ต้องใช้สำหรับรัน local LLM ตั้งแต่ weights หลัง quantization ไปจนถึง KV cache และ overhead พร้อมเทียบกับการ์ดจอจริงและ unified memory ของ Apple
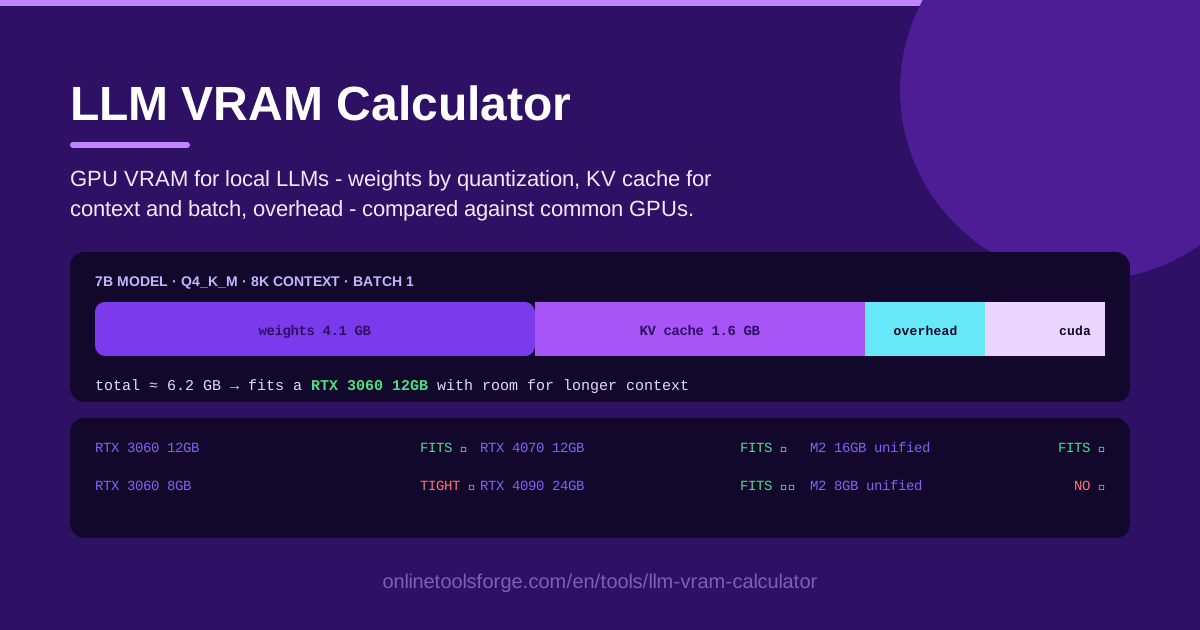
Table of Contents
การรัน LLM (Large Language Model) บนฮาร์ดแวร์ของตัวเองเป็นการอัพเกรดที่คุ้มค่าที่สุดอย่างหนึ่งสำหรับนักพัฒนา ไม่มีค่าบริการต่อ token ไม่มี rate limit และข้อมูลของคุณเป็นส่วนตัว 100% แต่ก่อนจะกดดาวน์โหลดโมเดล คำถามแรกที่ทุกคนเจอคือ "โมเดลนี้จะลงตัวใน GPU ของผมจริงไหม?" ซึ่งเป็นเรื่องที่ LLM VRAM Calculator ถูกสร้างมาเพื่อตอบ คุณเพียงกรอกขนาด model, ระดับ quantization, context length และ batch size เครื่องมือจะประมาณ VRAM ที่ต้องใช้ทั้งหมด แล้วเทียบกับการ์ดจอยอดนิยมและ unified memory ของ Apple ให้อัตโนมัติ
จุดที่ทำให้หลายคนคำนวณผิดคือ ขนาด model เพียงอย่างเดียวบอกอะไรไม่ได้มาก โมเดล 7B แบบ FP16 ต้องใช้ weights ราว 14 GB แต่ถ้า quantization เป็น Q4 เหลือประมาณ 4 GB เท่านั้น ขณะเดียวกัน KV cache จะโตขึ้นตาม context length และ runtime overhead ก็แอบกินพื้นที่อีกส่วนหนึ่งเสมอ ถ้าเดาผิด คุณจะเจอ out-of-memory กลางการ generate หรือจ่ายเงินซื้อฮาร์ดแวร์ที่มีความจุเกินจำเป็น
บทความนี้จะอธิบายว่า VRAM หายไปไหนบ้าง สาธิตวิธีใช้เครื่องมือทีละขั้น และยกสถานการณ์จริง เช่น การเลือก GPU สำหรับโมเดล 7B หรือการวางแผนเซ็ตอัพโมเดล 70B
ทำไมต้องใช้ LLM VRAM Calculator?
- ลดความเสี่ยงซื้อฮาร์ดแวร์ผิดพลาด — GPU และ Mac แรมสูงราคาแพง การเช็กก่อนซื้อว่าโมเดลลงตัวหรือไม่ ช่วยประหยัดทั้งเงินและเวลาที่เสียไปกับดาวน์โหลดขนาดหลายกิกะไบต์ที่สุดท้ายโหลดมาแล้วใช้ไม่ได้
- เห็นภาพหน่วยความจำครบทุกส่วน — หลายบทความพูดถึงแต่ weights แต่เครื่องมือนี้รวม KV cache ตาม context และ batch ของคุณ บวก runtime overhead ซึ่งเป็นตัวกำหนดจริงว่า inference จะรอดในเซสชันยาว ๆ หรือไม่
- เทียบระดับ quantization ได้ทันที — สลับระหว่าง FP16, Q8, Q5 และ Q4 เพื่อดูว่าแต่ละระดับประหยัดหน่วยความจำได้เท่าไร และ trade-off นั้นมีผลต่อการเลือกฮาร์ดแวร์อย่างไร
- จับคู่กับฮาร์ดแวร์จริง — แทนตัวเลขกิกะไบต์ลอย ๆ คุณจะได้ผลเทียบกับการ์ดอย่าง RTX 3060 หรือ RTX 4090 และ unified memory ของ Apple พร้อม verdict ชัดเจนว่า FITS หรือ NO
- วางแผนเผื่ออนาคต — ถ้าวันนี้ 8K tokens พอ แต่ pipeline RAG ของคุณต้องการ 32K คุณจะเห็นต้นทุน KV cache ที่พุ่งขึ้นก่อนที่มันจะกลายเป็นปัญหาใน production
- ใช้งานฟรี ไม่ต้องติดตั้ง — เครื่องมือรันในเบราว์เซอร์ทั้งหมด ไม่ต้องสมัครสมาชิก ไม่มีข้อมูลถูกส่งไปไหน ได้ตัวเลขที่ใช้ตัดสินใจได้ทันที
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| ป้อนขนาด model | กรอกจำนวนพารามิเตอร์ เช่น 7B, 13B, 70B เป็นฐานของการคำนวณทั้งหมด |
| ระดับ quantization | เลือกตั้งแต่ FP16 ถึง Q4 เพื่อปรับขนาด weights ให้ตรงกับไฟล์ที่จะใช้จริง |
| Context length | กำหนดพื้นที่ KV cache ที่โมเดลต้องกุมไว้สำหรับ prompt และประวัติการสนทนา |
| Batch size | คูณหน่วยความจำส่วน cache เมื่อต้องรองรับหลาย request พร้อมกัน |
| แยกองค์ประกอบ VRAM | แบ่งผลลัพธ์เป็น weights, KV cache และ overhead ให้เห็นว่าหน่วยความจำไปอยู่ตรงไหน |
| เทียบกับ GPU | เช็กยอดรวมกับการ์ดยอดนิยม เช่น RTX 3060 และ RTX 4090 |
| เช็ก unified memory | เทียบกับค่า RAM ของเครื่อง Apple Silicon สำหรับสาย Mac |
| Verdict FITS/NO | สรุปผลแบบตรงไปตรงมาว่าแต่ละฮาร์ดแวร์พอหรือไม่พอ |
จุดที่น่าสังเกตเพิ่มเติมมีสามอย่าง:
- มุมมองแบบแยกส่วน ให้ความรู้มากที่สุด เมื่อเห็นว่าโมเดล 13B ที่ Q8 ใช้ weights ราว 13 GB แต่ cache ที่ context 4K ใช้แค่ประมาณ 2 GB คุณจะเข้าใจว่า "โมเดลใหญ่" มีต้นทุนจริงแค่ไหน
- Verdict FITS/NO คิดรวมเผื่อพื้นที่เหลือ ไม่ใช่จับคู่ขนาดเป๊ะ ๆ การ์ดที่จุด weights ได้แต่ไม่เหลือที่สำหรับ overhead จะถูกตัดสินให้เห็นตามความจริง
- ทุกอย่างประมวลผลฝั่ง client คุณจึงลองปรับตัวเลขเทียบสิบกว่าสถานการณ์ได้ภายในไม่กี่นาที
วิธีใช้งาน LLM VRAM Calculator
- กรอก model และ quantization — ใส่จำนวนพารามิเตอร์ของโมเดลและเลือกระดับ quantization ที่จะใช้จริง เช่น โมเดล 7B ที่ Q4 เครื่องมือจะคำนวณขนาด weights ให้ทันที
- ตั้ง context length และ batch size — ใส่ context ที่ใช้จริง 4K สำหรับแชตทั่วไป หรือ 16K-32K สำหรับงานเอกสาร พร้อมจำนวน request ที่รันพร้อมกันหากมีมากกว่าหนึ่ง
- อ่านสัดส่วน VRAM — แผงผลลัพธ์แสดง weights, KV cache และ overhead แยกกัน พร้อมยอดรวมที่คุณต้องเตรียมไว้
- เทียบกับ GPU — ไล่ดูตารางเปรียบเทียบว่าการ์ดไหนและค่า unified memory ไหนได้ verdict FITS และตัวไหนกลับมาเป็น NO
- เลือกฮาร์ดแวร์ — ใช้ผลลัพธ์ร่วมกับหลักการเผื่อ headroom แล้วเลือกตัวเลือกที่ประหยัดที่สุดที่ผ่านเกณฑ์ของคุณอย่างสบาย
Weights, KV Cache และ Overhead ที่มักถูกลืม
Weights คือค่าพื้นฐาน — weights แบบ FP16 ที่ไม่บีบอัดใช้ราว 2 ไบต์ต่อพารามิเตอร์ โมเดล 7B จึงกิน ~14 GB และ 70B กิน ~140 GB ซึ่งเกินมือการ์ด consumer ทันที quantization ช่วยย่อขนาดลง Q8 เก็บพารามิเตอร์ละราว 1 ไบต์ Q5 ราว 0.7 และ Q4 ราว 0.5 นี่คือเหตุผลที่โมเดล 7B ที่ Q4 ลงตัวราว 4 GB และใส่การ์ด 8 GB ได้ ส่วน 70B ที่ Q4 ยังอยู่ท้าว ๆ 40 GB จนกลายเป็นโจทย์หลายการ์ดหรือ Mac แรมสูง precision ต่ำอาจแลกมาด้วยคุณภาพ output ที่ลดลงบ้าง แต่หลายงานใช้ Q4 และ Q5 ได้สบาย
KV cache โตตาม context — เพื่อให้ attention ยังต่อเนื่อง โมเดลต้องเก็บ key และ value vector ของทุก token ใน context window cache จึงขยายตามทั้งความยาว context และความกว้างของโมเดล คูณ context เป็นสองเท่า ส่วนนี้ก็โตขึ้นราวสองเท่าเช่นกัน โมเดล 7B อาจใช้ cache ~1 GB ที่ 4K tokens แต่หลายกิกะไบต์ที่ 32K นี่คือต้นทุนที่คนลืมบ่อยที่สุด และเป็นสาเหตุที่โมเดลที่ "พอ" ที่ context 2K ล้มทันทีเมื่อคุณแปะเอกสารยาวเข้าไป
Batch size คูณ cache เข้าไปอีกชั้น — การรองรับ 4 request พร้อมกันไม่ได้แชร์ KV cache ระหว่างกัน แต่ละ sequence กุม cache ของตัวเองไว้ หน่วยความจำส่วน cache จึงแทบคูณด้วย batch size ซึ่งสำคัญมากกับคนที่สร้าง API endpoint เล็ก ๆ ไม่ใช่แค่ใช้แชตคนเดียว
Overhead คือภาษีที่ถูกลืม — CUDA context, buffer ของ framework, activation ระหว่าง generate และ fragmentation มักกินเพิ่ม 1-2 GB หรือมากกว่าก่อนที่โมเดลจะปล่อย token แรกออกมา การ์ดที่ weights บวก cache ล้นพอดี 8.0 GB บน GPU 8 GB จะไม่รอดแน่นอน
Unified memory เปลี่ยนกติกาบน Mac — Apple Silicon ให้ GPU แชร์ RAM ของระบบ ทำให้ Mac 64 GB หรือ 128 GB จุดโมเดลที่การ์ด NVIDIA consumer จุดไม่ได้ แต่แบนด์วิดท์ต่ำกว่าและ OS ต้องเก็บส่วนแบ่งของตัวเองไว้ด้วย จึงควรมองตัวเลข unified memory ว่าเป็นเพดานแบบมองข้ามข้อจำกัด ไม่ใช่ค่าที่รับประกันได้จริง
ตัวอย่างการใช้งานจริง
เลือก GPU สำหรับโมเดล 7B
คุณอยากได้ coding assistant ในเครื่องและกำลังสนใจ RTX 3060 กรอก 7B ที่ Q4, context 8K, batch 1 เครื่องมือจะแสดง weights ราว 4.5 GB, cache ~1 GB และ overhead ~1.5 GB ได้ verdict FITS อย่างสบาย ลองเพิ่ม context เป็น 32K สำหรับ refactor โค้ดยาว ๆ แล้วดูว่าการ์ดเดิมยังผ่านเกณฑ์ไหม หรือควรวางแผนหาการ์ด 12 GB แทน
วางแผนเซ็ตอัพโมเดล 70B
โมเดล 70B ที่ Q4 ต้องการ weights ราว 40 GB ก่อนจะบวก cache และ overhead ซึ่งตัดการ์ด consumer รุ่นเดี่ยวออกไปทันที และชี้ไปทาง rig หลายการ์ดหรือ Mac ที่มี unified memory 64 GB ขึ้นไป การคำนวณก่อนจะบอกคุณว่าเครื่องที่วางแผนไว้ต้องใช้การ์ด 24 GB สองใบ หรือว่า Mac ตระกูล M จริง ๆ แล้วเป็นทางเลือกที่คุ้มกว่า
คำนวณ context ที่เหมาะสมสำหรับ RAG
Pipeline แบบ RAG ยัดเอกสารที่ดึงมาได้ใส่ prompt ดังนั้น context คือหัวใจของเรื่อง ลองประมาณหน้าต่าง retrieval จริงของคุณ เช่น 16K tokens แล้วเทียบกับ 8K เพื่อดูว่า context ที่เพิ่มขึ้นแต่ละช่วงมีราคาเท่าไรในแง่ cache คำตอบที่พบบ่อยคือ โมเดลเล็กที่รับ context กว้างกว่ามักชนะโมเดลใหญ่ที่รับ context แคบกว่า
ตัดสินใจรันในเครื่องหรือใช้ API
ถ้าเครื่องมือบอกว่า workload ของคุณต้องการ VRAM 48 GB เพื่อ latency ที่ยอมรับได้ การเช่า API สำหรับ traffic ที่พีคชั่วคราวอาจถูกกว่าการซื้อฮาร์ดแวร์มาก ตาราง verdict ยังใช้เช็กทางกลับกันได้ด้วย ถ้าโมเดลขนาดพอประมาณลงตัวพร้อม headroom เหลือเฟือ การไปทาง local น่าจะคุ้มทั้งเรื่องราคาและความเป็นส่วนตัวของข้อมูล
แนวปฏิบัติที่ดี
- เผื่อ headroom 10-20% — มุ่งเลือก GPU ที่มีความจุมากกว่าค่าประมาณอย่างน้อย 10-20% เพราะการจับคู่ขนาดเป๊ะ ๆ มักล้มเมื่อ fragmentation และ buffer ของ framework เข้ามาเกี่ยวข้อง
- คำนวณใหม่ทุกครั้งที่เปลี่ยน quantization — การย้ายจาก Q8 ไป Q4 เปลี่ยนขนาด weights มหาศาล อย่าใช้ตัวเลขประมาณการเก่าซ้ำ
- ทดสอบด้วย context จริงของคุณ — อย่าไซส์ฮาร์ดแวร์ด้วย context แชต 2K ทั้งที่แอปของคุณส่ง prompt ยาว 20K tokens KV cache คือส่วนที่กัดแรงที่สุด
- จำ activation ระหว่าง generation — การ generate ยาวและ batch ใหญ่เพิ่มหน่วยความจำชั่วคราวเหนือค่าประมาณตอนทำงานปกติ ซึ่งเป็นอีกเหตุผลว่าทำไม headroom จึงสำคัญ
- บน Mac ให้หักส่วนของ OS — unified memory ต้องแชร์กับ macOS จึงควรวางแผนบนราว 70-75% ของค่าที่โฆษณาไว้
- ตรวจสอบด้วย load test จริง — เครื่องมือนี้เป็นการประมาณ ก่อนซื้อให้รันโมเดลด้วย prompt ยาวที่สุดของคุณสักครั้งเพื่อยืนยันว่าตัวเลขเป็นไปตามคาด
พร้อมดูแล้วหรือยังว่าโมเดลถัดไปของคุณมีราคาจริงเท่าไรในแง่หน่วยความจำ? เปิด LLM VRAM Calculator กรอกขนาด model, quantization, context และ batch size แล้วรับ verdict FITS หรือ NO เทียบกับ GPU จริงภายในไม่กี่วินาที ก่อนที่คุณจะจ่ายแม้แต่บาทเดียวให้กับฮาร์ดแวร์ใหม่
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- LLM Context Packer — วางแผนว่า prompt และเอกสารของคุณกิน context จริงเท่าไรก่อนส่งเข้าโมเดล
- Token Counter — นับ token ใน prompt ของคุณ เพื่อเลือก context length ที่เหมาะสมสำหรับการคำนวณ
- Model Training Cost Calculator — ไปไกลกว่า inference ประมาณต้นทุนการ train หรือ fine-tune โมเดล
ขอให้สนุกกับการสร้างสรรค์!
คำถามที่พบบ่อย
ถ: ค่าประมาณ VRAM แม่นยำแค่ไหน? ตอบ: เป็นค่าประมาณสำหรับวางแผนที่คำนวณจากสูตรมาตรฐานของ weights, KV cache และ overhead การใช้งานจริงอาจต่างออกไปตาม framework และสถาปัตยกรรมโมเดล จึงควรเผื่อ headroom 10-20% และทดสอบจริงก่อนตัดสินใจซื้อฮาร์ดแวร์
ถ: การ quantization จาก Q8 เป็น Q4 ทำให้คุณภาพ output แย่ลงไหม? ตอบ: โดยทั่วไปลดลงเพียงเล็กน้อย และหลายงานแทบแยกไม่ออก คุณภาพที่หายไปขึ้นกับประเภทงาน ควรทดสอบโมเดลและระดับ quantization นั้น ๆ กับ prompt ของคุณเองก่อนตัดสินใจใช้จริง
ถ: ทำไมโมเดลพอที่ context สั้น แต่พังเมื่อ prompt ยาว? ตอบ: KV cache ขยายตาม context length prompt ยาวจึงเพิ่มหน่วยความจำได้หลายกิกะไบต์ทับบน weights ลองคำนวณใหม่ด้วย context สูงสุดที่ใช้จริงของคุณเพื่อดูความต้องการที่แท้จริง
ถ: รันโมเดลใหญ่บน Mac ที่มี unified memory ได้ไหม? ตอบ: บ่อยครั้งทำได้ เพราะ unified memory ทำให้ GPU ของ Apple Silicon เข้าถึงหน่วยความจำได้มากกว่าการ์ด consumer ทั่วไปมาก แต่ OS ต้องใช้ส่วนแบ่งด้วย จึงควรวางแผนบนราว 70-75% ของค่ารวม และคาดหวัง throughput ที่ต่ำกว่า discrete GPU