Log Viewer: วิเคราะห์ Log ในเบราว์เซอร์ กรองตามระดับและจัดกลุ่ม Error ได้ในไม่กี่วินาที
Log Viewer ให้คุณวาง log แบบ NDJSON, logfmt หรือ plain text แล้วสำรวจได้ทันทีในเบราว์เซอร์ พร้อม level filter, level-stat bars และ error clustering โดยไม่ต้องอัปโหลดและไม่ต้องติดตั้งอะไร
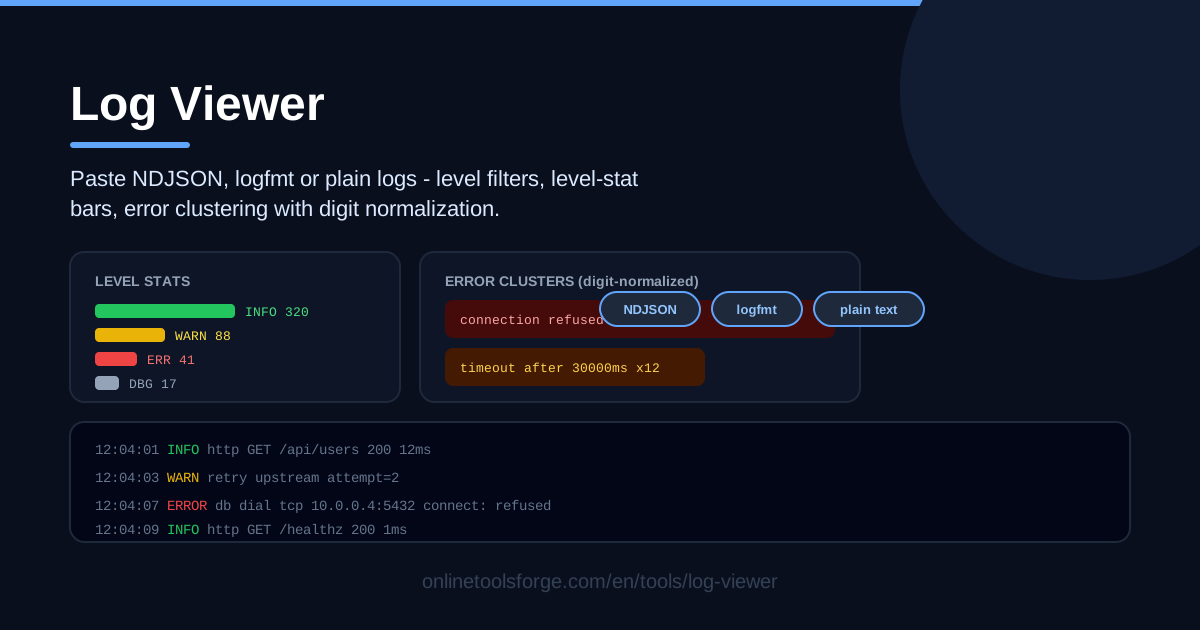
Table of Contents
ทุกครั้งที่ระบบล่มหรือ deploy ไม่ผ่าน นักพัฒนาต้องเจอสิ่งเดียวกัน นั่นคือกำแพง log ยาวเหยียดพร้อมคำถามเดิม ๆ ว่านี่คือความล้มเหลวแบบเดียวที่เกิดซ้ำพันครั้ง หรือความล้มเหลวแบบใหม่พันแบบ Log Viewer ถูกสร้างมาเพื่อช่วงเวลาแบบนี้โดยเฉพาะ เพียงวาง log ของคุณ ไม่ว่าจะเป็น NDJSON, logfmt หรือ plain text แล้วสำรวจได้ทันทีในเบราว์เซอร์ ด้วย level filter, level-stat bars และ error clustering ที่ยุบบรรทัดที่หน้าตาเหมือนกันนับพันบรรทัดให้เหลือเพียงไม่กี่ pattern
จุดที่ทำให้เครื่องมือนี้ต่างจากคนอื่นคือสิ่งที่มัน "ไม่ทำ" ไม่ต้องอัปโหลด ไม่ต้องสมัครบัญชี ไม่ต้องตั้งค่า pipeline ใด ๆ ทุกอย่างทำงานในเบราว์เซอร์ของคุณ log จึงไม่เคยออกจากเครื่อง
บทความนี้จะพาไปดูว่าเครื่องมือทำอะไรได้บ้าง ใช้งานอย่างไร และเข้ากับ workflow การ debug ที่มี log platform ตัวใหญ่อยู่แล้วได้อย่างไร
ทำไมต้องใช้ Log Viewer?
- วางแล้วดูได้ทันที ไม่ต้องติดตั้งอะไร การดู log ที่เร็วที่สุดไม่ควรต้องเซ็ตอัพอะไรเลย คัดลอก output มาวาง แล้วคุณจะเห็นข้อมูลแบบมีโครงสร้างที่กรองได้ภายในไม่กี่วินาที ทั้งหมดทำงานในเบราว์เซอร์ของคุณ
- รองรับรูปแบบที่คุณมีอยู่แล้ว web service ยุคใหม่เขียน log เป็น NDJSON, Go binary มักใช้ logfmt และ cron script รุ่นเก่าก็แค่พิมพ์บรรทัดข้อความ เครื่องมือจะตรวจจับรูปแบบและ parse ให้เอง เพื่อให้คุณ filter และจัดกลุ่มได้แทนการไล่อ่านด้วยตาเปล่า
- Level-stat bars ให้ภาพรวมทันที ก่อนจะอ่านแม้แต่บรรทัดเดียว คุณจะเห็นว่ามี log ระดับ INFO, WARN, ERROR และ DEBUG กี่รายการ log ที่เป็น error 90% กับ log ที่เป็น noise 99% แต่มี exception ซ่อนอยู่ คือสองเรื่องที่ต่างกันคนละขั้ว
- Error clustering ยุบความซ้ำซ้อนให้เหลือน้อย "Connection refused on port 5432" กับ "Connection refused on port 5433" คือความล้มเหลวแบบเดียวกันที่ต่างกันแค่ตัวเลข digit normalization ทำให้ทั้งสองรวมเป็น cluster เดียว คุณจึงนับ root cause แทนที่จะนับบรรทัด
- สอง filter ตอบคำถามได้เกือบทุกแบบ กรองตามระดับ (INFO/WARN/ERROR/DEBUG) เพื่อหาสิ่งที่สำคัญ แล้วกรองต่อด้วย free-text filter เพื่อค้นหา keyword เช่น ชื่อ service, endpoint หรือข้อความบางส่วน
- เป็นส่วนตัวตั้งแต่การออกแบบ การ parse, filter และ clustering ทั้งหมดเกิดขึ้นบนเครื่องคุณ คุณจึงไล่ดู log ที่มีข้อมูลลูกค้า, hostname ภายใน หรือ stack trace ได้โดยไม่ต้องส่งออกไปที่ใด
ฟีเจอร์หลักของ Log Viewer
| ฟีเจอร์ | ทำอะไร |
|---|---|
| Multi-format parsing | รับ log แบบ NDJSON, logfmt และ plain text โดยตรวจจับรูปแบบจากสิ่งที่วาง |
| Level filter | แสดงหรือซ่อนรายการตามความรุนแรง INFO, WARN, ERROR หรือ DEBUG |
| Free-text filter | กรองให้แคบลงด้วย keyword ใด ๆ ตั้งแต่ชื่อ service ไปจนถึงข้อความบางส่วน |
| Level-stat bars | สรุปจำนวนรายการแต่ละระดับเป็นแท่ง เห็นรูปร่างของ log ได้ทันที |
| Error clustering | จัดกลุ่ม error message ที่คล้ายกันเข้าด้วยกันด้วยเทคนิค digit normalization |
| Scrollable entry view | เลื่อนดู output ยาว ๆ ได้สบายในลิสต์แบบ terminal |
จุดที่น่าสังเกตเพิ่มเติม:
- Digit normalization คือหัวใจของ clustering ช่วงตัวเลขใน error message จะถูกแทนที่ด้วย placeholder ก่อนจัดกลุ่ม "request 123 failed" กับ "request 456 failed" จึงรวมเป็น pattern เดียวพร้อมตัวนับ แปลง "มี error 500 บรรทัด" ให้กลายเป็น "มี error แบบเดียว 3 แบบ และแบบหนึ่งเกิด 470 ครั้ง"
- ทั้งสอง filter ใช้ร่วมกันได้ กรองเหลือ ERROR ก่อน แล้วค้นหาคำว่า timeout ภายในเฉพาะ error เหล่านั้น โดย level-stat bars จะอัปเดตตามไปด้วย คุณจึงรู้เสมอว่าตัวเองกำลังดูข้อมูลจำนวนเท่าไร
- Plain text ก็ยังได้โครงสร้าง แม้ไม่ใช่ NDJSON หรือ logfmt สิ่งที่วางจะกลายเป็นลิสต์ที่ filter นับและจัดกลุ่มได้ ไม่ใช่ข้อความก้อนเดียวที่ต้องเลื่อนอ่าน
วิธีใช้งาน Log Viewer
- วาง log ของคุณ NDJSON (JSON หนึ่ง object ต่อหนึ่งบรรทัด), logfmt (คู่ key=value คั่นด้วยช่องว่าง) และ plain text ใช้ได้หมด ไม่ว่าจะเป็น output จาก kubectl logs, stderr ของ CI job หรือ tail ของไฟล์
- ตรวจสอบการตรวจจับรูปแบบ เครื่องมือตรวจจับรูปแบบจากสิ่งที่วางโดยอัตโนมัติ แวะดูรายการที่ parse แล้วว่าแยกเป็นบรรทัดได้สะอาด ถ้าแหล่งข้อมูลปนกันหลายรูปแบบ ระบบจะ fallback เป็น plain text ที่ยังกรองได้
- กรองตามระดับ ตอนเกิด incident ให้เริ่มจาก ERROR ก่อน แล้วค่อยเพิ่ม WARN และ DEBUG เมื่อต้องการดูเหตุการณ์นำไปสู่ความล้มเหลว level-stat bars จะบอกจำนวนเบื้องหลังทุกทางเลือก
- ค้นหาด้วย text filter พิมพ์ keyword เช่น ชื่อ service, HTTP status หรือชื่อตาราง การใช้ ERROR เท่านั้นควบคู่กับ keyword เดียวมักพอแยกสัญญาณออกจาก log พันบรรทัด
- เจาะเข้าไปดู error clusters cluster ใหญ่สุดมักคือ root cause ส่วน cluster เล็ก ๆ คือ long tail ที่น่าสนใจ เปิดดูรายการต้นทางใน scrollable view เพื่อเห็นบรรทัดจริง
จาก Noise สู่ Cluster
แนวคิดหลักของเครื่องมือนี้คือ log ที่วางลงไปไม่ใช่แค่ข้อความ แต่เป็นข้อมูลที่รอโครงสร้าง NDJSON เป็นรูปแบบที่สมบูรณ์ที่สุด แต่ละบรรทัดคือ object เต็มรูปแบบ ทำให้อ่านฟิลด์อย่าง level, timestamp และ message ได้โดยตรง logfmt เรียบกว่า เช่น level=error msg="connection refused" port=5432 แต่ก็ยังเป็น structured data ผ่านคู่ key=value ส่วน plain text เป็นตัวเลือกสุดท้าย มีแต่สิ่งที่โปรแกรมพิมพ์ออกมา โดยไม่การันตีว่าจะมีระดับความรุนแรงที่เครื่องอ่านได้เลย log viewer ที่ดีต้องรับแต่ละรูปแบบตามที่มันเป็น แทนที่จะบังคับให้คุณแปลงก่อน
เมื่อรายการมีโครงสร้างแล้ว level-stat bars จะตอบคำถามแรกที่ทุกคนถามกับ log dump คือ "หน้าตามันเป็นอย่างไร" แท่ง ERROR สูงเคียงข้างแท่ง INFO เตี้ย ๆ คือสัญญาณ incident ส่วน DEBUG ยาวเหยียดกับ WARN เพียงแท่งเดียว มักแปลว่าการรันครั้งนี้ปกติ เป็นการเช็กความเข้าใจในหนึ่งวินาทีที่กำหนดทิศทางของทุกอย่างถัดไป
จากนั้นมาถึง clustering และ digit normalization คือสิ่งที่ทำให้มันใช้ได้ในระดับใหญ่ ข้อความดิบเป็น grouping key ที่แย่มาก "user 4821 login failed" กับ "user 9317 login failed" เป็นสตริงต่างกัน แต่เหมือนกันในเชิงการทำงาน การแทนที่ช่วงตัวเลขด้วย placeholder ก่อนจัดกลุ่มทำให้ทั้งหมดรวมเป็น pattern เดียว และนั่นคือเหตุผลที่ "port 5432" กับ "port 5433" กลายเป็น cluster เดียว ถ้า database ทุกตัวใน pool ปฏิเสธการเชื่อมต่อ นั่นคือปัญหาเดียว ไม่ใช่ยี่สิบปัญหา
แต่ clustering เป็นเพียงเลนส์ ไม่ใช่คำตอบสำเร็จรูป ความล้มเหลวสองแบบที่ต่างกันจริงอาจ normalize เป็นรูปทรงเดียวกัน "disk 0 full" กับ "disk 1 full" เป็น disk คนละตัว และตัวหนึ่งเต็มไม่ได้แปลว่าทุกตัวเต็ม ในทางกลับกัน ตัวแปรที่สำคัญอย่าง "retries remaining: 3" กับ "retries remaining: 0" อาจซ่อนอยู่ใน cluster เดียวกัน นิสัยที่ควรฝึกคือ อ่านตัวนับของ cluster ในฐานะ "มีกี่บรรทัดที่หน้าตาแบบนี้" แล้วเปิดรายการจริงเพื่อยืนยันว่า pattern นั้นหมายความตรงตามที่คุณคิด
ตัวอย่างการใช้งานจริง
Triage Deploy ที่ล้มเหลวจาก Output ของ kubectl Logs
เมื่อ deploy เป็นสีแดง ให้วาง kubectl logs deploy/my-service --previous ลงใน Log Viewer แทนที่จะเลื่อนดูใน terminal level-stat bars บอกคุณได้ในไม่กี่วินาทีว่า crash นี้คือ error เดียวที่ท่วม หรือความล้มเหลวหลายแบบที่ค่อย ๆ ทวีขึ้น และ clusters จะจัดกลุ่ม panic messages ตาม pattern ที่ normalize แล้ว ถ้า cluster เดียวกิน error ถึง 90% คุณได้ root cause ก่อนนาทีที่สองของ incident
ไล่ดู Output ของ Cron Job
Cron job คือ log ที่ถูกลืมที่สุดของหลายระบบ output ของมันหายไปในอีเมลหรือไฟล์ที่ไม่มีใครตามดู ครั้งหน้าที่ job กลางคืนทำงานผิดปกติ ลองวาง output ที่จับได้ลงในเครื่องมือ การกรองเหลือ WARN กับ ERROR จะตัด progress lines ประจำวันออกไป และ clustering บอกได้ว่า job เจอความล้มเหลวแบบเดียวร้อยครั้ง หรือร้อยแบบครั้งเดียว ซึ่งคือความต่างระหว่าง dependency แบบ flaky กับ job ที่พังจริง
แชร์ Snippet ที่ล้างข้อมูลแล้วใน Code Review
Reviewer แก้ปัญหาไม่ได้ถ้ามองไม่เห็น แต่ log production ดิบ ๆ ที่มี user ID, token และ hostname ภายใน ก็ไม่ควรอยู่ใน pull request เพราะเครื่องมือนี้ทำงานทั้งหมดในเบราว์เซอร์ คุณจึงวาง output เต็ม กรองเหลือเฉพาะ ERROR บรรทัดที่เกี่ยวข้อง แล้วคัดลอกออกมาเฉพาะรายการที่จำเป็น โดยล้างข้อมูลอ่อนไหวออกตามต้องการ reviewer จะได้ทั้ง pattern และหลักฐาน โดยไม่ติด payload ติดมือไปด้วย
เช็กด่วนโดยไม่ต้องต่อ Log Platform
ไม่ใช่ทุก environment ที่สมควรมี logging stack เต็มรูปแบบ side project, Raspberry Pi ที่บ้าน หรือ staging box สำหรับ demo ลูกค้า บางที log ทั้งหมดของระบบก็คือไฟล์เดียว เครื่องมือ observability ตัวใหญ่คือของฟุ่มเฟือย ส่วนแนวทางวางแล้วดูคือคำตอบที่พอดี มันยังเป็นทางออกที่ถูกต้องเมื่อคุณมี log platform อยู่แล้ว แต่ log ที่ต้องการมาจากระบบที่ยังไม่ได้ส่งเข้าไป
แนวปฏิบัติที่ดี
- ล้าง secrets ก่อนนำ log ไปที่ใดก็ตาม เครื่องมือทำงานในเครื่อง แต่ทันทีที่คุณคัดลอกจากมันไปใส่ issue หรือ PR คุณกำลังย้าย log อีกครั้ง ตัด token, password, session ID และข้อมูลส่วนบุคคลออกก่อนเสมอ
- กรองเหลือ ERROR ก่อน แล้วขยายเมื่อจำเป็นเท่านั้น ยืนยันภาพแบบ ERROR-only ก่อน แล้วค่อยเพิ่ม WARN หรือ DEBUG เพื่อดูบริบท
- ใช้ clusters ประเมินขนาดความเสียหาย cluster ที่นับได้ 2 กับ cluster ที่นับได้ 2,000 ต้องตอบสนองต่างกัน แม้ข้อความจะเหมือนกันทุกตัวอักษร
- เก็บ timestamp ให้มองเห็นตอนเจาะลึก ลองดูว่า cluster ที่น่าสงสัยกระจายคล่องหลายชั่วโมงหรือรวมกันในหนึ่งนาที ความต่างนี้มักแยกปัญหาเชิงระบบออกจากเหตุครั้งเดียว
- อ่านตัวนับ cluster เป็นจุดเริ่มต้น ไม่ใช่คำตัดสิน digit normalization บางครั้งรวมสิ่งที่ต่างกันจริงเข้าด้วยกัน ให้เปิด cluster และยืนยันว่ารายการข้างในตรงกับป้าย pattern
- ตรวจการตรวจจับรูปแบบกับแหล่งที่ปนกัน ถ้าสิ่งที่วางมีทั้ง JSON lines และ stack trace ให้ยืนยันว่าการ parse แยกตรงจุดที่คาด แล้วใช้ text filter กับส่วนที่เหลือ
พร้อมเปลี่ยนกำแพง log ก้อนต่อไปของคุณให้เป็นลิสต์ pattern สั้น ๆ หรือยัง เปิด Log Viewer วาง log ของคุณ แล้วเริ่มจากแท่ง ERROR เลย root cause ของคุณน่าจะรออยู่ใน cluster ใหญ่ที่สุดเรียบร้อยแล้ว
เครื่องมืออื่น ๆ ที่คุณอาจสนใจ:
- Nginx Log Analyzer — เจาะลึก access log และ error log ของ web server คุณ
- JSON Formatter — จัดรูปและตรวจสอบ JSON payload ที่ซ่อนอยู่ใน log ของคุณ
- Cron Parser — ถอดรหัสและตรวจสอบ schedule เบื้องหลัง cron job log
ขอให้ debug สนุก!
คำถามที่พบบ่อย
ถ: Log Viewer อัปโหลด log ของฉันไปที่ไหนหรือเปล่า? ตอบ: ไม่ การ parse, การ filter, การนับสถิติระดับ และ error clustering ทั้งหมดทำงานในเบราว์เซอร์ของคุณ ข้อความ log ที่วางไม่เคยออกจากเครื่อง
ถ: รองรับรูปแบบ log แบบไหนบ้าง? ตอบ: NDJSON (JSON หนึ่ง object ต่อหนึ่งบรรทัด), logfmt (คู่ key=value คั่นด้วยช่องว่าง) และ plain text รูปแบบจะถูกตรวจจับอัตโนมัติ และ plain text ก็ยังกลายเป็นรายการที่ filter และจัดกลุ่มได้
ถ: Error clustering จัดการตัวเลขที่ต่างกันในข้อความอย่างไร? ตอบ: ช่วงตัวเลขจะถูกแทนที่ด้วย placeholder ก่อนจัดกลุ่ม "connection refused on port 5432" และ "connection refused on port 5433" จึงรวมเป็น cluster เดียว ข้อควรระวังคือมันอาจรวมความล้มเหลวที่ต่างกันจริงซึ่งต่างกันแค่ตัวเลขด้วย
ถ: รองรับไฟล์ log ขนาดใหญ่มากได้ไหม? ตอบ: เครื่องมือนี้ออกแบบมาสำหรับการวาง เช่น output ของ deploy ที่พัง, การรัน cron หรือ log tail ล่าสุดของ service ไม่ใช่ archive ขนาดกิกะไบต์ กับ log ที่ใหญ่มาก ให้วางเฉพาะช่วงที่เกี่ยวข้องแล้วค่อย filter จากจุดนั้น