คู่มือการใช้งาน Markdown Chunker: แบ่ง Markdown ยาวเป็น chunk ตาม token budget เพื่อ RAG
แบ่งเอกสาร Markdown ยาวเป็น chunk ตาม token budget สำหรับ RAG pipeline และ context window ของ LLM การแบ่งที่เข้าใจ Markdown ไม่ตัด code block หรือตารางขาด มี heading breadcrumb, ควบคุม overlap ได้ และ export JSONL — ทำงาน offline ทั้งหมด
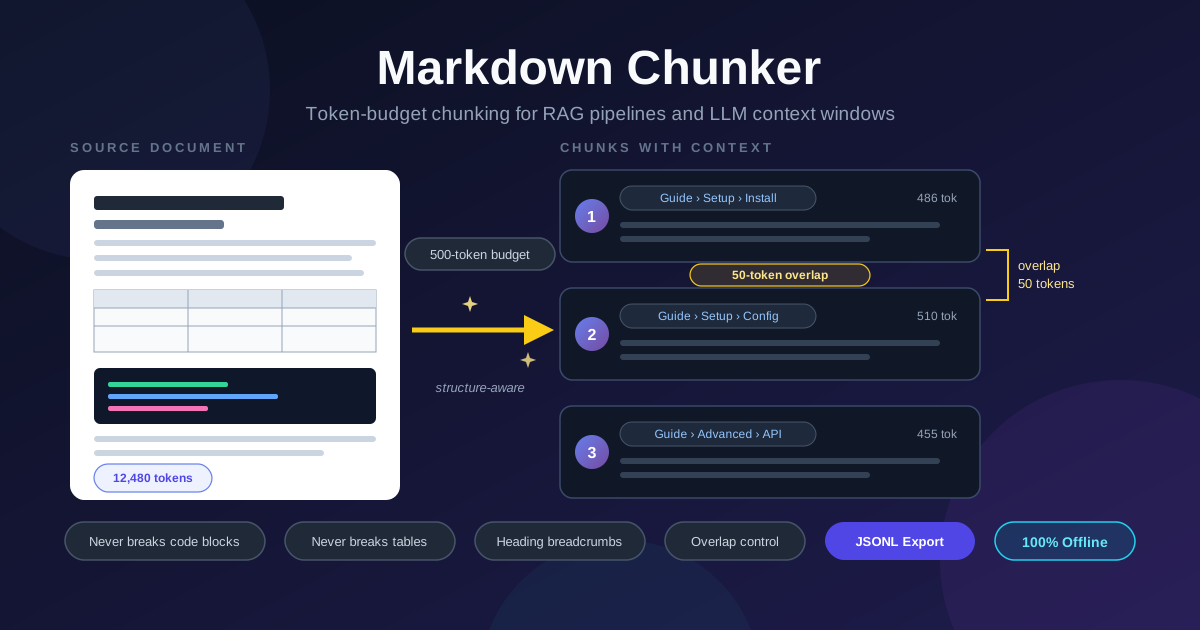
Table of Contents
คู่มือการใช้งาน Markdown Chunker: แบ่ง Markdown ยาวเป็น chunk ตาม token budget เพื่อ RAG
คุณภาพของ RAG ขึ้นอยู่กับขอบเขตของ chunk เป็นหลัก chunk ที่ตัดตารางอยู่ครึ่งหนึ่งจะเป็นพิษกับ retrieval ทันที: embedding ที่ได้บรรยายถึงครึ่งเดียวของตาราง, vector store เก็บ fragment ที่ไม่มีใครเข้าใจ และโมเดลที่ได้รับมาเป็นตารางหักทั้งไฟล์ สิ่งเดียวกันเกิดกับ code block ที่ถูกตัดกลาง fence — ทุกความพังพินาศแบบนี้เริ่มต้นจากการนับบรรทัดธรรมดา ๆ ใน ingestion script นั่นเอง
Markdown Chunker แก้ปัญหานี้ที่ต้นทาง เครื่องมือนี้แบ่งเอกสาร Markdown ยาวเป็น chunk ตาม token budget ด้วย parser ที่เข้าใจรูปแบบ Markdown จริง ๆ: code fence ไม่ถูกตัดขาด ตารางคงทุกแถวไว้ครบ และทุก chunk ติด heading breadcrumb กำกับไว้เสมอว่ามันมาจากส่วนไหนของเอกสาร คุณตั้ง token budget และ overlap ระหว่าง chunk ที่อยู่ติดกัน จากนั้น export เป็น JSONL เพื่อส่งเข้า embedding pipeline ได้เลย ทุกอย่างทำงานในเบราว์เซอร์แบบ offline 100% — ไม่มีการ upload ใด ๆ ซึ่งสำคัญมากเมื่อเอกสารที่แบ่งคือ wiki ภายในองค์กรหรือเอกสารลับของบริษัท
ทำไมต้องใช้ Markdown Chunker?
- การแบ่งแบบ naïve ทำลายคุณภาพ retrieval splitter แบบนับตัวอักษรไม่รู้ว่าอะไรคือ code fence อะไรคือย่อหน้า มันตัด block ที่อยู่ใน fence ครึ่งหนึ่งและตัดแถวท้าย ๆ ของตารางทิ้ง แล้ว embedding ทุกตัวที่สร้างจากนั้นก็รับความเสียหายต่อกันไป
- แต่ละ chunk มาพร้อมบริบทของตัวเอง ทุก chunk ถูกประทับ heading path ที่ให้กำเนิดมัน ทำให้ fragment ที่ถูกดึงมาจากคู่มือยังรู้ว่าตัวเองอยู่ในหมวด Installation
- Token budget ตรงกับความจริงของโมเดล โมเดลวัดกันด้วย token ไม่ใช่ตัวอักษร การตั้งงบเป็น token จึงการันตีว่าไม่มี chunk ไหนเกิน limit ของโมเดลโดยไม่รู้ตัว
- Overlap รักษาความต่อเนื่องข้ามขอบเขต chunk ที่อยู่ติดกันแชร์เนื้อหาท้ายกันตามค่าที่ตั้ง คำตอบที่คร่อมขอบเขตจึงยังประกอบกันได้จากสอง chunk
- Export JSONL หย่อนลง pipeline ได้ทันที หนึ่ง record ต่อหนึ่ง chunk พร้อม index, จำนวน token, breadcrumb และข้อความ — รูปแบบที่ ingestion script ส่วนใหญ่รออยู่แล้ว
- Offline เต็มรูปแบบและเป็นส่วนตัว การแบ่งเกิดขึ้น client-side ในเบราว์เซอร์ เอกสาร proprietary จึงไม่มีวันไปผ่าน server ไหน
ฟีเจอร์หลัก
| ฟีเจอร์ | สิ่งที่ทำ |
|---|---|
| Token-budget splitting | จัด block เข้า chunk จนถึงงบที่ตั้ง โดยวัดเป็น token ไม่ใช่ตัวอักษร |
| ขอบเขตที่เข้าใจ Markdown | ไม่ตัด code fence หรือตารางขาด ทุก block เคลื่อนย้ายระหว่าง chunk แบบทั้งก้อน |
| Heading breadcrumbs | ทุก chunk บันทึก section path เช่น Guide / Setup / Configuration |
| Overlap control | ส่งเนื้อหาท้าย chunk ไปทำซ้ำใน chunk ถัดไปตามค่าที่ตั้ง |
| JSONL export | ดาวน์โหลดหนึ่ง JSON record ต่อ chunk พร้อม index, tokens, heading และ text |
| 100% offline | parsing และการแบ่งทั้งหมดทำงานในเบราว์เซอร์ของคุณ |
จุดที่ควรเน้นมีสองอย่าง token estimator ให้เลือกวิธีประมาณที่ตรงกับ stack ของคุณ งบที่ตั้งในเครื่องมือจึงเป็นงบเดียวกับที่ pipeline เห็น และ สถิติแบบ live — จำนวน chunk, token รวม และ chunk ที่ใหญ่สุด — อัปเดตตามที่พิมพ์ ทำให้จับ chunk ที่เล็กหรือใหญ่ผิดปกติได้ก่อนมันเข้า index
วิธีการใช้งาน
- เปิด Markdown Chunker ในเบราว์เซอร์
- วางเอกสาร Markdown ลงในตัว editor หรือโหลด sample มาดูกลไกก่อน
- ตั้ง token budget ต่อ chunk — 500 เป็นค่าเริ่มต้นที่เหมาะกับ embedding model ทั่วไป งบที่ใหญ่กว่าเหมาะกับ LLM ที่มี context window ยาว
- ตั้ง overlap — ราว 50 token รักษาความต่อเนื่องได้โดยไม่ทำให้ index บวม
- ตรวจการ์ด chunk แต่ละใบที่โชว์ breadcrumb และจำนวน token แล้วกด Export JSONL
การแบ่ง chunk ที่เคารพโครงสร้างของเอกสาร
ปัญหาหลักของการแบ่งแบบ naïve คือ Markdown ไม่ใช่ข้อความแบน ๆ code fence เปิดด้วยบรรทัด marker แล้วปิดอีกทีหลายบรรทัดถัดมา ส่วนตารางคือ grid ที่ความหมายดับทันทีเมื่อแถวถูกแยกจากกัน การนับตัวอักษรตัดผ่านทั้งสองอย่างเพราะไม่รู้ว่าแต่ละบรรทัดแปลว่าอะไร Markdown Chunker ทำงานที่ระดับ block ไม่ใช่บรรทัด: มัน track สถานะ fence เพื่อให้ทุกอย่างระหว่าง marker เปิดกับ marker ปิดเดินทางไปด้วยกัน และถือว่าตารางเป็นหน่วยเดียวที่แยกไม่ได้ เมื่อ block ถัดไปจะทำให้ chunk เกินงบ chunk จะปิดที่ขอบเขตที่ปลอดภัยจุดสุดท้าย แล้ว block นั้นเริ่มต้น chunk ใหม่ — แบบทั้งก้อน
องค์ประกอบที่สองคือบริบท ลองดูตัวอย่างย่อจากคู่มือ:
api-guide.md — 3,120 tokens total

chunk 0   breadcrumb: API Guide / Getting Started            412 tokens
chunk 1   breadcrumb: API Guide / Getting Started / Auth     498 tokens
chunk 2   breadcrumb: API Guide / Endpoints / Users          486 tokens
ทุก chunk รู้ section path ของตัวเอง เมื่อผู้ใช้ถาม "ยืนยันตัวตนยังไง?" retriever จับคู่จากเนื้อหา และ breadcrumb บอก generator ว่าข้อความนี้มาจากหมวด Authentication — ซึ่งมักเป็นเส้นแบ่งระหว่างคำตอบที่อ้างขั้นตอนถูกกับคำตอบที่เดา
Overlap แก้ปัญหาความต่อเนื่องที่ตัวขอบเขตเลย สมมุติว่าย่อหน้าหนึ่งโต้แย้งคร่อมขอบ chunk: ข้ออ้างอยู่ท้าย chunk 1 ส่วนข้อสรุปเริ่มต้น chunk 2 เมื่อใช้ overlap 50 token ท้ายของ chunk 1 จะถูกทำซ้ำที่หัวของ chunk 2 การ retrieval ที่เจอแค่ฝั่งเดียวจึงยังมีเนื้อเชื่อมติดมาด้วย
Token budget สมควรได้รับการเลือกอย่างตั้งใจ embedding model จำกัด input ต่ำกว่า context window ของ LLM มาก — chunk ที่เกิน limit ของ embedder จะถูกตัดทอนเงียบ ๆ และค่อย ๆ ทำลาย vector ของมัน การ retrieval โดยทั่วไปชอบ chunk ที่เล็กและโฟกัส: 300–500 token คือช่วงที่นิยมสำหรับ RAG ส่วน chunk 1,000 token ขึ้นไปเหมาะกับการจัดของลง context window มากกว่าการสร้าง index
สุดท้าย JSONL export เปลี่ยน chunker ให้เป็นชิ้นส่วนของ pipeline — หนึ่ง record ต่อ chunk หนึ่งไฟล์ต่อเอกสาร:
{
  "index": 1,
  "tokens": 498,
  "heading": "API Guide / Getting Started / Auth",
  "text": "To authenticate, create an API key in the console and pass it as a bearer token..."
}
กรณีการใช้งานจริง
Ingestion Pipeline สำหรับ RAG
นี่คือบ้านเกิดของเครื่องมือนี้ ก่อนเอกสารถึง vector store ส่งมันผ่าน Markdown Chunker แล้ว export เป็น JSONL script ของคุณ embed ข้อความและเก็บ breadcrumb เป็น metadata ขอบเขตที่สะอาดทำให้ retriever เลิกคืน fragment ของตารางกับ code ครึ่ง fence ในที่สุด
เตรียม Context ให้ LLM
เมื่อต้องยัดเอกสารยาวลง context window ที่จำกัด token budget ทำหน้าที่เบ่งแบ่งให้ ตั้งงบเท่าที่ window รับได้ แล้วคุณจะได้ chunk กลุ่มที่เติมเต็มพอดี ทุกก้อนสมบูรณ์เชิงโครงสร้างและติดป้ายแหล่งที่มา
สร้าง Index สำหรับค้นหาเอกสาร
Search index ได้ประโยชน์จากวินัยแบบเดียวกับ vector store chunk กลายเป็น index document ที่มี breadcrumb เป็น title หรือ facet หมวดหมู่ ผลค้นหาคำว่า "retry policy" จะแสดงเป็น "Admin Guide / Reliability / Retry Policy" ไม่ใช่ fragment นิรนามที่ตามรอยไม่ได้
วิเคราะห์เนื้อหายาว
การส่ง whitepaper 40,000 token ให้นักวิเคราะห์หรือโมเดลในรอบเดียวเชิญชวนให้ข้าม ๆ อ่านและหล่นหายรายละเอียด แบ่งเป็น chunk ตามงบแล้วมันจะกลายเป็นคิวงานที่ตรวจทานได้: สรุปทีละ chunk และเทียบ breadcrumb เพื่อยืนยันว่าครบทุกส่วน
แนวทางปฏิบัติที่ดีที่สุด
- ให้แต่ละ chunk สมบูรณ์ในตัวเอง เชื่องขอบเขตเชิงโครงสร้างของเครื่องมือ — chunk ที่เล็กกว่านิดแต่จบที่ขอบจริงดีกว่า chunk ที่เต็มงบแต่จบกลางตาราง
- จูน overlap ตามความหนาแน่นของเนื้อหา ร้อยแก้วประโยคยาวคุ้มกับ overlap 50–100 token ส่วนเอกสารอ้างอิงแบบกระชับแทบไม่ต้องมีเลย
- จับคู่ token estimator กับ stack ของคุณ ปรับให้ตรงกับวิธีนับ token ของ pipeline เพื่อให้งบตรงกันตั้งแต่ต้นจนจบ
- Export JSONL แล้วสุ่มตรวจก่อน index เปิดดู record สัก few อันว่า breadcrumb กับจำนวน token สมเหตุผล — สามสิบวินาทีตรงนี้ช่วยประหยัดการ embed ใหม่ทั้งชุด
- ดู chunk ที่ใหญ่สุดในสถิติ outlier มักแปลว่ามี block ยักษ์หรือตารางที่มีปัญหา แก้เอกสารต้นทางแล้วการแบ่งจะสะอาดขึ้นเอง
- แบ่งใหม่เมื่อเอกสารเปลี่ยน index ของ chunk นิ่งเท่ากับเอกสารของมัน สร้างใหม่จากต้นฉบับปัจจุบันดีกว่าแก้ chunk เก่ากระจัดกระจาย
เริ่มส่ง chunk ที่คู่ควรกับการถูกค้นเจอ
Chunk ที่พังมองไม่เห็นจนกว่าวันที่แอป RAG ของคุณตอบคำถามจากครึ่งตาราง และวันนั้นการแก้หมายถึงการ embed ใหม่ทั้งหมด เริ่มจากขอบเขตที่สะอาดแทน: เปิด Markdown Chunker ตั้ง token budget กับ overlap เล็ก ๆ แล้ว export JSONL ที่ pipeline เชื่อถือได้ — ฟรี เป็นส่วนตัว และทำงานในเบราว์เซอร์ล้วน ๆ
เครื่องมือที่น่าสนใจเพิ่มเติม:
- JSONL Validator — ตรวจและจัดรูป JSONL export ทีละบรรทัดก่อนส่งเข้า ingestion pipeline
- Markdown Link Checker — สแกนหา broken link ในเอกสาร Markdown ก่อนแบ่งและเผยแพร่
- Text Case Converter — ปรับ heading และ title casing ให้สม่ำเสมอทั้งเอกสารก่อนแบ่งเป็น chunk
ขอให้ทุกขอบเขต chunk ของคุณลงตรงจุดที่โครงสร้างบอก!
คำถามที่พบบ่อย
ถ: เอกสารของฉันถูก upload ไปที่ไหนหรือเปล่า?
ตอบ: ไม่ครับ การ parsing, การแบ่ง และ export ทั้งหมดเกิดขึ้น client-side ในแท็บเบราว์เซอร์ของคุณแบบ offline เต็มรูปแบบ เอกสารภายใน เอกสาร proprietary และสเปกที่ยังไม่เปิดเผยจึงไม่มีวันออกจากเครื่อง
ถ: ควรตั้ง token budget ต่อ chunk เท่าไหร่?
ตอบ: สำหรับ RAG กับ embedding model ทั่วไป ช่วง 300–500 token เชื่อถือได้ ถ้าจัดของลง context window ให้ตั้งตามที่ window รับไหว สถิติ live จะโชว์ chunk ที่ใหญ่สุดเพื่อยืนยันว่าไม่มีอะไรเกิน limit ของ embedder
ถ: ควรตั้ง overlap เท่าไหร่?
ตอบ: เริ่มที่ราว 50 token เพิ่มขึ้นสำหรับร้อยแก้วแน่น ๆ ที่ข้อความคร่อมขอบเขต และลดลงเข้าใกล้ศูนย์สำหรับเอกสารอ้างอิงที่แต่ละส่วนสมบูรณ์ในตัว overlap ทำซ้ำเนื้อหาใน index ดังนั้น overlap ใหญ่มากจะทำให้ storage บวม
ถ: ใน JSONL export มีอะไรบ้าง?
ตอบ: หนึ่ง JSON record ต่อ chunk ที่มี index, จำนวน token, heading breadcrumb และข้อความเต็ม — อ่านทีละบรรทัด embed ฟิลด์ text แล้วเก็บที่เหลือเป็น metadata