Markdown Link Checker: เช็ก link เสียใน Markdown ก่อนคนอ่านคลิก
สแกน Markdown หา link ที่รูปแบบผิด: URL ว่าง, ช่องว่างใน URL, วงเล็บไม่ปิด, reference label ที่ไม่มีนิยาม และนิยามที่ซ้ำหรือไม่ถูกใช้ — พร้อมเลขบรรทัด, severity filter และรายงาน plain text ทำงาน 100% ในเบราว์เซอร์
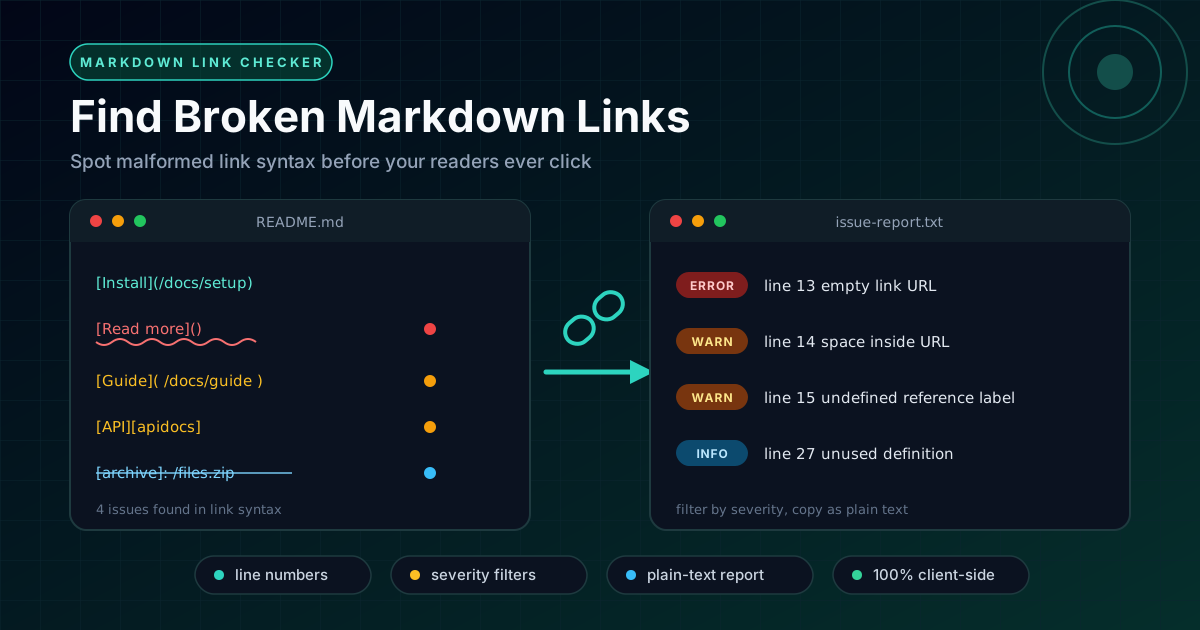
Table of Contents
Markdown Link Checker: เช็ก link เสียใน Markdown ก่อนคนอ่านคลิก
link เสียคือบั๊กที่น่าอายที่สุดในงาน documentation เพราะมันไม่เคยทำให้อะไรพังให้เห็น หน้าเว็บเรนเดอร์ได้ปกติ ข้อความอ่านลื่น ผู้อ่านจะเจอปัญหาตอนที่มันคลิกลงไปเท่านั้น — เจอหน้า 404 หรือไม่เจออะไรเลย ตอนนั้นความเชื่อมั่นพังไปแล้ว ทั้งที่สาเหตุคือ typo ตัวเดียวที่นั่งซ่อนอยู่ในไฟล์มาหลายสัปดาห์
ที่แย่กว่านั้นคือ link ใน Markdown มักพังแบบเงียบ ๆ URL ว่าง, ช่องว่างที่หลุดเข้าไปในวงเล็บ, หรือ reference label ที่ถูกเปลี่ยนชื่อไปโดยไม่มีใครรู้ ทั้งหมดนี้ไม่ throw error ใน editor และไม่ดูผิดตาใน preview เลย Markdown Link Checker ถูกสร้างมาเพื่อทำให้ความพังแบบเงียบ ๆ เหล่านี้ดังขึ้น: สแกนเอกสารของคุณ ชี้ทุก link ที่รูปแบบผิดพร้อมเลขบรรทัด แล้วส่งรายงานแยกตาม severity ให้แก้ได้ทันที
คู่มือนี้พาไปดู 5 รูปแบบที่ link ใน Markdown พังบ่อยที่สุด วิธีอ่านรายงานและจัดลำดับตาม severity และจุดที่การเช็ก link ควรอยู่ใน workflow การเผยแพร่เอกสารจริง
ทำไมต้องใช้ Markdown Link Checker
- จับจุดที่ preview มองข้าม — link ที่มี URL ว่างหรือมีช่องว่างใน URL ก็ยัง "ดูเหมือน" link ปกติใน preview แต่การสแกนระดับ syntax เห็นสิ่งที่ parser เห็นจริง ซึ่งตัดสินว่าคลิกแล้ว work หรือไม่
- บอกเลขบรรทัดเป๊ะ — ทุก issue ชี้ไปที่บรรทัดนั้น ๆ กระโดดไปแก้ได้เลย ไม่ต้องไล่หาวงเล็บเดียวที่หายไปทั่วทั้งไฟล์
- แยกปัญหาตาม severity — link ที่พังให้ผู้อ่านเห็น กับ definition ที่ไม่มีใครใช้ ไม่ใช่ปัญหาระดับเดียวกัน severity filter ช่วยให้ไล่แก้ตามลำดับได้
- เข้าใจ reference-style link — ตรวจว่าทุก [text][label] มี definition รองรับ และรายงาน label ที่นิยามซ้ำหรือไม่เคยถูกใช้
- ได้รายงาน plain text — คลิกเดียว copy ผลทั้งหมดไปแปะใน pull request หรือ CI log ได้เลย ไม่ต้อง screenshot
- ทำงาน 100% ในเครื่อง — ทุกอย่างเกิดใน browser ของคุณ เอกสารภายในและ draft ที่ยังไม่เผยแพร่ไม่หลุดออกไปไหน
ฟีเจอร์หลัก
| สิ่งที่ตรวจจับ | หาอะไร | สาเหตุที่พบบ่อย |
|---|---|---|
| URL ว่าง | link ที่วงเล็บไม่มีอะไรข้างใน | เขียนไว้เป็น placeholder แล้วลืมใส่ URL |
| ช่องว่างใน URL | whitespace ในหรือรอบ ๆ URL | paste URL, export จาก wiki หรือ CMS |
| วงเล็บไม่ปิด | เปิดวงเล็บแล้วไม่มีวงเล็บปิดคู่กัน | ลบวงเล็บหาย หรือ URL มีวงเล็บในตัวเอง |
| reference label ไม่มีนิยาม | ใช้ label แต่ไม่มี definition ในไฟล์ | เปลี่ยนหรือลบ definition, พิมพ์ label ผิด |
| นิยามซ้ำ | label เดียวกันนิยามหลายครั้ง | merge งานจากสอง branch |
| นิยามไม่ถูกใช้ | มี definition แต่ไม่มี link อ้างถึง | แก้เนื้อหาแล้วทิ้ง definition ไว้ |
จุดที่ทำให้รายงานนี้ใช้งานจริงได้:
- เร็วและทำซ้ำได้ — paste, อ่านผล, แก้, paste ใหม่ ไม่มีขั้นตอน setup หรือ install
- ผลลัพธ์พกพาได้ — severity filter ช่วยคุมเอกสารยาว ๆ และรายงาน plain text แปะลง merge request ได้สบาย
วิธีใช้งาน
- เปิดเครื่องมือ — เข้า Markdown Link Checker แล้ว paste Markdown ของคุณ ไม่ว่าจะเป็น README, หน้า docs หรือ draft บทความ
- รอสแกน — การวิเคราะห์เกิดขึ้นทันทีใน browser ไม่มีขั้นตอน upload
- อ่านรายงาน — แต่ละ finding แสดงเลขบรรทัด ชนิดของปัญหา และ severity
- กรองแล้วแก้ตามลำดับ severity — ดึงปัญหา impact สูงขึ้นมาก่อน เด้งไปทีละบรรทัด แล้วแก้
- สแกนซ้ำและแชร์ผล — paste เอกสารที่แก้แล้วกลับเข้ามายืนยันว่ารายงานสะอาด จากนั้น copy รายงานใส่ pull request เพื่อให้ reviewer เห็นว่าเช็กแล้ว
5 วิธีที่ link ใน Markdown พัง
นี่คือ 5 failure mode ที่เครื่องมือตรวจจับ เรียงคร่าว ๆ ตามระดับความเจ็บที่ผู้อ่านต้องรับ
1. URL ว่าง
อ่าน [เอกสารฉบับเต็ม]() ก่อนเริ่มงาน
มันเรนเดอร์เป็น link ที่ดูคลิกได้ แต่ปลายทางว่างเปล่า คลิกแล้วไม่เกิดอะไรหรือ reload หน้าเดิม — dead end ชนิดหนึ่ง เกิดตอนที่คนเขียนเนื้อหาก่อนแล้วลืมใส่ URL
วิธีแก้: ใส่ URL หรือถ้ายังไม่มีปลายทาง ก็ถอด link markup ออกแล้วใช้ข้อความธรรมดา
2. ช่องว่างใน URL
ดูคู่มือ [เริ่มต้นใช้งาน](/docs/getting-started) สำหรับขั้นตอน setup
นี่คือรูปแบบพังคลาสสิกจากการ migrate wiki เนื้อหาที่ export จาก wiki, CMS หรือโปรแกรม word processor มักแทรกช่องว่างในวงเล็บ แล้ว parser หลายตัวจะ resolve URL ไม่ได้ — link ตายเงียบ ๆ ทั้งที่ source ดูปกติ การ paste URL ที่มีช่องว่างจริงโดยไม่ encode ก็เจอปัญหาเดียวกัน
วิธีแก้: ลบ whitespace ทั้งหมดในวงเล็บ ถ้า URL จริงมีช่องว่าง ให้ percent-encode เป็น %20
3. วงเล็บไม่ปิด
ดูรายละเอียด [API reference](https://example.com/api เพิ่มเติม
วงเล็บปิดที่หายไปทำให้ parser ต้องเดาว่า URL จบตรงไหน บาง renderer กลืนข้อความที่เหลือทั้งประโยคเข้าไปใน link บางตัวปล่อยทั้งหมดเป็นข้อความธรรมดา ปัญหานี้มักเกิดตอนที่ URL เองมีวงเล็บอยู่ข้างใน เช่น URL จาก Wikipedia
วิธีแก้: ปิดวงเล็บให้ครบ และ percent-encode วงเล็บที่เป็นส่วนของปลายทางจริง ๆ (%28 และ %29)
4. reference label ไม่มีนิยาม
ดูรายละเอียดได้ที่ [คู่มือ API][apidocs]
ถ้าไม่มี [apidocs]: https://... อยู่ในเอกสารเลย link แบบ reference จะเรนเดอร์เป็นข้อความธรรมดาที่มีวงเล็บติดหัวติดหาง นี่คือเหยื่อรายแรกของการ refactor: เปลี่ยนชื่อ definition, ลบ section ท้ายไฟล์ หรือพิมพ์ label ผิดไปหนึ่งตัวอักษร
วิธีแก้: เพิ่ม definition ที่หายไป หรือเปลี่ยนเป็น inline link ถ้าใช้ครั้งเดียวอยู่แล้ว
5. นิยามซ้ำหรือไม่ถูกใช้
[docs]: https://example.com/docs/v1
[docs]: https://example.com/docs/v2
[changelog]: https://example.com/changelog
นิยามซ้ำเป็นอันตรายแบบเงียบ ๆ: renderer ส่วนใหญ่ให้นิยามตัวท้ายชนะ ทุก link [docs] ในเอกสารจะชี้ไป URL ตัวที่สองเงียบ ๆ ซึ่งอาจเป็นตัวผิด ส่วน definition ที่ไม่มีใครใช้อย่าง [changelog] ไม่ได้ทำร้ายผู้อ่าน แต่ทำให้คนดูแลโค้ดเข้าใจผิด
วิธีแก้: ให้ label หนึ่งตัวมี definition เดียว และลบ definition ที่ไม่มี link อ้างถึง
severity และลำดับการ triage
URL ว่าง, ช่องว่างใน URL และวงเล็บไม่ปิด คือ severity สูงสุด — ทำให้เกิด link พังหรือ link หายที่ผู้อ่านทุกคนเจอได้ ตามด้วย reference label ไม่มีนิยาม: ผู้อ่านเห็นวงเล็บดิบ ๆ แทน link ต่อมาคือนิยามซ้ำ เพราะ link ยังทำงานแต่อาจพาไปผิดที่ นิยามไม่ถูกใช้คือ severity ต่ำสุด: เรื่องความสะอาดล้วน ๆ triage tier บนก่อน กวาด tier กลาง แล้วค่อยเก็บงาน cleanup ท้าย session
กรณีใช้งานจริง
เช็ก README ก่อนเผยแพร่
README คือหน้าประตูของ repository ที่คนหลายมือแก้ไขต่อกันมาหลายปี สแกนก่อนทุก release: link เสียใน README แพงกว่าที่คิด เพราะ visitor ทุกคนเห็น รวมถึงคนที่กำลังตัดสินใจว่าจะใช้โปรเจกต์คุณหรือไม่
เว็บไซต์ documentation
เอกสารยาว ๆ มักสะสม reference-style link ที่ definition อยู่ห่างจากจุดใช้ออกไปหลายสิบบรรทัด — ระยะที่การเปลี่ยนชื่อและการลบเนื้อหาหลุดสายตาพอดี สแกนก่อน deploy docs ทุกครั้งจะจับ label ที่ไม่มีนิยามและ definition ที่เก่าไปแล้ว ซึ่ง reviewer คนเดียวจับไม่ไหว
draft บทความบล็อก
บทความเขียนเร็วและใส่ link แบบไม่ทันตรวจ เช็กก่อนกด publish จะจับ placeholder ที่ตั้งใจจะใส่ URL แล้วลืม และ URL ที่ paste เพี้ยนพร้อมช่องว่างซ่อนอยู่ข้างใน
ตรวจงานหลัง migration
การย้ายเนื้อหาระหว่างแพลตฟอร์ม — จาก wiki มา docs site หรือจาก HTML มา Markdown — คือแหล่งเพาะพันธุ์ปัญหาช่องว่างใน URL สแกนทุกไฟล์ที่ย้ายมาตั้งแต่วันแรก จะได้เจอปัญหาเป็นระบบตั้งแต่ต้น ไม่ใช่มานั่งรับ report จากผู้อ่าน
แนวปฏิบัติที่ดี
- ใช้ reference-style link กับ URL ที่ใช้ซ้ำ — URL ที่โผล่ตั้งแต่สามครั้งขึ้นไปควรอยู่ใน definition เดียว เวลาแก้ก็แก้จุดเดียว
- เช็กก่อน merge ทุกครั้ง ไม่ใช่หลัง publish — การเช็ก link ใช้เวลาไม่กี่วินาที ควรอยู่ใน slot เดียวกับการ proofread
- เก็บรายงานไว้ใน CI log หรือ PR description — รายงาน plain text สร้างหลักฐานที่ reviewer ตรวจสอบย้อนหลังได้
- label หนึ่งตัวมี definition เดียว — นิยามซ้ำ resolve แบบกำกวม และกฎ "ตัวท้ายชนะ" ไม่ใช่กฎที่ใครควรพึ่งพา
- percent-encode ตัวอักษรพิเศษใน URL — ช่องว่างและวงเล็บควรอยู่ในรูป encode เพื่อไม่ให้ syntax กับ URL ตีกันเอง
- จับคู่การเช็ก syntax กับ preview — checker จับสิ่งที่ parser เห็น ส่วน Markdown Preview ยืนยันสิ่งที่ผู้อ่านจะเห็น
ลองใช้เลย
หยิบเอกสารที่ถูกแก้บ่อยที่สุดของคุณมา paste ลง Markdown Link Checker แล้วดูว่ามีอะไรซ่อนอยู่ข้างใน ทำงานทั้งหมดใน browser ไม่ต้อง sign-up และได้รายงานแยกตาม severity ภายในไม่กี่วินาที
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Markdown Preview — เรนเดอร์ Markdown ให้เห็นแบบเดียวกับที่ผู้อ่านจะเห็น ก่อนเผยแพร่จริง
- HTML Tag Remover — ล้าง markup ให้เหลือข้อความธรรมดาสะอาด ๆ เวลาแปลงเนื้อหาออกจาก HTML
- Regex Railroad Diagram Generator — เปลี่ยน regex ที่ซับซ้อนให้เป็นแผนภาพที่อ่านออก
ขอให้ทุกคลิกไปถึงปลายทางที่ผู้อ่านคาดหวัง
คำถามที่พบบ่อย
ถ: เครื่องมือเช็กให้ไหมว่าหน้าปลายทางยังมีอยู่จริง?
ตอบ: ไม่เช็กครับ เครื่องมือตรวจ link syntax ว่าแต่ละ link มีรูปแบบถูกต้องหรือไม่ ไม่ได้ไปยิงดูว่า URL ปลายทางตอบกลับหรือเปล่า การตรวจระดับ syntax เร็วและ deterministic และจับ failure mode ที่อยู่เบื้องหลัง link เสียส่วนใหญ่ในทางปฏิบัติได้ครบ
ถ: Markdown ของผมถูกส่งขึ้น server ไหม?
ตอบ: ไม่ครับ การสแกนทำงาน 100% ใน browser ของคุณ เอกสารไม่หลุดออกจากเครื่อง เหมาะกับเอกสารภายใน, draft ที่ยังไม่เผยแพร่ และงานที่อยู่ภายใต้ข้อตกลงการรักษาความลับ
ถ: severity ระดับไหนควรบล็อกการเผยแพร่?
ตอบ: กฎที่ใช้ได้จริงคือ URL ว่าง, URL มีช่องว่าง และวงเล็บไม่ปิด ควรบล็อกการ publish ส่วน reference label ที่ไม่มีนิยามควรบล็อกกับเอกสารที่ผู้อ่านภายนอกเห็น ส่วนนิยามซ้ำและนิยามไม่ถูกใช้เป็นงาน cleanup ที่จัดตารางเก็บทีหลังได้
ถ: รองรับ reference-style link ด้วยหรือแค่ inline link?
ตอบ: รองรับทั้งคู่ครับ inline link ถูกตรวจหา URL ว่าง, URL ที่มีช่องว่าง และวงเล็บที่ไม่ปิด ส่วน reference-style link ถูกตรวจกับ definition ของมัน รวมถึง label ที่นิยามซ้ำและไม่เคยถูกใช้
ถ: ต้องติดตั้งอะไรหรือสมัครสมาชิกไหม?
ตอบ: ไม่ต้องเลย เปิดหน้าเครื่องมือ paste เอกสาร แล้วอ่านรายงานได้ทันที ทุกอย่างทำงานใน browser โดยไม่มี account, ไม่มี config และไม่มีข้อมูลออกจากเครื่องคุณ