ประเมินค่า training โมเดลก่อนเสียเงินแม้แต่ GPU-hour เดียว
ใช้ Model Training Cost Calculator แปลงจำนวน parameters, tokens และราคา GPU ให้เป็นตัวเลขต้นทุนที่ใช้วางแผนได้จริง พร้อมตารางเทียบราคาผู้ให้บริการ cloud
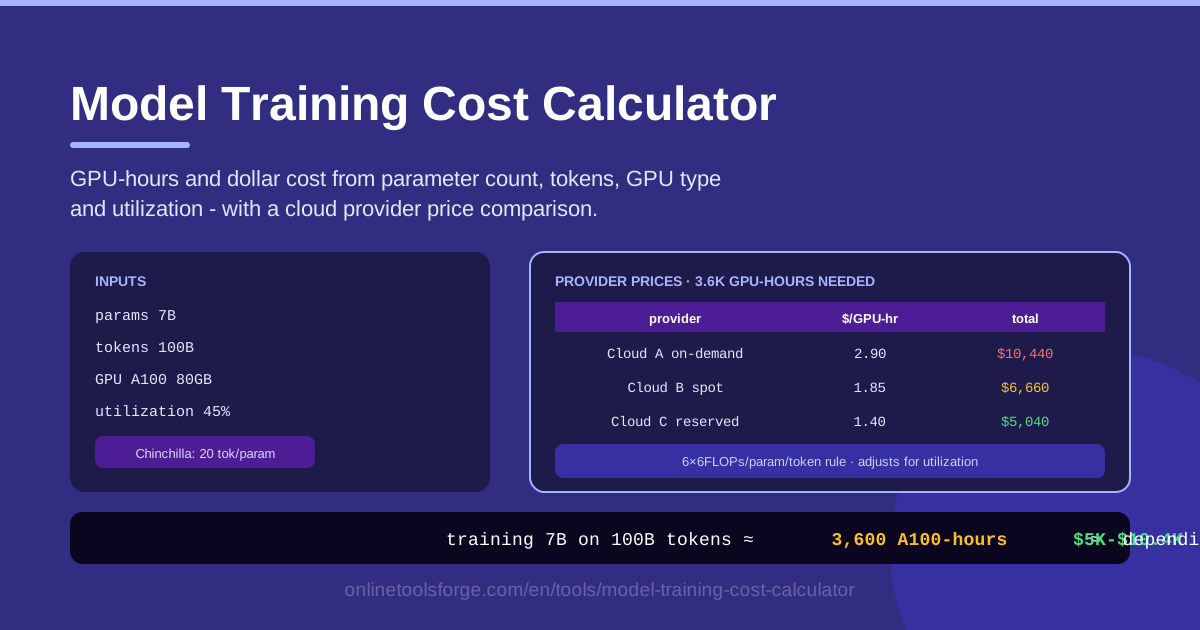
Table of Contents
การ train โมเดลของตัวเองฟังดูเป็นปัญหาทางวิศวกรรม จนกระทั่งใบแจ้งหนี้ใบแรกมาถึง Run ที่ดูไม่น่ากลัวบนกระดาษอาจกิน GPU-hours หลักพันโดยไม่รู้ตัว และสมมติฐานเรื่อง utilization ที่ optimistic เกินจริงเพียงอย่างเดียวก็อาจทำให้บิลสุดท้ายบานปลายไปหลายหมื่นดอลลาร์ Model Training Cost Calculator เปลี่ยนการเดาให้กลายเป็นการคำนวณ: ใส่จำนวน parameters, จำนวน tokens, ชนิด GPU และ utilization ที่คาดหวัง เครื่องมือจะประเมิน GPU-hours รวม ต้นทุนเป็นดอลลาร์ และแสดงตารางเทียบราคาผู้ให้บริการ cloud ให้ทันที ที่สำคัญคือทุกอย่างทำงานในเบราว์เซอร์ คุณจึงลองเล่นตัวเลขได้ทันทีกลางที่ประชุม โดยไม่ต้องตั้งสเปรดชีตหรือรอใครมาคำนวณให้
หลักคณิตศาสตร์เบื้องหลังคือสิ่งเดียวกับที่ทีมวิศวกรใช้เขียนในเอกสารวางแผน compute สำหรับ training มีสเกลประมาณ 6 × parameters × tokens ส่วนราคาขึ้นอยู่กับว่าต้องใช้ GPU กี่ตัวเพื่อส่งมอบ compute นั้นด้วยประสิทธิภาพระดับที่ทำได้จริง หลักการเดียวกันนี้ใช้ได้ทั้งงานทดลองระดับ 7B และงาน pretrain ระดับ 70B ภายใต้วิธีคิดเดียวกัน
บทความนี้จะอธิบายว่าเครื่องมือทำอะไรบ้าง ใช้งานทีละขั้นตอนอย่างไร กฎ FLOPs มาจากไหน และที่สำคัญไม่แพ้กันคือประมาณการแบบนี้ตั้งใจไม่รวมอะไรไว้บ้าง เพื่อให้คุณกันงบส่วนเผื่อได้ถูกจุดสำหรับความวุ่นวายของ training run จริง เพราะไม่ว่าวิธีคำนวณจะดีแค่ไหน ตัวเลขที่ได้ก็ยังเป็นจุดตั้งต้นสำหรับการวางแผน ไม่ใช่คำสัญญาที่การันตีผล
ทำไมต้องใช้ Model Training Cost Calculator?
- กันงบก่อนลงมือ ได้ตัวเลขเป็นดอลลาร์ที่ป้องกันตัวได้ ก่อนที่คุณจะผูกมัดกับการจอง GPU, สัญญา cloud หรือแผนงานที่สมมติว่า run จะเสร็จภายในไตรมาสนี้ ตัวเลขที่มาจากวิธีคิดที่ชัดเจนยังช่วยให้การขออนุมัติผ่านง่ายขึ้นด้วย
- เทียบผู้ให้บริการ cloud ข้างต่อข้าง GPU-hours เท่ากันแต่ราคาต่างกันมากในแต่ละผู้ให้บริการ ตารางเปรียบเทียบทำให้เห็นช่วงราคาได้ภายในไม่กี่วินาที
- ทดสอบการตัดสินใจเรื่องสเกล ถ้าเพิ่ม parameters หรือ tokens เป็นเท่าตัว compute ก็เพิ่มตามเกือบเท่าตัว การเห็นตัวเลขเปลี่ยนแบบสด ๆ ทำให้ trade-off กลายเป็นรูปธรรม
- คุยภาษาเดียวกับทีมการเงิน ประโยคแบบ "ประมาณ 38,000 GPU-hours ราว $92,000 กับผู้ให้บริการ X" ฟังต่างจาก "ใช้เวลาสักพักบนคลัสเตอร์ใหญ่" อย่างสิ้นเชิง
- เลี่ยงกับดัก utilization GPU ที่โฆษณาตามค่า peak performance มักส่งมอบไม่ถึงระดับนั้นตอน training จริง เครื่องมือคำนึงถึง utilization ที่สมจริงไว้ในสูตรแล้ว
- ใช้ได้ทุกที่ทันที ทุกอย่างประมวลผลในเบราว์เซอร์ ไม่ต้องสมัครสมาชิก ไม่มีการอัปโหลดข้อมูล และไม่ต้องดูแลเทมเพลตสเปรดชีตอีกต่อไป
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| จำนวน parameters | ใส่ขนาดโมเดลหน่วย parameters (7B, 13B, 70B) เป็นฐานของการประเมิน |
| จำนวน tokens | ระบุจำนวน training tokens ที่ run จะประมวลผล |
| ชนิด GPU | เลือกฮาร์ดแวร์ที่วางแผนจะเช่า เพื่อให้ peak throughput ใกล้เคียงความจริง |
| Utilization | ตั้งค่าสัดส่วนของ peak performance ที่คลัสเตอร์จะรักษาไว้ได้จริง |
| ประเมิน GPU-hours | แปลง FLOPs รวมของ training เป็นจำนวน GPU-hours ที่ต้องใช้ |
| ต้นทุนและตารางราคา | คิดราคาจาก GPU-hours และเทียบผู้ให้บริการ cloud ในหน้าเดียว |
| ทำงานในเบราว์เซอร์ | คำนวณทุกอย่างในเครื่องของคุณ ไม่มีข้อมูลออกจากอุปกรณ์ |
จุดที่ควรสังเกตเพิ่มเติม:
- เครื่องมือใช้กฎ FLOPs มาตรฐานสำหรับ training คือประมาณ 6 × parameters × tokens ทำให้ประเมินได้เร็วและโปร่งใส ต่างจากการแสร้งว่าจำลองสถาปัตยกรรมของคุณได้แม่นยำทุกกรณี
- Utilization เป็น input หลัก ไม่ใช่ค่าคงที่ที่ซ่อนไว้ คุณจึงเทียบคลัสเตอร์ที่ tune ดีกับคลัสเตอร์ที่มีปัญหา แล้วเห็นผลต่างออกมาเป็นตัวเงินได้ทันที
- ผลลัพธ์อัปเดตทันทีที่คุณแก้ input คุณจึงลองขยับจำนวน parameters ขึ้นลงเพื่อดูเส้นโค้งต้นทุนได้แบบเรียลไทม์ โดยไม่ต้องกดคำนวณใหม่ทีละรอบ
วิธีใช้งาน Model Training Cost Calculator
- ใส่จำนวน parameters พิมพ์ขนาดโมเดล เช่น 7,000,000,000 สำหรับโมเดล 7B ถ้ายังเลือกขนาดไม่ได้ ให้รันเครื่องมือทีละตัวเลือกเพื่อเทียบกัน
- ใส่จำนวน tokens เพิ่มจำนวน training tokens งานวิเคราะห์ Chinchilla เสนอว่าประมาณ 20 tokens ต่อ parameter คือจุด compute-optimal แต่งบประมาณด้านข้อมูลของคุณอาจบังคับให้ใช้น้อยกว่านั้น
- เลือกชนิด GPU เลือกฮาร์ดแวร์ที่วางแผนจะเช่า รุ่นใหม่ให้ FLOPs ต่อ GPU-hour สูงกว่า ทำให้ทั้งจำนวนชั่วโมงและเวลาจริงของการ train สั้นลง
- ตั้งค่า utilization ใส่ประสิทธิภาพที่คาดว่า training stack จะทำได้ ถ้ายังไม่มีข้อมูลวัดจริง ให้เริ่มแบบอนุรักษ์นิยม ช่วง 30-40 เปอร์เซ็นต์เป็นตัวเลขวางแผนที่ป้องกันตัวได้สำหรับ distributed training
- อ่าน GPU-hours แล้วเทียบราคา เครื่องมือแสดง GPU-hours รวมและต้นทุน ส่วนตารางผู้ให้บริการแสดงว่างานชุดเดียวกันราคาเท่าไรที่ไหน จับภาพหน้าจอเก็บไว้เลย เหมาะกับสไลด์นำเสนอมาก ถ้าตารางแสดงว่าราคาต่างกันหลายเท่าระหว่างผู้ให้บริการ นั่นคือสัญญาณให้ขอใบเสนอราคาจากหลายฝ่ายก่อนตัดสินใจ
จาก FLOPs สู่ดอลลาร์
กฎประมาณ 6 × parameters × tokens คือแกนหลักของการประเมิน training ที่จริงจังทุกแบบ สำหรับ dense transformer forward pass หนึ่งรอบใช้ราว 2 FLOPs ต่อ parameter ต่อ token และ backpropagation เพิ่มอีกประมาณเท่าตัวคือราว 4 FLOPs รวมกันแล้ว token หนึ่งตัวมีต้นทุนประมาณ 6 × parameters FLOPs คูณด้วยจำนวน tokens ก็ได้ compute รวมทั้งหมดของการ train ที่มาของข้อค้นพบ Chinchilla ก็อยู่ตรงนี้เช่นกัน: การ train ที่ compute-optimal ใช้ราว 20 tokens ต่อ parameter ซึ่งเป็นค่าเริ่มต้นที่มีหลักการรองรับ สำหรับวันที่คุณยังไม่มีตัวเลขอื่นให้อ้างอิง
Utilization หรือที่มักเรียกกันว่า MFU (model FLOPs utilization) คือจุดที่ประมาณการมีชีวิตหรือพังทลาย มันคือสัดส่วนของค่า peak ทางทฤษฎีที่ training loop ของคุณรักษาไว้ได้จริง และ run จริงส่วนใหญ่มักอยู่แถว 30-50 เปอร์เซ็นต์ เพราะเวลาหายไปกับ optimizer step, การสื่อสารระหว่าง GPU และการโหลดข้อมูล ยิ่งโมเดลเล็กแต่รันบนคลัสเตอร์ใหญ่ overhead ของระบบก็ยิ่งกินสัดส่วน utilization มากขึ้น การสมมติ 50 เปอร์เซ็นต์แต่ทำได้จริงแค่ 30 ไม่ใช่ความคลาดเคลื่อนเล็กน้อย แต่คืองบที่บานปลายไปราว 67 เปอร์เซ็นต์
ชนิด GPU เปลี่ยนสมการสองทางพร้อมกัน ด้านแรกคือ peak throughput ที่ต่างกันมาก H100 ให้ FLOPs ต่อวินาทีสูงกว่า A100 อย่างเห็นได้ชัด งานชุดเดียวกันจึงใช้ GPU-hours น้อยลง ด้านที่สองคือ utilization ที่ทำได้จริงก็ขึ้นกับฮาร์ดแวร์ด้วย memory bandwidth, ความเร็ว interconnect และคุณภาพ kernel ล้วนกำหนดว่าคุณจะรักษาระดับ peak ไว้ได้มากน้อยแค่ไหน เครื่องมือจึงถามชนิด GPU และ utilization แยกจากกัน แทนที่จะยุบรวมเป็นตัวคูณเดียว
อีกมุมที่ควรดูคือเวลาจริง GPU-hours บอกปริมาณงาน แต่ไม่ได้บอกว่างานจะเสร็จเมื่อไร ถ้าประมาณการออกมา 20,000 GPU-hours และคุณเช่าได้ครั้งละ 64 ตัว run หนึ่งรอบจะใช้เวลาราวสองสัปดาห์ ไม่รวมเวลาตั้งค่าและรอคิว ตัวเลขนี้สำคัญกับทีมผลิตภัณฑ์พอ ๆ กับต้นทุน เพราะมันกำหนดว่าจะได้โมเดลรุ่นใหม่ไปทดลองเมื่อไร และอย่าลืมเผื่อเวลาสำหรับการทดลองย่อยก่อน run จริง เพราะในทางปฏิบัติทีมมักใช้เวลาไปกับรอบทดสอบเกือบเท่ากับรอบหลัก
ราคาคือชั้นสุดท้ายของการคำนวณ spot หรือ preemptible capacity มักถูกกว่า 60-90 เปอร์เซ็นต์ แต่ผู้ให้บริการสามารถเรียกเครื่องคืนกลาง run ได้ จึงต้อง checkpoint ถี่ ๆ ไว้เสมอ กฎง่าย ๆ คือถ้ายัง checkpoint ไม่ทัน อย่าเอา spot ไปใช้กับงานใหญ่ ส่วน reserved pricing แลกส่วนลดกับการผูกมักระยะยาว และอย่าลืมว่าประมาณการนี้ไม่รวม: การเตรียมข้อมูล, run ที่ล้มเหลว, ablation, ค่า evaluation, storage และ token ทุกตัวที่โมเดลเสร็จแล้วจะเสิร์ฟเป็น inference ต่อไป ให้ถือว่าตัวเลขที่ได้คือค่าของ run ที่สำเร็จหนึ่งครั้ง แล้วค่อยวางแผนกันเผื่อจากจุดนั้น
กรณีใช้งานจริง
จัดงบสำหรับ fine-tune
การ fine-tune โมเดล 13B บน tokens 1 พันล้านตัว ใช้ compute ราว 78 exaFLOPs ที่ utilization ระดับสมจริง ตัวเลขนี้จะกลายเป็น GPU-hours หลักพัน ไม่ใช่หลักหมื่น ซึ่งคือระดับงบของทีม ไม่ใช่ระดับของบริษัททั้งใบ รันตัวเลขก่อนที่ใครในทีมจะหลงรัก fine-tune รุ่น 70B แล้วตารางเวลาเงียบ ๆ บานเป็นสามเท่า การเห็นสเกลของแต่ละทางเลือกช่วยให้เปลี่ยนแผนได้ในช่วงที่ยังเปลี่ยนได้ถูก และถ้าตัวเลขออกมาเกินงบทีม การลดขนาดโมเดลหรือลดจำนวน tokens ลงครึ่งหนึ่งจะเห็นผลทันที ทำให้การต่อรองขอบเขตงานมีข้อมูลรองรับ
Fine-tune หรือเรียก API: ตัดสินใจที่จุดคุ้มทุน
ทีมผลิตภัณฑ์มักถามว่าควร train เองเลยไหม วิธีคิดคือประเมินต้นทุน train ครั้งเดียว แล้วเทียบกับค่า API รายเดือนที่คาดไว้สำหรับคุณภาพระดับเทียบเท่า ถ้า fine-tune ราคา $30,000 แต่บิล API เดือนละ $8,000 จุดคุ้มทุนจะมาถึงราวเดือนที่สี่ สมมติว่า usage ทรงตัว เครื่องมือนี้เปลี่ยนบทสนทนาเรื่องสถาปัตยกรรมให้กลายเป็นคำถามง่าย ๆ เรื่อง payback period เพียงแต่อย่าลืมว่าประสิทธิภาพของ fine-tune ต้องรักษาได้จริง ถ้าคุณภาพตกหลังข้อมูลเปลี่ยน ค่า retrain ก็ต้องถูกนับซ้ำเข้าไปในสมการด้วย
เขียนตัวเลขใส่ทุนวิจัยหรือ pitch
ผู้ทุนและกรรมการไม่ไว้ใจบรรทัดงบประมาณที่คลุมเครือ ประมาณการที่มีวิธีคิดโปร่งใส คือ 6 × parameters × tokens, utilization ที่ระบุชัดเจน และราคาที่อ้างอิงจากผู้ให้บริการจริง จะป้องกันตัวได้ดีในเอกสารขออนุมัติงบ วิธีคืออ้างอิง input ที่ใช้ แสดงตารางเทียบราคา แล้วคำขอของคุณจะอ่านเหมือนงานวิศวกรรม ไม่ใช่ความ optimistic ลอย ๆ ในทางกลับกัน ถ้าทุนวิจัยมีเพดานชัดเจน ตัวเลขชุดนี้ยังช่วยตัดสินใจว่าควรขอเครื่องกี่ตัว หรือควรลดสเกลโมเดลลงเท่าไรจึงจะอยู่ในกรอบ
เทียบการ train ใน lab เองกับการเช่า cloud
ถ้า lab ของคุณมี GPU เป็นของตัวเอง ตัวเลข GPU-hours ก็ยังมีประโยชน์เหมือนเดิม นำไปคูณด้วยต้นทุนต่อ GPU-hour แบบภายในองค์กร ซึ่งรวมค่า hardware แบบผ่อนค่าเสื่อม ค่าไฟ และค่าบุคลากร แล้วเทียบกับการเช่าจากภายนอก คลัสเตอร์ที่เป็นเจ้าของเองมักชนะเรื่องต้นทุน แต่มักแพ้เรื่อง wall-clock time เพราะมีเครื่องน้อยกว่า ซึ่งเป็นเรื่องสำคัญมากเมื่อวันส่งมอบถูกล็อกไว้ในแผนงานแล้ว อีกประเด็นคือความยืดหยุ่น cloud ปรับจำนวนเครื่องได้ตามฤดูกาลของงาน ขณะที่คลัสเตอร์ในบ้านมีต้นทุนคงที่ไม่ว่าจะใช้เต็มเปาหรือว่าง ปัจจัยนี้มักตัดสินผลเทียบได้มากกว่าราคาต่อชั่วโมงเฉย ๆ
แนวปฏิบัติที่ดี
- กันงบส่วนเผื่อสำหรับ run ที่ล้ม การกันงบไว้ 1.5-2 เท่าของประมาณการรันเดียว เพื่อรองรับ crash และ hyperparameter ที่พลาด เป็นเรื่องปกติของงาน ไม่ใช่การสิ้นเปลือง
- วัด utilization จาก run เล็กก่อน รันงานย่อส่วนของงานจริง จด MFU ที่ทำได้จริง แล้วนำตัวเลขที่วัดได้กลับเข้าเครื่องมือเพื่อประมาณการรอบใหม่ แม้แต่ run สั้น ๆ สองสามชั่วโมงก็มักเผยคอขวดที่ซ่อนอยู่ เช่น การโหลดข้อมูลช้าหรือ gradient รอเครือข่ายนานเกินไป
- ปรับราคาใหม่บ่อย ๆ ราคา GPU ลดลงและฮาร์ดแวร์รุ่นใหม่ออกมาตลอด ประมาณการที่แม่นยำเมื่อไตรมาสก่อนอาจสูงเกินจริงถึง 20 เปอร์เซ็นต์ในวันนี้ โดยเฉพาะก่อนลงนามสัญญาระยะยาว เพราะส่วนลดที่เคยดูดีอาจแพ้ราคาตลาดใหม่ภายในไม่กี่เดือน
- แยกค่า training ออกจากค่า inference ค่าเสิร์ฟโมเดลตลอดอายุการใช้งานอาจแพงกว่าค่า train เสียอีก อย่านำเสนอตัวเลข training เป็นต้นทุนรวมของทั้งระบบ
- วางแผน checkpoint ให้เข้ากับราคา spot ถ้าใช้ capacity แบบ preemptible ให้ checkpoint ถี่พอที่ preemption หนึ่งครั้งจะเสียเวลาเป็นนาที ไม่ใช่เป็นวัน
- บันทึกสมมติฐานของคุณไว้เสมอ เก็บค่า parameters, tokens, ชนิด GPU และ utilization ที่ใช้ จะได้อัปเดตประมาณการได้เร็ว แทนที่จะต้องเดาใหม่ทุกครั้งที่มีประชุม
เปิด Model Training Cost Calculator ใส่ parameters และ token budget ของโปรเจกต์ถัดไป แล้วคุณจะเห็นตัวเลขก่อนใครในห้อง ใช้เวลาแค่สามสิบวินาทีในเบราว์เซอร์ และได้คำตอบเดียวที่ทุกที่ประชุมวางแผนกำลังรออยู่เงียบ ๆ ว่างานชิ้นนี้จะกินงบเท่าไร ลองรันหลายสถานการณ์เทียบกันดู แล้วคุณจะเข้าที่ประชุมครั้งหน้าด้วยตัวเลขที่พร้อมป้องกันตัว
เครื่องมือที่คุณอาจสนใจ:
- Token Counter — นับจำนวน tokens เพื่อวางแผนชุดข้อมูล training และงบค่า API
- AI Tool Schema Builder — สร้าง tool schema แบบมีโครงสร้างสำหรับ AI agent และการเชื่อมต่อ LLM
- Scientific Calculator — คิดเลขต่อยอดได้ทุกอย่าง ตั้งแต่แปลงหน่วย FLOPs ไปจนถึงต้นทุนเฉลี่ยต่อชั่วโมง
ขอให้ทุก training run ราบรื่นและคุ้มค่าทุก GPU-hour ครับ
คำถามที่พบบ่อย
ถ: ประมาณการแม่นยำแค่ไหน? ตอบ: เป็นตัวเลขสำหรับวางแผน ไม่ใช่ใบเสนอราคา สมการ 6 × parameters × tokens เป็นที่ยอมรับกันดีอยู่แล้ว ความไม่แน่นอนหลักจึงอยู่ที่ utilization และราคาที่คุณจ่ายจริง ถ้าใช้ค่า utilization ที่วัดมาแล้ว งบจริงส่วนใหญ่จะใกล้เคียงกับประมาณการ และถ้าตัวเลขจริงออกมาห่างเกินไป ให้ย้อนกลับไปดูที่ utilization ก่อนเสมอ เพราะเป็นตัวแปรที่ขยับผลลัพธ์มากที่สุด
ถ: ทำไมต้องเป็น 6 × parameters × tokens? ตอบ: forward pass หนึ่งรอบใช้ราว 2 FLOPs ต่อ parameter ต่อ token และ backpropagation เพิ่มอีกราว 4 FLOPs กฎนี้เหมาะกับการ train dense transformer เป็นหลัก ส่วน activation recomputation จะขยับค่าคงที่ไปเล็กน้อยในทางปฏิบัติ ถ้าโมเดลของคุณใช้เทคนิคพิเศษอย่าง MoE หรือ recomputation หนัก ๆ ให้ปรับตัวคูณตามแนวทางของเปเปอร์ต้นทางก่อน
ถ: ควรสมมติ utilization ไว้เท่าไร? ตอบ: ถ้ายังไม่มีการวัดจริง ช่วง 30-40 เปอร์เซ็นต์เป็นตัวเลขวางแผนที่ป้องกันตัวได้สำหรับ distributed training คลัสเตอร์ใหญ่ที่ tune ดีทำได้เกิน 50 เปอร์เซ็นต์ ส่วนคลัสเตอร์ที่มีปัญหาอาจต่ำกว่า 25 ควรวัดจาก run เล็กก่อน แล้วใช้ตัวเลขจริง อย่าลืมว่า utilization ยังขึ้นกับขนาดโมเดลด้วย โมเดลเล็กมักได้ค่าต่ำกว่าเพราะ overhead ของระบบกินสัดส่วนมากกว่า
ถ: ประมาณการรวมค่าเตรียมข้อมูลหรือค่า inference ด้วยไหม? ตอบ: ไม่รวม เครื่องมือคิดราคาเฉพาะ training run หนึ่งครั้งในหน่วย GPU-hours และดอลลาร์ ส่วนการเก็บข้อมูล การทำความสะอาด evaluation, storage และ inference เป็นบรรทัดงบแยกที่ควรเพิ่มเข้าไปเอง การแยกบรรทัดแบบนี้ยังช่วยให้ต่อรองงบได้ชัดเจนขึ้น เพราะแต่ละส่วนมีเจ้าของและจังหวะจ่ายเงินไม่เหมือนกัน