MongoDB ObjectId Decoder: เปิดเผย creation timestamp ที่ซ่อนอยู่ในทุก _id
ถอดรหัส MongoDB ObjectId ให้กลายเป็น creation timestamp, random value และ counter พร้อมสร้าง boundary ObjectId สำหรับ query ช่วงวันที่ — ทำงานทั้งหมดในเบราว์เซอร์ของคุณ ไม่ต้องอัปโหลดอะไรเลย
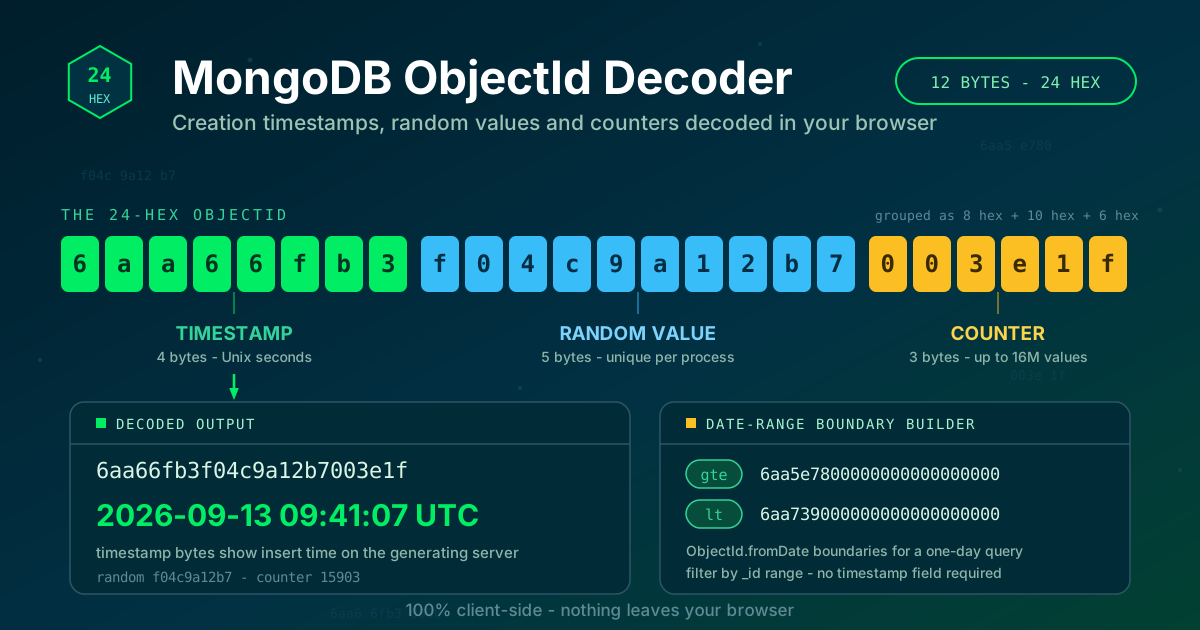
Table of Contents
MongoDB ObjectId Decoder: เปิดเผย creation timestamp ที่ซ่อนอยู่ในทุก _id
ลองเปิด collection ไหนก็ได้ใน MongoDB แล้วมองไปที่ฟิลด์ _id สายอักขระ hex 24 ตัวอย่าง 6aa66fb3f04c9a12b7003e1f ไม่ใช่ตัวอักษรสุ่ม ๆ แปดตัวแรกคือ Unix timestamp ที่บันทึกวินาทีที่แน่นอนที่ document ถูก insert ทุก MongoDB _id บรรจุเวลาที่ document ถูกสร้างเอาไว้ — แต่นักพัฒนาส่วนใหญ่กลับไม่เคยถอดมันออกมาดู ทั้งที่คำตอบวางอยู่ตรงหน้าในทุก document
MongoDB ObjectId Decoder อ่านมันให้คุณได้ทันที เพียง paste ObjectId 24 ตัว แล้วเครื่องมือจะแยกค่าออกเป็นสามส่วนตามโครงสร้างจริง ได้แก่ timestamp 4 ไบต์, random value 5 ไบต์ และ counter 3 ไบต์ พร้อมแสดงวันที่และเวลาที่สร้างแบบเป๊ะ ๆ เป็น UTC และยังทำสวนทางได้ด้วย คือสร้าง boundary ObjectId สำหรับ query ช่วงวันที่จากวันเริ่มต้นและวันสิ้นสุดที่คุณเลือก
ความสามารถหลังนี่แหละที่แก้ปัญหาคลาสสิกของงาน MongoDB ได้อย่างเงียบ ๆ นั่นคือการกรอง collection ตามวันที่สร้าง ในกรณีที่ไม่มีฟิลด์ timestamp แยกไว้ให้ บทความนี้จะพาไปทั้งสองทิศทาง — จากการอ่าน _id ทีละตัว ไปจนถึงการตัด collection ทั้งก้อนตามช่วงเวลา รวมถึงข้อควรระวังก่อนเชื่อ timestamp ที่ฝังมากับ ID
ทำไมต้องใช้ MongoDB ObjectId Decoder?
- ได้วันที่สร้างจาก _id เพียงอย่างเดียว ไม่ต้องแก้ schema ไม่ต้อง migrate ไม่ต้องเพิ่มฟิลด์ document ที่ใช้ ObjectId ค่าเริ่มต้นของ MongoDB พาเวลา insert มาฝังไว้ใน 8 ตัวอักษรแรกเสมอ พร้อมให้อ่านทุกเมื่อ
- ได้ครบทั้ง 12 ไบต์ ไม่ใช่แค่วันที่ เครื่องมือแยก timestamp, random value ประจำ process และ counter ที่ไล่เพิ่มทีละค่า ซึ่งเป็นข้อมูลที่ต้องใช้จริงเวลา debug ปัญหาข้อมูลซ้ำหรือพฤติกรรมการสร้าง ID
- มีตัวสร้าง boundary สำหรับ query ช่วงวันที่ เทคนิคที่ไม่ค่อยมีใครบอกต่อของ MongoDB — การสร้าง ObjectId เป็นขอบเขตเพื่อ query ด้วยช่วง _id แทนฟิลด์ timestamp — เหลือแค่เลือกวันสองวัน ไม่ต้องคำนวณ hex เอง
- ไม่ต้องติดตั้ง ไม่ต้องอัปโหลด การถอดรหัสเป็นแค่คณิตศาสตร์กับตัวอักษร 24 ตัว เครื่องมือรันในเบราว์เซอร์ของคุณล้วน ๆ ID จากระบบ production ที่อ่อนไหวจึงไม่หลุดออกจากเครื่องคุณ
- ตรวจสอบ input ให้ตั้งแต่ต้น สายอักขระที่ยาวผิดหรือมีตัวอักษรนอกชุด hex จะถูกจับได้ทันที กันไม่ให้ช่องว่างหรือการ copy ติดขาดไปให้วันที่ที่ผิดอย่างมั่นใจ
- ฟรีและไม่จำกัด ไม่ต้องสมัคร ไม่มีโควตา ไม่มีการเก็บข้อมูล เปิดหน้าเว็บ paste อ่านแล้วคัดลอกผลไปใช้
ฟีเจอร์หลัก
| ฟีเจอร์ | สิ่งที่ทำ |
|---|---|
| แยก timestamp | แปลง 4 ไบต์แรกเป็นวันที่และเวลาที่สร้างแบบ UTC ที่อ่านง่าย |
| แสดงครบทุกไบต์ | แยกและอธิบายส่วน timestamp, random value และ counter |
| สร้าง boundary ObjectId | สร้าง ObjectId จุดเริ่มและจุดสิ้นสุดจากสองวันที่ เพื่อ query ช่วง _id |
| ตรวจสอบ input | แจ้งเตือนทันทีถ้าค่าไม่ใช่ตัวอักษร hex ครบ 24 ตัวพอดี |
| ทำงานฝั่ง client | คำนวณทั้งหมดในเบราว์เซอร์ ไม่มีข้อมูลใดถูกส่งไปเซิร์ฟเวอร์ |
การแยกทีละส่วนสำคัญเพราะสาม segment ตอบคนละคำถาม timestamp ตอบว่า "เมื่อไร" random value ตอบว่า "process ไหนเป็นคนสร้าง" และ counter ตอบว่า "process นั้นสร้างไปแล้วกี่ document" รวมกันแล้วสายอักขระที่เคยอ่านไม่ออกกลายเป็นบันทึกนิรนามเล็ก ๆ ที่สืบค้นได้
วิธีใช้งาน
- เปิด MongoDB ObjectId Decoder โหลดทันทีในเบราว์เซอร์ทุกยี่ห้อ ไม่ต้องติดตั้ง ไม่ต้องมีบัญชี
- Paste ObjectId 24 ตัว คัดลอกค่าจาก document, บรรทัดใน log, response ของ API หรือไฟล์ export เครื่องมือตรวจรูปแบบให้ระหว่างที่คุณพิมพ์
- อ่าน segment ที่แยกแล้ว creation timestamp ขึ้นก่อน ตามด้วย random value และ counter แต่ละส่วนระบุช่วงไบต์ของตัวเองกำกับไว้
- สลับไปตัวสร้าง boundary เลือกวันเริ่มต้นและวันสิ้นสุด เครื่องมือจะได้ boundary ObjectId สองตัวพร้อมนำไปวางใน query ได้เลย
- เอา boundary ไปใช้ใน query ใช้ boundary ล่างเป็นค่าต่ำสุดแบบรวม และ boundary บนเป็นค่าสูงสุดแบบไม่รวม แล้วดึงผลลัพธ์ออกมา
ทั้งกระบวนการใช้เวลาไม่กี่วินาที ข้อผิดพลาดที่พบบ่อยคือ paste ObjectId ที่ติดขาด — 23 ตัวอักษรให้วันที่ที่ผิดอย่างมั่นใจ นั่นคือเหตุผลที่การตรวจสอบรันก่อนการตีความเสมอ
ObjectId 12 ไบต์คืออะไร
ObjectId คือข้อมูล 12 ไบต์ที่เขียนเป็นตัวอักษร hex ตัวพิมพ์เล็ก 24 ตัว โดยไบต์ทั้งหมดแบ่งเป็นสามฟิลด์:
- Timestamp (4 ไบต์, 8 ตัวอักษรแรก) เลขจำนวนเต็มไม่มีเครื่องหมายแบบ big-endian ที่นับวินาทีจาก Unix epoch สี่ไบต์ของวินาทีจะใช้หมดราวเดือนกุมภาพันธ์ 2106 รูปแบบนี้จึงปลอดภัยไปอีกหลายทศวรรษ
- Random value (5 ไบต์, 10 ตัวอักษรถัดมา) ค่าที่สุ่มเลือกครั้งเดียวตอน process เริ่มทำงาน ทำให้ ObjectId ไม่ซ้ำกันข้ามเครื่องและข้ามการรีสตาร์ทแอปพลิเคชัน โดยไม่ต้องประสานงานระหว่างเซิร์ฟเวอร์เลย
- Counter (3 ไบต์, 6 ตัวอักษรสุดท้าย) ตัวนับที่เริ่มจากค่าสุ่มในแต่ละ process และเพิ่มขึ้นทุกครั้งที่ process นั้นสร้าง ObjectId ช่วยให้ได้ ID ไม่ซ้ำหลายพันค่าต่อวินาทีต่อ process
ถอดรหัสตัวอย่างจริง
ยก 6aa66fb3f04c9a12b7003e1f มาดู แปดตัวแรก 6aa66fb3 คือค่า 1789292467 ในระบบฐานสิบ — นั่นคือ 2026-09-13 09:41:07 UTC วินาทีที่ document นี้ถูก insert สิบตัวกลาง f04c9a12b7 ระบุ application process ที่สร้างมัน และหกตัวท้าย 003e1f เท่ากับ 15,903 แปลว่านี่คือ ID ลำดับราว ๆ 15,904 ที่ process นั้นสร้างตั้งแต่เริ่มทำงาน การสืบค้นทั้งหมดจบด้วยการ paste ครั้งเดียว
เทคนิค query ช่วงวันที่ด้วย ObjectId
นี่คือส่วนที่รู้สึกเหมือนเทคนิคลับแต่เปลี่ยนวิธี query ของคุณได้จริง เพราะ _id เรียงลำดับตามการสร้าง คุณจึงกรอง collection ตามเวลาได้ด้วย index ของ _id เพียงอย่างเดียว สร้าง ObjectId ที่ timestamp เท่ากับวันเริ่มต้น อีกตัวเท่ากับวันสิ้นสุด แล้ว query เป็นช่วง:
db.orders.find({
  _id: {
    $gte: ObjectId('6aa5e7800000000000000000'),
    $lt: ObjectId('6aa739000000000000000000'),
  },
});
สอง boundary นี้สร้างจาก 2026-09-13 00:00:00 UTC และ 2026-09-14 00:00:00 UTC ผลลัพธ์คือทุก document ที่สร้างในวันที่ 13 กันยายน ซึ่งค้นผ่าน index ที่มีอยู่แล้วในทุก collection — ไม่ต้องมีฟิลด์ createdAt ไม่ต้องสร้างหรือดูแล index เพิ่ม สำหรับ collection รุ่นเก่า ข้อมูลที่ import เข้ามา หรือ schema ที่แก้ไม่ได้ นี่มักเป็นทางเดียวที่ทำได้จริงในการตอบคำถาม "วันนั้นมีอะไรเกิดขึ้นบ้าง"
สิ่งที่ timestamp ไม่ได้บอกคุณ
ให้ถือว่า timestamp ที่ฝังมาคือเวลา insert บนเซิร์ฟเวอร์ที่สร้าง ไม่ใช่เวลาเชิงธุรกิจ ถ้า batch job วันนี้เอาออเดอร์ปีที่แล้วมา backfill ObjectId ของมันจะบันทึกวันนี้ไว้ นาฬิกาที่เบี่ยงเบนระหว่าง application server ก็ทำให้ timestamp คลาดไปตามระยะเบี่ยงเบน และ ObjectId บันทึกเรื่องการสร้าง ไม่ใช่การแก้ไขล่าสุด — document ที่ถูก update ยังคง _id เดิม จึงใช้ถอดรหัสเพื่องานสืบค้นและการ query แต่อย่าเอาไปแทนนาฬิกาธุรกิจที่เชื่อถือได้
กรณีการใช้งานจริง
Debug ปัญหาข้อมูล
เมื่อข้อมูลซ้ำ เรียงผิดลำดับ หรือกระจุกตัวผิดปกติ ลองถอดรหัส ObjectId ของมัน timestamp บอกเวลา insert ที่แน่นอน random value เผยว่า process ไหนสร้าง และ counter บอกลำดับการ insert ภายใน process นั้น จุดที่ counter รีเซ็ตกลับศูนย์ชี้เวลาที่แอปพลิเคชันรีสตาร์ทได้เป๊ะ ๆ
Query ข้อมูล archive และ partition
การย้ายหรือจัดเก็บข้อมูลเก่าต้องเลือกข้อมูลตามอายุ boundary ObjectId ให้คุณเลือกทุกอย่างที่สร้างก่อนวัน cutoff ด้วย range query เดียวบน _id ที่ใช้ index อยู่แล้ว ไม่ต้อง scan ทั้ง collection ไม่ต้องมีฟิลด์ timestamp และได้ผลลัพธ์ที่ deterministic แม้บน collection ที่ไม่มีข้อมูลวันที่เลย
สืบค้นข้อมูลที่ import เข้ามา
ไฟล์ import จาก CSV, dump จากการ migrate หรือ feed จากภายนอกมักมาโดยไม่มีวันที่สร้างที่เชื่อถือได้ แต่ MongoDB จะป้อง ObjectId ใหม่ตอน insert การถอดรหัส _id เหล่านี้บอกได้ละเอียดว่า job import รันเมื่อไร ใช้เวลานานแค่ไหน และแถวไหนมาถึงก่อนหลัง — หลักฐานที่หาไม่ได้จากที่อื่นในตัว document
วางแผนหน้าต่าง backup
การ restore และการเทียบข้อมูลแบบ point-in-time ต้องรู้ว่ามีอะไรเปลี่ยนไปในช่วงเวลาที่สนใจ ถอดรหัส ObjectId ของ document ที่รู้จักเพื่อวางหมุดเวลา สร้าง boundary ของช่วง แล้วนับ document ในช่วงนั้นเพื่อประมาณปริมาณงานก่อนรันจริง
แนวปฏิบัติที่ดี
- ยังคงเก็บ timestamp แยกต่างหากสำหรับ logic ธุรกิจ timestamp ที่ฝังใน ObjectId สะท้อนเวลา insert ฝั่งเซิร์ฟเวอร์ ออเดอร์ เหตุการณ์ และข้อมูล audit ควรมีฟิลด์ createdAt จริงที่แอปพลิเคชันกำหนด ใช้การถอดรหัส _id เป็นส่วนเสริม ไม่ใช่สิ่งทดแทน
- จำไว้ว่า boundary ObjectId รวมปลายต้นเข้าไปด้วย ใช้ boundary ล่างกับเงื่อนไขแบบรวม และ boundary บนกับเงื่อนไขแบบไม่รวม document ที่สร้างตรงเส้นสิ้นสุดพอดีจะตกอยู่ในช่วงเดียว ไม่ซ้ำสองที่
- ตรวจความยาว hex ก่อนถอดรหัสเสมอ ต้องเป็นตัวอักษร 0-9 และ a-f ครบ 24 ตัวพอดี อย่างอื่นคือข้อมูลที่เสียหายระหว่างคัดลอกและจะถอดออกมาเป็นเรื่องไร้ความหมาย — เครื่องมือบังคับข้อนี้ให้แล้ว
- คาดหวังลำดับคร่าว ๆ ไม่ใช่การรับประกัน process เดียวสร้าง ObjectId ตามลำดับเพิ่มขึ้น แต่หลายเซิร์ฟเวอร์สร้างพร้อมกันแล้วสลับกันได้ อย่าเอาลำดับ _id ข้ามเซิร์ฟเวอร์ไปใช้เป็นลำดับที่เข้มงวด
- รู้ไว้ว่า ID เปิดเผยเวลาสร้าง ใครก็ตามที่เห็น ObjectId ถอด timestamp ออกมาได้ ถ้า API ของคุณเปิดเผย _id ต่อสาธารณะ แปลว่าคุณกำลังเผย metadata การ insert ด้วย — ส่วนใหญ่ไม่เป็นไร แต่ควรคิดถึงเรื่องนี้กับระบบที่อ่อนไหว
- ถือ ObjectId เป็นข้อความเสมอ ค่า hex ที่วางลง spreadsheet หรือ script อาจหายเลขศูนย์นำหน้าหรือถูกแปลงเป็นตัวเลข ให้คงไว้เป็น text ตั้งแต่ต้นทางจนถึงปลายทาง
เริ่มถอดรหัส ObjectId แรกของคุณวันนี้
สิบสองไบต์ สามฟิลด์ และนาฬิกาที่ซ่อนอยู่ — document ทุกตัวใน MongoDB พกใบกำเนิดของตัวเองมาตั้งแต่แรกแล้ว ลอง paste _id เข้า MongoDB ObjectId Decoder แล้วอ่านมันออกมาในไม่กี่วินาที หรือสร้าง boundary ObjectId เตรียมไว้สำหรับ query ช่วงวันที่ครั้งถัดไป เครื่องมือนี้รันในเบราว์เซอร์ของคุณทั้งหมด และจะเป็นแบบนั้นตลอดไป
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Snowflake ID Decoder — ดึง creation timestamp จาก Snowflake ID ของ Discord, Twitter/X และ Instagram
- UUID Decoder — แยก UUID เป็น version, variant และฟิลด์ timestamp ที่ฝังอยู่
- Unix Timestamp Converter — แปลง Unix timestamp ดิบให้เป็นวันที่และเวลาที่อ่านง่าย
ขอให้สนุกกับการถอดรหัส!
คำถามที่พบบ่อย
ถ: อ่านวันที่สร้างจาก _id ของ document ทุกตัวใน MongoDB ได้จริงไหม? ตอบ: ได้เฉพาะ document ที่ใช้ ObjectId generator ค่าเริ่มต้นของ MongoDB ถ้าแอปพลิเคชันกำหนด _id เอง ก็จะไม่มี timestamp ฝังอยู่ให้ถอด
ถ: การถอดรหัส ObjectId ต้องเข้าถึงฐานข้อมูลไหม? ตอบ: ไม่ต้อง ObjectId คือไบต์ 12 ตัวที่มีโครงสร้างตายตัว การถอดจึงเป็นแค่การคำนวณ เครื่องมือทำงานออฟไลน์ในเบราว์เซอร์ได้เลย แม้ ID ที่คัดลอกมาจากภาพหน้าจอ
ถ: ObjectId.fromDate ช่วยให้ query โดยไม่ต้องมีฟิลด์ timestamp อย่างไร? ตอบ: มันสร้าง ObjectId ที่ timestamp เท่ากับวันที่ที่เลือก โดยไบต์ random และ counter เป็นศูนย์ การเอาสองตัวนี้มาเป็น boundary ของช่วงบน _id จึงกรอง collection ตามเวลาสร้างผ่าน index ที่มีอยู่แล้วในทุก collection
ถ: ทำไมวันที่ที่ถอดได้ไม่ตรงกับฟิลด์ createdAt ของฉัน? ตอบ: ObjectId บันทึกเวลาที่เซิร์ฟเวอร์ insert document ส่วน createdAt บันทึกเวลาเชิงธุรกิจที่แอปพลิเคชันถือว่าถูกต้อง การ backfill, retry และ import ทำให้สองค่านี้ต่างกันได้ ซึ่งเป็นเรื่องปกติ
ถ: ใช้ boundary ObjectId ทำ pagination ได้ปลอดภัยไหม? ตอบ: ได้ และเป็น pattern ที่นิยม เอา _id ตัวสุดท้ายของหน้าก่อนหน้าไปเป็นขอบล่างแบบไม่รวมของ query หน้าถัดไป การเรียงตาม _id จึงใกล้เคียงกับการเรียงตามเวลาสร้าง