Nginx Log Analyzer: อ่าน access log ให้เป็นเหมือน Incident Responder
วาง log จาก nginx หรือ Apache เพื่อดูสรุป status code, IP ที่ยิงมากที่สุด, endpoint ยอดนิยม, bandwidth รวม และการแจ้งเตือน traffic spike — ประมวลผลฝั่ง client 100% ด้วย Nginx Log Analyzer
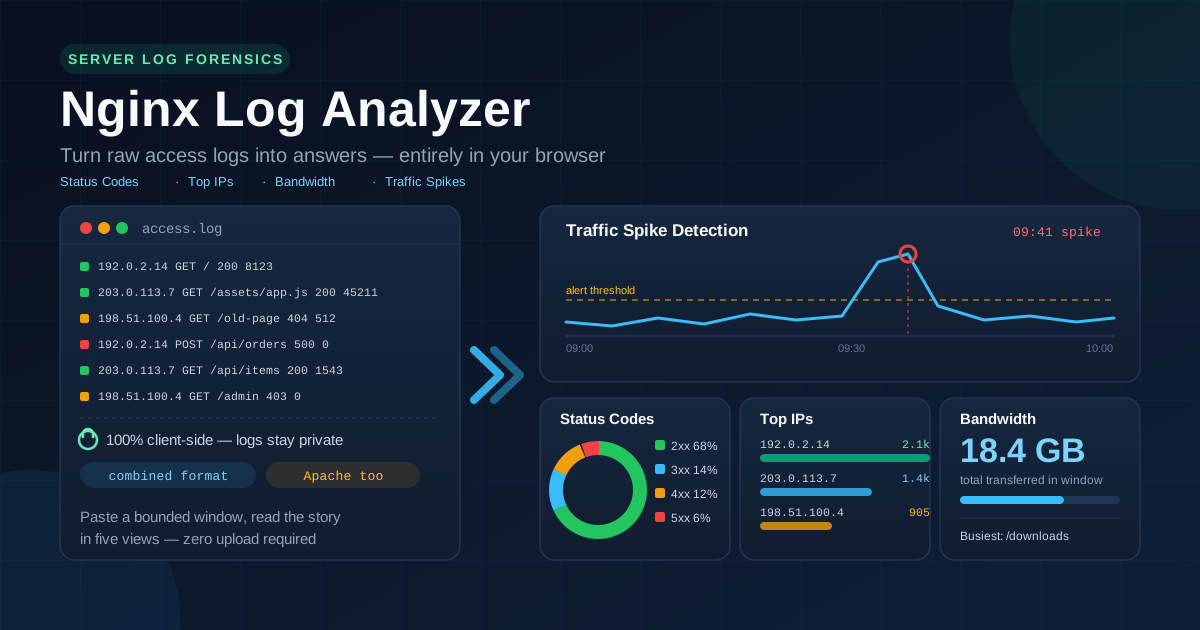
Table of Contents
Nginx Log Analyzer: อ่าน access log ให้เป็นเหมือน Incident Responder
ทุกเว็บเซิร์ฟเวอร์มี "กล่องดำ" บันทึกวิ่งอยู่ตลอด 24 ชั่วโมง นั่นคือ access log ที่จดทุก request ที่เข้ามาว่า ใครขอ ขออะไร เมื่อไร และเซิร์ฟเวอร์ตอบกลับไปอย่างไร พอเว็บพัง ช้า หรือถูกโจมตี ไฟล์นี้คือพยานลำดับแรกที่คุณควรไปสัมภาษณ์ และเป็นพยานที่ไม่เคยเดา Nginx Log Analyzer เปลี่ยนกองข้อความดิบนี้ให้เป็นสรุป status code, อันดับ IP และ endpoint ที่ยิงมากที่สุด, bandwidth รวม และการแจ้งเตือน traffic spike ภายในไม่กี่วินาทีหลังจากที่คุณวาง log ลงไป
แต่มีเรื่องที่ต้องระวัง และเรื่องนี้สำคัญกว่าที่หลายคนคิด access log อุดมไปด้วย IP ของลูกค้า, URL ที่เขาเข้าชมจริง ๆ, user agent และ referer ที่อาจรั่วข้อมูล campaign token หรือ path ภายในองค์กร การอัปโหลดไฟล์นี้ขึ้นเว็บแปลงไฟล์ออนไลน์สุ่ม ๆ ใด ๆ ก็เท่ากับส่งข้อมูลส่วนบุคคลของผู้ใช้คุณขึ้นเซิร์ฟเวอร์ของคนอื่น โดยที่คุณไม่รู้เลยว่าเขาเก็บไว้นานแค่ไหนและใครได้เปิดดู
นี่คือเหตุผลที่ตัว analyzer นี้ประมวลผลทุกอย่างในเบราว์เซอร์ของคุณล้วน ๆ วาง log เข้าไป อ่านผลลัพธ์ ปิดแท็บ — ไม่มีข้อมูลอะไรถูกส่งออกไปไหนเลย ต่างจากการส่งหลักฐานไปให้คนแปลกหน้าตรวจให้ตรงที่คุณทำ forensics บนโต๊ะตัวเองอย่างเดียว
ทำไมต้องใช้ Nginx Log Analyzer?
- วิเคราะห์แบบ privacy-first ในเครื่องล้วน ๆ การประมวลผลเป็น client-side 100% access log จริงมีทั้ง IP ผู้ใช้และเส้นทางที่เขาเข้า ซึ่งเครื่องมือนี้ไม่มีบรรทัดไหนออกจากเครื่องคุณเลย ปลอดภัยแม้กับ log production หรือสภาพแวดล้อมที่ผูกกับ compliance
- ไม่ต้องเซ็ตอัพไปป์ไลน์ใด ๆ ไม่ต้อง SSH ไม่ต้องจำคำสั่ง grep ไม่ต้องติดตั้งระบบ log shipping ขอแค่มีเบราว์เซอร์ก็วิเคราะห์ access log ได้ทันที ทุกระบบปฏิบัติการ
- เข้าใจทั้งสองสำนวน ทั้ง nginx combined format และ Apache ทั้ง common และ combined format จับคู่กันอัตโนมัติ สภาพแวดล้อมที่ใช้ผสมกันจึงไม่ต้องพกระบบมาสองตัว
- ได้คำตอบ ไม่ใช่แค่บรรทัดที่กรองแล้ว เครื่องมือสรุปข้อมูลให้เป็นภาพรวม ไม่ว่าจะเป็น status code, top IP, top endpoint และ bandwidth ไฟล์ห้าพันบรรทัดจึงกลายเป็นแดชบอร์ดที่มองปุ๊บเข้าใจปั๊บ
- จับปัญหาที่ตาเปล่ามองข้าม ระบบตรวจจับ traffic spike จะชี้ช่วงเวลาที่ปริมาณ request พุ่งผิดปกติ ซึ่งเป็นลายเซ็นของ scraper, retry storm หรือการโจมตีที่ซ่อนอยู่ในบรรทัดปกติหลายหมื่นบรรทัด
- เร็วพอสำหรับตอนเกิด incident ตอนระบบล่ม ทุกนาทีมีค่า วาง log ครึ่งชั่วโมงล่าสุด อ่านข้อสรุป ลงมือแก้ — เร็วกว่ารอ pipeline ภายนอก ingest เสร็จอีก
ฟีเจอร์หลัก
| ฟีเจอร์ | สิ่งที่แสดงให้เห็น |
|---|---|
| สรุป status code | นับ 2xx, 3xx, 4xx และ 5xx — สำเร็จ, redirect, error ฝั่ง client, error ฝั่งเซิร์ฟเวอร์ |
| Top IP | ที่อยู่ client ที่ยิง request มากที่สุดเรียงตามอันดับ |
| Top endpoint | URL และ path ที่ถูกเรียกบ่อยสุด จุดร้อนจึงโผล่มาให้เห็นทันที |
| Bandwidth รวม | จำนวน bytes ที่เซิร์ฟเวอร์ส่งออกในช่วงเวลาที่วางเข้ามา — น้ำหนักที่เซิร์ฟเวอร์แบกจริง |
| ตรวจจับ traffic spike | ช่วงเวลาที่ปริมาณ request พุ่งผิดปกติ ซึ่งเป็นตัวชี้จุดเกิดเหตุที่น่าสงสัย |
| Parse ฝั่ง client | ทำงานทั้งหมดในเบราว์เซอร์ ไม่อัปโหลด ไม่เก็บข้อมูล ไม่ต้องสมัครบัญชี |
รายละเอียดที่น่ารู้อีกเล็กน้อย:
- วางแบบผสมกันก็ได้ วางบรรทัด nginx และ Apache ปนกันได้ parser จะจำแนกทั้งสองแบบ และข้ามบรรทัดที่อ่านไม่ออกหรือไม่เกี่ยวข้องแทนที่จะล้มเหลวทั้งหมด
- วางแล้วใช้ ไม่มีงานประปา ไม่มี integration ฝั่งเซิร์ฟเวอร์ให้ตั้งค่า คัดลอกช่วงเวลาที่สนใจ วางลงไป อ่านจบ แล้วกลับไปแก้ปัญหาต่อได้เลย
วิธีใช้งาน
- ดึง log เฉพาะช่วงเวลาที่ต้องการ บนเซิร์ฟเวอร์ ให้เอาเฉพาะส่วนที่สนใจ เช่น หนึ่งชั่วโมงรอบเหตุการณ์ จากไฟล์ log rotation หรือ tail จาก access log ตรง ๆ การเลือกช่วงให้กระชับทำให้ข้อมูลที่วางเล็กลงและเรื่องราวชัดขึ้น
- เปิดตัว analyzer เข้าไปที่ Nginx Log Analyzer แล้ววางบรรทัด log ลงช่อง input ระบบจับรูปแบบ nginx และ Apache ที่ปนกันได้อัตโนมัติ
- อ่านสรุป status code เป็นอันดับแรก เว็บที่แข็งแรงต้องมีสัดส่วน 2xx เป็นส่วนใหญ่ ถ้า 4xx เป็นกองใหญ่แปลว่ามีลิงก์พังหรือมีคนย่องดู ถ้า 5xx เพิ่มขึ้นแปลว่าฝั่งเซิร์ฟเวอร์มีปัญหา — สัดส่วนจะบอกว่าต้องไปสืบฝั่งไหน
- ดู top IP และ top endpoint ต่อ จุดเดียวยิง endpoint เดียวซ้ำ ๆ ไม่ใช่มนุษย์ปกติหรอก สองอันดับนี้มักเรียกชื่อ scraper, loop ที่ retry ไม่หยุด หรือหน้าที่พัง ให้ภายในไม่กี่วินาที
- ไล่ตาม spike และ bandwidth เทียบเวลาที่ระบบชี้ spike กับ deploy log หรือ cron schedule ของคุณ และใช้ยอด bandwidth ตัดสินว่า cache ช่วยได้แค่ไหนหรือ asset ไหนร้อนเกินคาด จากนั้นแก้ที่ต้นเหตุ ไม่ใช่แค่อาการ
อ่าน access log ให้เป็นเหมือน Incident Responder
กายวิภาคของบรรทัด combined format บรรทัด nginx หนึ่งบรรทัดดูแน่น แต่จริง ๆ แยกได้เป็นแปดฟิลด์ที่ incident responder อ่านเรียงลำดับ: client IP (ใคร), ช่อง identity (เกือบตลอดเป็นขีด), user ที่ authenticated (ก็มักเป็นขีดเช่นกัน), timestamp (เมื่อไร), request line อย่าง GET /index.html HTTP/1.1 (ขออะไร), status code (เซิร์ฟเวอร์ตอบว่าอย่างไร), bytes ที่ส่งไป (คำตอบหนักแค่ไหน) และ referer กับ user agent (มาจากไหน ด้วย client อะไร) log ของ Apache มีข้อมูลชุดเดียวกันต่างแค่เครื่องหมาย พอเรียกชื่อฟิลด์ได้ครบ บรรทัด log ทุกบรรทัดจะเลิกเป็นเสียงรบกวน แล้วกลายเป็นประโยคที่อ่านรู้เรื่อง
แต่ละมุมมองรวมเผยอะไรบ้าง สรุป status code คือ triage แรกของคุณ: 404 พร้อมกันเป็นชุดมักหมายถึงลิงก์หรือ asset พังหลัง deploy, 401 กับ 403 หมายถึง session หมดอายุหรือมีคนลองเข้า path ของ admin, 429 แปลว่า rate limit ทำงานอยู่, ส่วน 5xx แปลว่าแอปล้มเหลวทั้งที่ nginx ยังมีชีวิต — ซึ่งเป็นการแยกที่เจาะจงและมีประโยชน์มาก อันดับ top IP เปิดโปง scraper และ load ที่เอนไปข้างเดียว: IP เดียวมี request หลายหมื่นครั้งคือบอทที่ควร rate-limit หรือ service ภายในที่ตั้งค่าผิด อันดับ top endpoint บอกว่าหน้าไหนหรือ API เส้นไหนกระจุกความเจ็บปวดไว้ นั่นคือจุดแรกที่ต้องเปิดโค้ดดู และยอด bandwidth รวมช่วยปิดปากเรื่อง cache: ถ้า asset สามตัวกิน bytes เกือบหมด การบีบอัดหรือใส่ cache header สามไฟล์นั้นชนะการจูนแบบลอย ๆ ทั้งระบบ
การตรวจจับ traffic spike คือเส้นลวนไฟ มนุษย์เดินเว็บเป็นโค้งมน ๆ แต่สคริปต์ไม่ยอมมน พอปริมาณ request ในหนึ่งนาทีกระโดดขึ้นหลายเท่าของช่วงรอบข้าง เครื่องมือจะ flag ไว้ทันที และจุดพวกนี้แหละที่เหตุการณ์ชอบซ่อน: scraper ที่เพิ่งค้นพบหน้า product listing ของคุณ, health check ที่ตั้งค่าผิด, retry storm หลัง 5xx แวบเดียว หรือความเคลื่อนไหวแรกของการ credential stuffing ถ้า spike ของ 4xx หรือ 5xx มาพร้อมกับปริมาณที่พุ่ง นั่นคือสัญญาณที่ดังที่สุดที่ access log เดียวจะส่งได้
ตัวอย่างการอ่าน mini-log จริง สมมุติคุณวาง log สามสิบนาทีแล้วเห็นแบบนี้: status code เป็น 200 ที่ 71%, 404 ที่ 3%, 500 ที่ 24%, top IP คือ 198.51.100.4 ด้วย 4,100 requests, top endpoint คือ POST /api/checkout ที่โดน 4,090 ครั้งจากจำนวนนั้น และ spike detector flag ช่วง 09:40 ถึง 09:44 อ่านเป็นประโยคได้ว่า: เริ่มตอน 09:40 client หนึ่งเริ่มยิง checkout endpoint ไม่หยุด และ request หนึ่งในสี่ล้มเหลวด้วย server error นี่ไม่ใช่ traffic จากคนจริง — นี่คือผู้กระทำเดี่ยวที่ทำให้เกิด failure loop น่าจะ retry รุนแรงใส่ payment API ที่เพิ่งพังตอน 09:40 ขั้นตอนต่อไปเขียนตัวเองจบ: เช็ค application log ตอน 09:40, block หรือ rate-limit IP นั้น แล้วใส่ backoff ให้ฝั่ง client สี่ตัวเลขรวม อ่านหนึ่งนาที ได้เรื่องราว incident ครบเรื่อง
กรณีใช้งานจริง
ตามรอยความเสียหายหลัง deploy
เหตุการณ์ที่พบบ่อยที่สุดคือแผลที่ตัวเองทำเอง: deploy รอบใหม่เปลี่ยนชื่อ asset, ตัด route ทิ้ง หรือทำ API contract พัง วาง log ช่วงไม่กี่นาทีหลัง release ถ้าเห็น 404 กระจุกกันที่ path เดียว หรือ 500 โผล่ที่ endpoint ที่ก่อนหน้านี้สะอาด จะชี้ได้เป๊ะว่า deploy ทำอะไรพัง พร้อม timestamp ที่ตรงกับ release notes ของคุณ
ระบุบอทและ scraper
Scraper มักไม่โผล่ในเมตริกฝั่งแอป แต่ซ่อนจากอันดับ top IP และ top endpoint ไม่ได้ IP เดียวกวาดหน้า product เรียงลำดับเลข หรือ IP เดียวสร้างครึ่งหนึ่งของ request ทั้งหมดตอนตีสี่ พอถูกรวมเป็นภาพเดียวก็เห็นชัดขึ้นทันที ข้อมูลชุดนี้คือหลักฐานที่ใช้เขียนกฎ rate-limit อย่างมีข้อมูล แทนการเดาสุ่มสี่สุ่มห้า
วางแผนความจุ
ยอด bandwidth และอันดับ endpoint คือเครื่องมือด้านงบประมาณ ก่อนรีบ marketing เอา log ช่วงเดียวกันของรอบก่อนมาวางแล้วดูว่า endpoint ไหนกิน bytes และ request มากสุด ถ้า URL ดาวน์โหลดเดียวกิน bandwidth ไป 80% ในรอบที่แล้ว คุณรู้แล้วว่า CDN หรือ cache header ควรไปลงที่ไหน — ก่อน traffic มาถึง ไม่ใช่หลังจากนั้น
Security triage
การโจมตีแบบสำรวจมีรูปร่างชัดเจน: 404 เพียบทั้ง path อย่าง /wp-admin หรือ /.env, 401 ระเบิดที่ endpoint ของ login หรือ request จาก IP กลุ่มเล็กด้วยความเร็วจักรกล วาง log เข้าไปสั้น ๆ คุณจะยืนยันได้ว่ากำลังถูกสแกน ดึง IP ตัวร้ายออกมา แล้วส่งรายชื่อที่เป็นรูปธรรมให้ทีม security แทนความรู้สึกลอย ๆ — โดยไม่ต้องอัปโหลดข้อมูลผู้ใช้ขึ้น third party
แนวปฏิบัติที่ดี
- วางเฉพาะช่วงเวลาที่จำกัดไว้ ไม่ใช่ทั้งอาทิตย์ ช่วงที่โฟกัส เช่น หนึ่งชั่วโมงรอบ incident หรือวันของ campaign ทำให้ผลวิเคราะห์คมและตัวเลขรวมมีความหมาย ใส่เสียงรบกวนเข้าไปก็ได้เสียงรบกวนออกมา
- ปิดบัง IP ก่อนแชร์ screenshot การวิเคราะห์รันในเครื่อง แต่พอคุณแปะภาพแดชบอร์ดลง issue tracker สาธารณะ IP พวกนั้นก็โชว์หมด เปลี่ยน octet เป็นตัว x ก่อนแชร์ออกนอกทีมเสมอ
- จับคู่กับ application log ด้วย timestamp access log บอกว่าเกิดอะไร application log บอกว่าทำไม หยิบนาที spike จาก analyzer ไปเทียบกับ error log ฝั่งแอป รากของปัญหามักโผล่ตั้งแต่จอแรก
- เทียบช่วงเวลาที่เหมือนกันเท่านั้น traffic วันอังคารเทียบวันอังคาร ไม่ใช่เทียบกับวัน launch ไม่งั้นสัดส่วน status code จะพาคุณไล่ผี
- อย่าประมาท 4xx กับ 5xx เหมือนกัน client error มักอยู่แถวเนื้อหา ลิงก์ และบอท ส่วน server error อยู่แถวโค้ดและ infrastructure สรุป status code จะบอกได้ว่าทีมไหนเป็นเจ้าภาพการแก้
- เก็บ baseline ก่อนเกิดเหตุไว้เสมอ วาง log ชั่วโมงเงียบ ๆ ตอนระบบปกติ แล้วจดรูปร่างแดชบอร์ดไว้ พอเทียบช่วงที่แย่กับ baseline ที่รู้ว่าดี ความช้าแบบลาง ๆ จะกลายเป็นผลต่างที่วัดได้
คราวหน้าที่ monitoring ติดไฟแดง หรือเพื่อนร่วมงานถามว่า "เว็บช้าแค่เครื่องฉันหรือเปล่า" อย่าเปิด terminal แล้วเริ่มเดา คัดลอก access log เฉพาะช่วงที่เกี่ยวข้อง วางลง Nginx Log Analyzer แล้วอ่าน incident แบบ responder: ใช้ status code จัดลำดับความสำคัญ, ใช้ IP กับ endpoint เรียกชื่อผู้กระทำ, ใช้ spike ระบุเวลาเกิดเหตุ — โดยที่ทุก byte ยังอยู่บนเครื่องคุณเท่านั้น
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- HAR File Analyzer — จับอีกด้านของเรื่องเดียวกันจากฝั่งเบราว์เซอร์ ทั้ง timing ของ request, waterfall และ status code จาก DevTools
- URL Parser — แยกส่วน endpoint ยาว ๆ ที่พ่วง query มาเป็นตัวท็อปในอันดับ endpoint ของคุณ
- Text Comparator — diff log สองช่วงเวลาแบบเทียบข้าง ๆ กัน เห็นชัดว่าหลัง deploy มี request อะไรเพิ่มเข้ามา
ขอให้ status code เป็นสีเขียวและทุก spike หาคำอธิบายได้เสมอ สวัสดีครับ
คำถามที่พบบ่อย
ถ: access log ของฉันถูกอัปโหลดไปที่เซิร์ฟเวอร์หรือเปล่า?
ตอบ: ไม่ การ parse และรวมข้อมูลทั้งหมดเกิดขึ้นในเบราว์เซอร์ของคุณด้วย JavaScript ฝั่ง client ล้วน ๆ บรรทัด log รวมถึง IP ข้างในนั้นไม่เคยออกจากเครื่องของคุณ นี่คือเหตุผลที่เครื่องมือนี้ใช้กับ log production และ log ที่อ่อนไหวเรื่องความเป็นส่วนตัวได้อย่างปลอดภัย
ถ: analyzer รองรับ log format แบบไหนบ้าง?
ตอบ: รองรับ nginx combined format และ Apache ทั้ง common กับ combined format โดยยอมรับ input ที่ปนกันได้ โดยข้ามบรรทัดที่จำแนกไม่ได้ ผลลัพธ์จาก log rotation มาตรฐานสามารถวางลงไปได้ทันทีโดยไม่ต้องแก้อะไร
ถ: วาง log ช่วงใหญ่แค่ไหนได้?
ตอบ: ให้วางเฉพาะช่วงที่จำเป็นจริง ๆ หนึ่งชั่วโมงรอบเหตุการณ์มักเพียงพอแล้ว paste ที่ยาวมากจะถูกจำกัดด้วยหน่วยความจำของเบราว์เซอร์ และช่วงที่กระชับให้ตัวเลขรวมคมและนำไปใช้ได้จริงกว่าอยู่แล้ว
ถ: traffic spike ในรายงานแปลว่าอะไรกันแน่?
ตอบ: มันชี้ช่วงเวลาที่ปริมาณ request พุ่งผิดปกติเมื่อเทียบกับช่วงรอบข้าง spike คือตัวตั้งข้อสงสัย ไม่ใช่ข้อสรุป ให้ดู status code และ top IP ในช่วงเวลาเดียวกันประกอบ เพื่อแยก scraper, retry storm หรือการโจมตี ออกจาก traffic จริงที่พุ่งเพราะความนิยม
ถ: ใช้ตัวนี้หาคนที่กำลังโจมตีเว็บผมได้ไหม?
ตอบ: คุณจะระบุได้ว่า IP ใดกำลังสร้างปริมาณที่น่าสงสัยและกำลังขออะไรอยู่ ซึ่งมักเพียงพอสำหรับเขียนกฎ rate-limit หรือ block ส่วนการไล่ตัวตนระดับลึกหรือการบังคับใช้นอก infrastructure ของคุณ ให้ส่ง IP และ timestamp ที่ดึงออกมาให้ทีม security หรือผู้ให้บริการต่อไป