Regex Data Generator: แปลง regex pattern เป็นข้อมูลทดสอบได้ในไม่กี่วินาที
สร้าง random string และ sample dataset ที่ตรงกับ regex pattern ได้ทุกรูปแบบ ทั้ง character class, range, alternation, group และ quantifier ทำงานในเบราว์เซอร์ 100% เหมาะกับการทำ test fixture
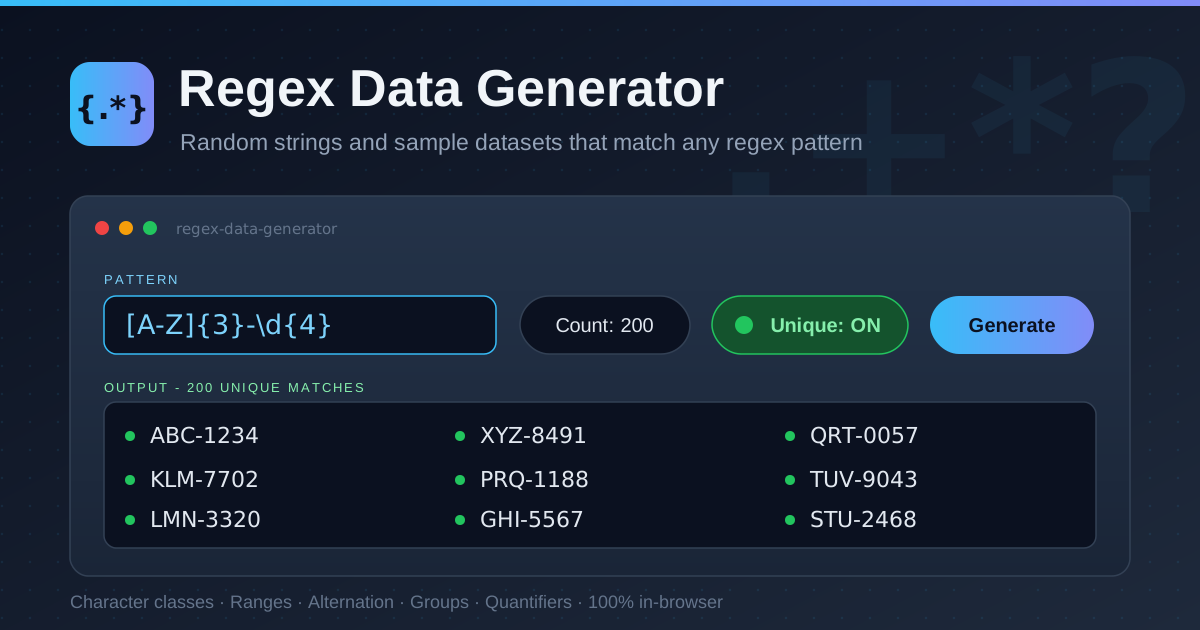
Table of Contents
Regex Data Generator: แปลง regex pattern เป็นข้อมูลทดสอบได้ในไม่กี่วินาที
นักพัฒนาทุกคนเคยเจอกำแพงเดียวกัน: คุณมี validation regex อยู่ในมือ แต่ต้องการข้อมูลตัวอย่างที่ตรงกับ pattern นั้นจริง ๆ validator จะดีแค่ไหนขึ้นอยู่กับข้อมูลทดสอบ — และการนั่งพิมพ์โค้ดสั่งซื้อปลอม 200 ตัวด้วยมือไม่ใช่หน้าที่ของใคร Regex Data Generator ปิดช่องว่างนี้ด้วยการอ่าน pattern ของคุณแล้วสร้าง random string และ sample dataset ที่ตรงตามนั้น รองรับครบทั้ง character class, range, alternation, group และ quantifier
ฟังดูเป็นเรื่องเล็ก จนกว่าคุณจะนึกดูว่า fixture ในโปรเจกต์ส่วนใหญ่มาจากไหน ส่วนใหญ่คือก๊อปจาก test เก่า แก้มือเล็กน้อย แล้วค่อย ๆ เหลื่อมกับข้อกำหนดจริงที่โค้ดบังคับอยู่ พอทีมสินค้าเปลี่ยนรูปแบบรหัสสั่งซื้อจาก ABC-1234 เป็น ABCD-12345 ก็ต้องมีคนไล่สร้างตัวอย่างใหม่ทุกจุด ไม่งั้น test จะยังผ่านอยู่กับข้อมูลที่ validator ตัวจริงปฏิเสธ การสร้าง fixture จาก pattern ตัวมันเองตัดปัญหานี้ตั้งแต่ต้นทาง เพราะ pattern คือแหล่งความจริงเดียว ส่วนข้อมูลเป็นแค่ผลลัพธ์ที่ไหลตามมา
และเพราะทุกอย่างทำงานในเบราว์เซอร์ 100% จึงไม่ต้องติดตั้งอะไร ไม่ต้องสมัครบัญชี และ pattern หรือข้อมูลที่สร้างได้ไม่เคยออกจากเครื่องคุณ วาง pattern เลือกจำนวน กด generate แล้วก๊อปผลลัพธ์ใส่ test ได้เลย
ทำไมต้องใช้ Regex Data Generator?
- fixture เกิดจาก pattern เดียวกับ validator พอดี ถ้า validation ในฟอร์มของคุณใช้ ^[A-Z]{3}-\d{4}$ ข้อมูลทดสอบก็มาจาก expression ตัวเดียวกัน ทุก string ที่ได้จึงเป็น positive case ที่ถูกต้องการันตี ไม่มี test ที่ผ่านกับข้อมูลที่ระบบจริงปฏิเสธอีก
- ไม่ต้องติดตั้ง fake-data library ไลบรารีข้อมูลปลอมเต็มรูปแบบเหมาะเวลาต้องการชื่อ ที่อยู่ และบัตรเครดิต แต่ถ้าแค่ต้องการ string 500 ตัวที่ตรงกับ (?:EUR|USD|GBP)-\d{6} การเพิ่ม dependency ถือว่าเกินจำเป็น เครื่องมือนี้ทำงานเดียวจบในแท็บเดียว
- เป็นส่วนตัวตั้งแต่การออกแบบ pattern มักฝังกฎทางธุรกิจภายในองค์กร ไม่ว่าจะเป็นรูปแบบ invoice, ระบบ SKU รุ่นเก่า หรือรหัสตั๋วภายใน เพราะการ generate เกิดขึ้นฝั่ง client ล้วน ๆ โครงสร้างพวกนี้จึงไม่ถูกอัปโหลดไปไหนเลย
- มี unique mode สำหรับ field แบบ key เปิดโหมด unique แล้วเครื่องมือจะกรองผลลัพธ์ซ้ำออก ซึ่งสำคัญมากเวลา string นั้นทำหน้าที่เป็น primary key, coupon code หรือ test identifier ที่ห้ามชนกันระหว่าง assertion
- เร็วพอสำหรับงานปริมาณมาก การสร้างข้อมูลหลักร้อยถึงหลักพันแถวใช้เวลาไม่กี่วินาที payload สำหรับ load test และไฟล์ seed จึงอยู่ห่างแค่การกดสร้างใหม่รอบเดียว ไม่ใช่การนั่งเขียน script ทั้งบ่าย
- ไม่ต้องเรียนรู้อะไรเพิ่มนอกจาก regex เอง ถ้าเขียน pattern ได้ คุณใช้เครื่องมือนี้เป็นแล้ว ไม่มี template language, ไม่มี schema file, ไม่มี config ให้ท่อง
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| รับ pattern ได้ทุกรูปแบบ | วาง character class, range, alternation, group และ quantifier ได้เลย |
| ขยาย class และ range | เลือกสมาชิกจริงจากเซตอย่าง [A-Za-z0-9] และ range อย่าง [a-f0-9] |
| alternation และ group ซ้อน | เลือกแขนงจากตัวเลือกอย่าง cat|dog และเคารพโครงสร้าง group |
| จัดการ quantifier | ทำซ้ำ token ตาม {3}, +, ? และ * พร้อมขอบเขตที่เหมาะสม |
| กำหนดจำนวนที่สร้าง | เลือกได้ว่าต้องการ string หรือแถวข้อมูลกี่ชิ้นพอดี |
| unique mode | กรองผลลัพธ์ซ้ำสำหรับ key, code และ identifier |
| ก๊อปคลิกเดียว | ย้ายผลลัพธ์เข้าไฟล์ test, CSV หรือ payload ได้ทันที |
| ทำงานในเบราว์เซอร์ 100% | ไม่มีอัปโหลด ไม่มีบัญชี ไม่มีการเรียก network ระหว่าง generate |
บางฟีเจอร์ควรดูใกล้ ๆ หน่อย:
- การขยาย class และ range คือจุดที่ความถูกต้องอยู่ generator แบบหยาบ ๆ อาจปล่อยตัวอักษรอะไรก็ได้ตรงที่มี class เครื่องมือนี้ resolve class เป็นสมาชิกจริงก่อน เลยเป็นไปไม่ได้ที่ [A-Fa-f0-9] จะปล่อยตัวอักษรนอกเซต hexadecimal ออกมา
- unique mode ทำงานตามจำนวนที่ขอ ถ้าขอ string แบบไม่ซ้ำมากกว่าที่ pattern space จะเลี้ยงไหว คุณจะเห็นว่าระบบลองสุ่มใหม่เพื่อเลี่ยง collision แทนที่จะปล่อยของซ้ำมาเงียบ ๆ
- การคุมจำนวนทำให้ผลลัพธ์คาดเดาได้ สิบกว่า string สำหรับ unit test, ห้าพันสำหรับไฟล์ seed — pattern เดิม แค่เปลี่ยนตัวเลขเดียว
วิธีใช้งาน
- วาง pattern ใส่ regex ที่ต้องการให้ข้อมูลตรง เช่น [A-Z]{3}-\d{4} สำหรับรหัสสั่งซื้อ หรือ (?:\+66|0)\d{9} สำหรับเบอร์โทรในไทย
- ตั้งจำนวนที่จะสร้าง เลือกกี่ string — ไม่กี่ตัวสำหรับ assertion, หลักร้อยสำหรับ fixture, หลักพันสำหรับไฟล์ seed
- เปิดโหมด unique สลับ unique เป็น ON เมื่อผลลัพธ์ซ้ำจะทำ test พัง เช่น primary key หรือ coupon code
- กด generate เครื่องมือจะเดินไล่โครงสร้าง pattern ของคุณแล้วปล่อย random string ที่ตรงกับมันออกมา
- ก๊อปใส่ test หรือ CSV นำผลลัพธ์ไปวางใน unit test, ไฟล์ seed หรือ load-test script แต่ละบรรทัดคือ fixture พร้อมใช้งานหนึ่งตัว
pattern กลายเป็น string ได้อย่างไร
จุดที่น่าสนใจคือสิ่งที่เกิดขึ้นระหว่างวาง pattern กับเห็นผลลัพธ์ การ generate ไม่ได้ไล่เปิดพจนานุกรมหรือ brute-force หาตัวเลือก แต่เดินไล่ต้นไม้ของ pattern โดยตรง แล้วตัดสินใจด้วยความสุ่มทีละ node
ขั้นแรก pattern ถูก parse เป็นต้นไม้: literal กลายเป็นใบไม, character class กลายเป็นเซต, group เป็นที่ครอบ และ quantifier ครอบ node ลูกของมัน จากนั้นการ generate จะไล่ลงต้นไม้นั้น โดยวาดความสุ่มที่ทุก node:
- character class เลือกสมาชิก สำหรับ [A-Za-z0-9] เครื่องมือขยาย range ให้เป็นชุดตัวอักษรที่อนุญาตทั้งหมดก่อน แล้วสุ่มหยิบหนึ่งตัว range ถูกขยายเป็นสมาชิกจริง — [a-f] กลายเป็น a, b, c, d, e, f — ทุกการสุ่มจึงอยู่ใน class แท้ ๆ เสมอ
- alternation เลือกแขนง สำหรับ cat|dog generator เลือกหนึ่งแขนงต่อหนึ่ง string ผลลัพธ์จึงผสมกันตามธรรมชาติ ไม่ใช่ได้ cat ยี่สิบตัวติดกัน
- group ซ้อนกันได้ group ก็แค่ subtree หนึ่งต้น (?:AB|CD)(?:12|34) จึงเดินการตัดสินใจสองชุดที่เป็นอิสระกัน และครบทั้งสี่แบบเมื่อสร้างเป็นชุด
- quantifier ทำซ้ำ {3} ทำซ้ำเป๊ะสามครั้ง, ? ตัดสินใจครั้งเดียวว่า token จะปรากฏไหม, + ทำซ้ำโดยมีขอบบนกันพัง, และ greedy quantifier เลือกจำนวนรอบไว้ล่วงหน้า แทนที่จะปล่อย string ยาวขึ้นเรื่อย ๆ จนกว่าอะไรบางอย่างจะพัง
ลองดูมันทำงานกับ pattern รหัสสั่งซื้อ [A-Z]{3}-\d{4} ต้นไม้มีห้า node: class ที่ถูก quantifier บังคับให้เป็นตัวอักษรพิมพ์ใหญ่สามตัว, literal ขีดกลาง และ class ตัวเลขสี่ตัว หนึ่งรอบการสร้างสุ่มได้ K, L, M สำหรับตัวอักษร แล้ว 7, 0, 2, 9 สำหรับตัวเลข ก็ปล่อย KLM-7029 ออกมา ทุกผลลัพธ์ต่างกัน ทุกผลลัพธ์ตรง pattern และคุณไม่ต้องพิมพ์แม้แต่ตัวเดียว
มีข้อควรระวังหนึ่งข้อที่ควรจดไว้ในสมุดของทุกคนที่ใช้ regex: unbounded quantifier pattern อย่าง [a-z]+ ตามทฤษฎีตรงกับ string ได้ไม่จำกัด ผู้ generate จึงต้องจัดขอบบนให้ความยาวเพื่อความเร็ว — หมายความว่า string ที่ได้ถูกต้อง แต่การกระจายความยาวเป็นดุลพินิจของเครื่องมือ ไม่ใช่ของคุณ pattern ที่มีขอบเขตชัดอย่าง [a-z]{8,12} generate เร็วกว่า คาดเดาได้กว่า และให้ fixture ที่มีรูปร่างตรงกับสิ่งที่ validation คาดหวังจริง เมื่อคุณกำหนดขอบเขตเอง คุณก็เป็นคุมข้อมูลเอง
กรณีใช้งานจริง
fixture สำหรับ unit test
กรณีคลาสสิก: ฟังก์ชัน isValidOrderCode() ของคุณคาดหวัง [A-Z]{3}-\d{4} ก็สร้างการจับคู่มาห้าสิบชุด แล้ว assert ว่าผ่านทั้งหมด จากนั้นกลับตรรกะ ตรวจว่าตัวอย่างที่แก้เพี้ยนไม่กี่ตัวถูกปฏิเสธ positive coverage จึงไม่ถูกจำกัดด้วยความอดทนในการพิมพ์ตัวอย่างอีกต่อไป
แถวข้อมูลสำหรับ CSV และ database seed
การย้าย schema, สภาพแวดล้อม demo และ integration test ล้วนต้องการแถวข้อมูลที่ดูน่าเชื่อ สร้างคอลัมน์รหัสด้วย pattern ของ ID สร้างใหม่ตามแต่ละ environment ไฟล์ seed ของคุณจึงสอดคล้องกับกฎรูปแบบเสมอ โดยไม่มีค่า hardcode สักตัวให้ค่อย ๆ เน่า
payload สำหรับ load test
เครื่องมือทดสอบประสิทธิภาพต้องการ body ที่สมจริงในปริมาณมาก สร้าง identifier ที่ตรง pattern สองพันตัว เทลง template ของ request แล้ว load test ของคุณจะไปโดนเส้นทาง parsing และ validation ด้วยข้อมูลที่ระบบยอมรับ ไม่ใช่ค่าปลอม ๆ ที่โดนดักตั้งแต่ประตูแรก
ข้อมูล demo สำหรับภาพหน้าจอ
ภาพหน้าจอสินค้าและเอกสารจะดูเก่าเร็วถ้าข้อมูลตัวอย่างปลอมชัดเจนเกินไป การสร้างรหัสเรียบร้อยอย่าง ABC-1234 และ XYZ-8491 ช่วยให้ mockup น่าเชื่อถือ และการสร้างชุดใหม่สำหรับภาพแต่ละรอบใช้เวลาไม่กี่วินาที
แนวทางปฏิบัติที่ดี
- สะท้อน validation regex ของคุณให้ตรงเป๊ะ ก๊อป pattern ออกจาก validator จริง — รวม anchor, flag และทุกอย่าง — แทนที่จะพิมพ์เลียนแบบจากความจำ fixture จาก pattern ผิด ๆ แย่กว่าไม่มี fixture เสียอีก เพราะมันพังแบบเงียบ ๆ
- รักษา quantifier ให้มีขอบเขต เลือก {3} และ {8,12} แทน + และ * เวลาใส่ input ให้ generator ความยาวผลลัพธ์จึงเป็นสิ่งที่คุณตั้งใจ การ generate เร็ว และ fixture มีรูปร่างตรงกับข้อมูล production ที่ควรเป็น
- เปิด unique mode กับทุกอย่างที่ทำหน้าที่เป็น key primary key, coupon code และ session identifier ควรสร้างโดยเปิดการกรองซ้ำไว้ ไม่งั้น collision ที่เกิดนาน ๆ ครั้งจะแลกมาด้วยบ่ายทั้งบ่ายที่ไล่หาว่าทำไม test พังเฉพาะบางรอบ
- อย่าลืมพื้นที่กรณีลบ สร้าง string ที่ตรง pattern จากที่นี่ แล้วพลิกตัวอักษรหนึ่งตัว — ตัวพิมพ์เล็กในจุดที่ [A-Z] ต้องการตัวใหญ่ — แล้วยืนยันว่า validator ของคุณปฏิเสธ ใช้ Regex Tester คู่กันเพื่อตรวจทั้งสองทิศทาง
- จัดเก็บ fixture ให้ไปด้วยกันกับ pattern เมื่อรูปแบบเปลี่ยน ให้สร้างใหม่แทนการแก้ตัวอย่างด้วยมือ และเก็บ pattern ไว้ใน commit เดียวกับ fixture เพื่อให้ทั้งสองไม่มีวันขัดแย้งกันเงียบ ๆ
- ตรวจตัวอย่างก่อน commit เสมอ กวาดตาดูผลลัพธ์สักสิบกว่าตัวว่าดูสมเหตุสมผลไหม — generator การันตีความถูกต้องด้านรูปแบบ ไม่ใช่ความสมเหตุสมผลด้านธุรกิจ และมีแค่คุณที่รู้ว่า XXX-0000 ดูผิดปกติ
พร้อมเลิกพิมพ์ข้อมูลปลอมด้วยมือแล้วหรือยัง? เปิด Regex Data Generator วาง pattern ที่คุณเชื่อถืออยู่แล้ว แล้วเปลี่ยนมันเป็น fixture สะอาด ๆ ร้อยตัว ก่อน test runner ของคุณจะรันเสร็จ
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Regex Tester — ทดสอบ pattern แบบเรียลไทม์ และยืนยันว่า fixture ที่สร้างได้ตรงจริง
- Regex Generator — สร้าง pattern จากตัวอย่างข้อมูล เมื่อรู้รูปแบบแต่นึก syntax ไม่ออก
- UUID Generator — สร้าง identifier แบบไม่ซ้ำ เมื่อ test key ของคุณต้องการความสุ่มสูงกว่าที่ pattern ให้ได้
ข้อมูล fixture ควรเป็นผลพลอยได้จาก pattern ไม่ใช่สิ่งที่พิมพ์มือทีหลัง — สร้างครั้งแรกด้วยเครื่องมือ แล้วสร้างใหม่บ่อย ๆ
คำถามที่พบบ่อย
ถ: Regex Data Generator อัปโหลด pattern หรือข้อมูลที่สร้างขึ้นไปไหนบ้าง?
ตอบ: ไม่เลย การ parse และ generate ทำงานในเบราว์เซอร์ของคุณล้วน ๆ ด้วย JavaScript รูปแบบภายในองค์กร, ระบบ SKU รุ่นเก่า และ fixture ที่สร้างได้จึงไม่มีวันออกจากเครื่อง ไม่มีบัญชี และไม่มีการติดต่อ server
ถ: รองรับ regex syntax แบบไหนบ้าง?
ตอบ: แกนหลักที่ engine ส่วนใหญ่ใช้ร่วมกัน ได้แก่ character class และ range, negated class, alternation, capturing และ non-capturing group รวมถึง quantifier อย่าง {n}, {n,m}, *, + และ ? ส่วน construct เฉพาะ engine อย่าง lookbehind assertion ไม่มีความหมายต่อการ generate เพราะมันบรรยายบริบท ไม่ใช่เนื้อหาของ string
ถ: ทำไม unbounded quantifier อย่าง + ถึงได้ string ที่สั้นกว่าที่คิด?
ตอบ: pattern อย่าง [a-z]+ ตรงกับ match ที่ยาวได้ไม่จำกัด generator จึงต้องจัดขอบบนของการทำซ้ำที่ระดับเหมาะสมเพื่อให้ generate เร็วและผลลัพธ์ใช้งานได้ ถ้าต้องการช่วงความยาวเฉพาะ ให้เขียนมันลงใน pattern เลย — [a-z]{8,12} ทำให้การกระจายความยาวเป็นของคุณ ไม่ใช่ของเครื่องมือ
ถ: unique mode เจอปัญหาหรือทำงานช้าได้ไหม?
ตอบ: ถ้าขอ string แบบไม่ซ้ำจำนวนมากกว่าที่ pattern space จะเลี้ยงได้จริง เครื่องมือจะใช้แรงไปกับการสุ่มใหม่เพื่อเลี่ยง collision ให้ตั้งจำนวนที่ขอไว้ต่ำกว่าขนาดของผลลัพธ์ที่เป็นไปได้ทั้งหมดอย่างสบาย ๆ unique mode ก็จะเร็วเหมือนเดิมเสมอ
ถ: ตัวนี้ใช้แทน property-based testing library ได้ไหม?
ตอบ: ทั้งคู่เสริมกัน คือ framework แบบ property-based จะ generate input และย่อ failing case ให้อัตโนมัติภายใน test runner ส่วนเครื่องมือนี้ให้ fixture เป็นชุดทันทีสำหรับไฟล์ seed, load test และงาน demo โดยไม่ต้องเพิ่ม dependency ให้โปรเจกต์ หลายทีมใช้ทั้งสองแบบควบคู่กันไป