Regex Explainer: ถอดรหัส Regular Expression เป็นภาษาง่าย ๆ
วาง regex แล้วรับคำอธิบายทีละ token เป็นภาษาอังกฤษง่าย ๆ พร้อมโครงสร้าง group และการตรวจไวยากรณ์ เข้าใจและ debug regular expression ฟรีในเบราว์เซอร์
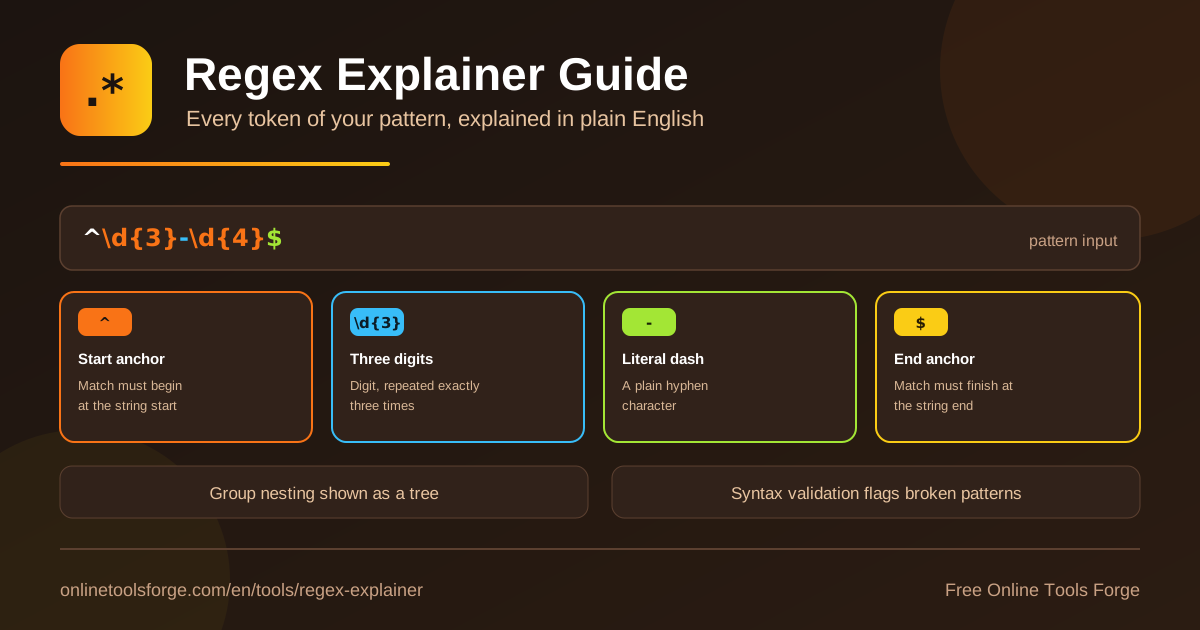
Table of Contents
Regular expression หรือ regex เป็นเครื่องมือทรงพลังที่สุดอย่างหนึ่งของนักพัฒนา แต่ก็เป็นภาษาที่อ่านยากที่สุดเช่นกัน เวลาเจอ pattern ยาว ๆ อย่าง ^(?=.*\d)[\w@]{8,}$ คนส่วนใหญ่ต้องนั่งถอดทีละตัวอักษร และมักต้องเปิดค้นหาระหว่างทาง Regex Explainer คือเครื่องมือฟรีที่แก้ปัญหานี้โดยตรง — วาง regex ลงไปแล้วได้คำอธิบายเป็นภาษาอังกฤษง่าย ๆ ทีละ token ทันที โดยไม่ต้องมีความรู้เรื่อง regex engine มาก่อน
สิ่งที่ทำให้ต่างจากการค้นข้อมูลเองคือเครื่องมือแยก pattern ออกเป็นชิ้นเล็ก ๆ แสดงโครงสร้าง group ที่ซ้อนกันเป็น tree และตรวจไวยากรณ์ให้ด้วย ถ้า regex พิมพ์ผิด ลืมปิดวงเล็บ หรือใช้ flag ผิด เครื่องมือจะชี้ให้เห็นทันที โดยไม่ต้องรันโค้ดจริงเพื่อดู error
ทั้งหมดทำงานใน browser 100% ไม่มีการส่งข้อมูลขึ้น server ไม่ต้องสมัครสมาชิก เปิดใช้ได้ทันทีจากทุกอุปกรณ์
ทำไมต้องใช้ Regex Explainer?
- อ่าน regex ของคนอื่นได้ในไม่กี่วินาที — เจอ pattern ใน Stack Overflow, config file หรือโค้ดเก่า วางลงเครื่องมือแล้วรู้ความหมายทันที ไม่ต้องเดาเอง
- Debug ได้เร็วขึ้น — เห็นแต่ละ token แยกกันชัด ๆ ทำให้จับได้เองว่า quantifier หรือ character class ตัวไหนทำให้ pattern match ผิด
- ตรวจไวยากรณ์ก่อนใช้จริง — ตรวจ pattern ที่พัง วงเล็บไม่ครบ และ flag ที่ใช้ผิด ก่อน error จะไปโผล่ใน production
- เรียนรู้ regex จากตัวอย่างจริง — คำอธิบายแต่ละ token ช่วยให้จำได้ว่า \d, +, (?:...) ทำอะไร โดยเรียนจาก pattern ที่สนใจจริง ๆ
- เห็นโครงสร้าง group ที่ซ้อนกัน — regex ที่มี nested group หลายชั้นอ่านยากมากในรูปแบบข้อความ แต่แสดงเป็น tree แล้วเข้าใจได้ทันที
- ใช้ฟรี ไม่มีข้อจำกัด — ทำงานใน browser ทั้งหมด ไม่ต้องติดตั้ง ไม่ต้องสมัคร เหมาะกับงานด่วนระหว่างเขียนโค้ด
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| Token-by-token explanation | วาง regex แล้วได้คำอธิบายแต่ละ token เป็นภาษาอังกฤษง่าย ๆ รู้ทันทีว่าแต่ละส่วนแปลว่าอะไร |
| Group structure tree | แสดงโครงสร้าง group ที่ซ้อนกันเป็น tree มองเห็นลำดับชั้นของ group ชัดเจน ไม่ต้องนับวงเล็บ |
| Syntax validation | ตรวจไวยากรณ์และ flag pattern ที่พัง ชี้จุดผิดก่อนนำไปใช้จริง |
| ครอบคลุมองค์ประกอบหลัก | อธิบาย anchors, character classes, quantifiers, escapes, groups และ alternation ครบ |
| ทำงานใน browser 100% | ไม่มี server ไม่มีการส่งข้อมูลออก ใช้ได้จากทุกอุปกรณ์ |
จุดเด่นเพิ่มเติม:
- คำอธิบายใช้ภาษาอังกฤษแบบเรียบง่าย เหมาะกับทั้งมือใหม่และคนที่แค่ลืม syntax
- ไม่ต้องมีพื้นฐานเรื่อง regex engine มาก่อน เครื่องมือแปลงสัญลักษณ์เป็นข้อความให้หมด
- รองรับการวิเคราะห์ pattern ซับซ้อน เช่น lookahead และ group ที่ซ้อนกันหลายชั้น
วิธีถอดความหมาย Regex
- เปิด Regex Explainer ใน browser — ไม่ต้องสมัครหรือติดตั้งอะไรเพิ่ม
- วาง regex ที่ต้องการถอดความหมายลงในช่องป้อนข้อมูล หรือพิมพ์ทีละส่วนเพื่อทดสอบไปด้วย
- อ่านคำอธิบายทีละ token ที่แสดงขึ้นทันที แต่ละ token จะมีคำแปลเป็นภาษาอังกฤษง่าย ๆ กำกับไว้
- ดูโครงสร้าง group เป็น tree เพื่อเข้าใจว่า group ไหนซ้อนอยู่ในกลุ่มไหน และแต่ละกลุ่มครอบคลุมช่วงใดของ pattern
- ถ้ามี syntax error หรือ flag ที่พัง เครื่องมือจะแจ้งเตือน — แก้จนไม่มี error แล้วค่อยนำ pattern ไปใช้ในโค้ดจริง
อ่าน Regex ทีละ Token
เมื่อเข้าใจองค์ประกอบหลักของ regex การอ่าน pattern จะเปลี่ยนจากการเดาเป็นการแปล
Anchors กำหนดตำแหน่ง: ^ หมายถึงจุดเริ่มต้นบรรทัด ส่วน $ หมายถึงจุดสิ้นสุด ถ้า pattern ไม่มี anchor เลย แปลว่า match ได้จากตำแหน่งใดก็ได้ในข้อความ ซึ่งมักเป็นสาเหตุของผลลัพธ์ที่ไม่คาดคิดตอน validate
Character classes กำหนดชุดตัวอักษรที่ยอมรับ เช่น \d คือตัวเลข, \w คือตัวอักษร ตัวเลข และขีดล่าง, [a-z] คือตัวอักษรพิมพ์เล็ก a ถึง z, และ [^0-9] คือทุกอย่างที่ไม่ใช่ตัวเลข เครื่องหมาย ^ ภายในวงเล็บมีความหมายต่างจาก anchor ข้างนอก — จุดนี้เป็นหนึ่งในความสับสนคลาสสิกที่คำอธิบายทีละ token ช่วยขจัดได้ดีที่สุด
Quantifiers บอกจำนวนครั้งที่เกิดซ้ำ: * (ศูนย์ครั้งขึ้นไป), + (หนึ่งครั้งขึ้นไป), ? (ศูนย์หรือหนึ่งครั้ง), {2,4} (สองถึงสี่ครั้ง) และการเติม ? ต่อท้าย เช่น .*? จะเปลี่ยนเป็น lazy matching ซึ่งสำคัญมากเวลา parse ข้อความที่มีตัวคั่นซ้ำ
Groups และการซ้อนกัน — ( ... ) จับส่วนที่ match เก็บไว้ใช้ภายหลัง, (?: ... ) คือ group ที่ไม่ capture, และ (?<name> ... ) ตั้งชื่อ group ได้ เมื่อ group ซ้อนกันหลายชั้น tree view จะช่วยให้เห็นว่าใครครอบใครทันที ไม่ต้องนับวงเล็บด้วยตาลำบาก ๆ
Escapes ใช้ backslash เพื่อจับคู่ตัวอักษรพิเศษแบบตรงตัว เช่น \. match จุดจริง ๆ ไม่ใช่ตัวอักษรใดก็ได้อย่าง . ธรรมดา การลืม escape จุดหรือวงเล็บเป็นบั๊กยอดฮิตที่ตัวตรวจไวยากรณ์ช่วยจับได้ก่อนใช้งาน
Alternation คือเครื่องหมาย | แปลว่า "หรือ" เช่น cat|dog match คำว่า cat หรือ dog ข้อควรระวังคือ | แบ่งฝั่งซ้ายขวากว้างกว่าที่คิด ถ้าไม่ครอบด้วย group เช่น (cat|dog)s ผลลัพธ์อาจไม่ตรงเจตนา
ตัวอย่าง pattern เดียวที่รวมหลายองค์ประกอบ:
^(\d{3})-(\w+)$
^        ต้องขึ้นต้นบรรทัด
(\d{3})  กลุ่มที่ 1: ตัวเลข 3 หลัก
-        ขีดปกติ
(\w+)$   กลุ่มที่ 2: ตัวอักษรหรือตัวเลข อย่างน้อย 1 ตัว แล้วจบท้ายบรรทัด
แบบนี้แหละที่ Regex Explainer สร้างให้โดยอัตโนมัติ สำหรับ pattern ที่ยาวกว่านี้หลายเท่า
กรณีใช้งานจริง
ถอดโค้ด regex ที่ได้รับมา
สมมติคุณย้ายเข้าทีมใหม่ และเจอใน legacy code ว่ามี validation แบบนี้: ^(?:\+66|0)\d{8,9}$ แทนที่จะถามรอบทีมหรือเดาเอง วางลง Regex Explainer แล้วจะเห็นทันทีว่า pattern นี้รับเบอร์โทรที่ขึ้นต้นด้วย +66 หรือ 0 ตามด้วยตัวเลข 8-9 หลัก — ความหมายชัดในไม่กี่วินาที โดยไม่ต้องเสี่ยงแก้ผิด
ตรวจ pattern ใน code review
เวลา review pull request ที่มีการเพิ่ม regex ใหม่ การอ่านด้วยตาเปล่ามักไม่พอ คัดลอก pattern จาก diff มาวางในเครื่องมือ แล้วไล่ตรวจว่าแต่ละ token ตรงกับ requirement จริงหรือไม่ reviewer มักเจอปัญหาอย่าง quantifier ที่ greedy จน match เกินขอบเขต หรือ alternation ที่ไม่ได้ครอบด้วย group — จุดเหล่านี้จับยากใน diff แต่ชัดเจนใน token view ถ้าอยากพิสูจน์พฤติกรรมจริงต่อ ก็เอาไปรันกับข้อมูลจริงด้วยเครื่องมือทดสอบ regex ได้
เรียน regex เร็วขึ้น
แทนที่จะท่องตาราง syntax ทั้งหน้า ให้เรียนจาก pattern ที่เจอจริง เจอตัวอย่างในบทความหรือ tutorial ก็วางลงเครื่องมือ อ่านคำอธิบาย แล้วลองแก้ทีละ token เพื่อดูว่าความหมายเปลี่ยนไปอย่างไร วิธีนี้เรียนจากสิ่งที่เห็นเป็นรูปธรรม เร็วกว่าอ่านตำรา และรู้ทันทีเมื่อพิมพ์ผิด เพราะตัวตรวจไวยากรณ์เตือนให้ตลอด
จัดทำเอกสาร pattern
ทีมที่มี regex ใช้งานบ่อย เช่น ตรวจ email, เบอร์โทร หรือรูปแบบรหัสสินค้า ควรมีเอกสารกำกับทุก pattern ใช้คำอธิบายจากเครื่องมือเป็นฐาน แล้วเขียนต่อว่าใช้ที่ไหน รับกรณีใดบ้าง และมีข้อจำกัดอะไร เอกสารแบบนี้ช่วยให้สมาชิกใหม่เข้าใจได้เร็ว และลดการเขียน regex ซ้ำหรือซ้อนทับกันในระบบ
แนวทางปฏิบัติที่ดี
- ใส่คอมเมนต์กำกับ pattern ที่ซับซ้อนเสมอ — แม้ถอดความหมายได้เร็ว แต่คอมเมนต์สั้น ๆ ข้าง regex ในโค้ดยังช่วยผู้อ่านคนถัดไปอีกหลายคน
- ใช้ non-capture group (?: ... ) เมื่อไม่ต้องการจับค่า — ทำให้โครงสร้าง group สะอาด และลด overhead ตอน runtime
- ใส่ anchor ให้ครบเมื่อ validate ทั้งสตริง — ถ้าจุดประสงค์คือตรวจว่า input ทั้งหมดถูกรูปแบบ อย่าลืม ^ และ $ เพื่อกันการ match บางส่วน
- ระวัง greedy vs lazy ของ quantifier — .* กับ .*? ให้ผลต่างกันมากเมื่อข้อความมีตัวคั่นซ้ำ ทดสอบกับข้อมูลจริงก่อนใช้
- escape ตัวอักษรพิเศษให้ครบ — จุด วงเล็บ และเครื่องหมายบวก ต้องใส่ backslash หากต้องการ match แบบตรงตัว
- ทดสอบกับข้อมูลขอบ (edge cases) เสมอ — สตริงว่าง ตัวอักษรพิเศษ และความยาวสุดขีด คือจุดที่ regex พังบ่อยที่สุด
พร้อมถอดรหัส regex ตัวแรกแล้วหรือยัง? เปิด Regex Explainer วาง pattern ที่คุณเคยอ่านไม่เข้าใจ แล้วดูมันกลายเป็นภาษาง่าย ๆ ภายในไม่กี่วินาที ใช้ฟรี ไม่จำกัดจำนวนครั้ง ไม่ต้องสมัคร และข้อมูลไม่ออกจาก browser ของคุณ — เหมาะกับการเปิดทิ้งไว้คู่กับ editor ตลอดวันทำงาน
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Regex Tester — ทดสอบว่า pattern ของคุณ match ข้อมูลจริงอย่างไร
- Regex Generator — สร้าง regex จากคำอธิบายภาษาธรรมชาติ
- Regex Railroad Diagram Generator — เปลี่ยน regex เป็นแผนภาพทางรถไฟที่อ่านง่ายด้วยสายตา
ขอให้สนุกกับการถอดรหัส!
คำถามที่พบบ่อย
ถ: Regex Explainer รองรับ syntax แบบไหนบ้าง?
ตอบ: เครื่องมือครอบคลุมองค์ประกอบมาตรฐานที่ใช้ทั่วไป เช่น anchors, character classes, quantifiers, escapes, groups และ alternation สำหรับ syntax เฉพาะของ engine ใด engine หนึ่ง ให้วางแล้วดูผลการตรวจไวยากรณ์ประกอบไปด้วย
ถ: ต้องมีความรู้ regex มาก่อนไหม?
ตอบ: ไม่ต้องเลย เครื่องมือออกแบบมาให้ใช้ได้โดยไม่ต้องรู้จัก regex engine มาก่อน คำอธิบายแต่ละ token เป็นภาษาอังกฤษง่าย ๆ และคุณจะเรียนรู้ไปพร้อมกันจาก pattern ที่สนใจจริง
ถ: ข้อมูล regex ที่วางลงไปถูกส่งไป server หรือเปล่า?
ตอบ: ไม่ เครื่องมือทำงานใน browser 100% การประมวลผลทั้งหมดเกิดบนเครื่องของคุณ ไม่มีข้อมูลถูกส่งขึ้น server จึงปลอดภัยแม้กับ pattern จากงานภายในองค์กร
ถ: ความหมายถูกแต่ในโค้ดจริงยังไม่ทำงานตรงใจ ควรทำอย่างไร?
ตอบ: ความหมายถูกไม่ได้แปลว่าพฤติกรรมตรงตามต้องการ ให้เอา pattern ไปทดสอบกับข้อมูลจริงด้วยเครื่องมือทดสอบ regex และตรวจ flag ที่ใช้ประกอบด้วย เพราะ flag ต่างกันอาจเปลี่ยนผลลัพธ์ได้มาก
ถ: ใช้ฟรีจริงหรือ มีข้อจำกัดจำนวนครั้งไหม?
ตอบ: ฟรีและไม่จำกัดจำนวนครั้ง ไม่ต้องสมัครสมาชิกหรือใส่อีเมล เปิดใช้ได้ทันทีจาก browser บนทุกอุปกรณ์