SQL Schema Diff: เทียบสคีมาฐานข้อมูลและสร้างคำสั่ง ALTER TABLE อัตโนมัติ
ใช้ SQL Schema Diff เปรียบเทียบสคีมาสองชุดจาก CREATE TABLE หรือ dump ไฟล์ เจอ table และ column ที่เพิ่ม เปลี่ยน หรือถูกลบ พร้อมเสนอคำสั่ง ALTER TABLE ทำงานในเบราว์เซอร์ทั้งหมด
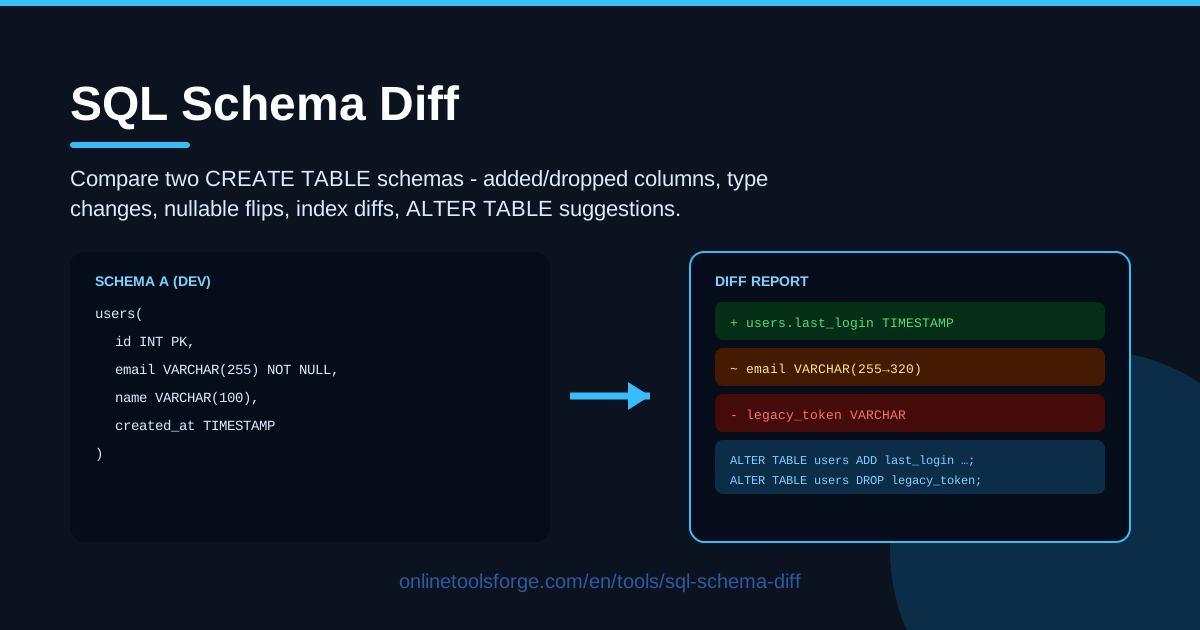
Table of Contents
ฐานข้อมูลแทบไม่เคยหยุดนิ่ง วันศุกร์บ่าย hotfix เพิ่ม column เข้ามาหนึ่งตัว สัปดาห์ถัดมา feature branch เปลี่ยนชื่อ field ไปอีกชื่อ แล้วตอนเช้าวันจันทร์ schema ที่รันอยู่บน production ก็ไม่ตรงกับไฟล์ migration อีกต่อไป ปัญหาคือมักไม่มีใครสังเกตเห็น จนกระทั่ง query พังตอนรันจริง ORM ร้องหา property ที่หายไป หรือต้อง rollback release ต่อหน้าผู้ใช้
SQL Schema Diff คือเครื่องมือออนไลน์ฟรีที่ออกแบบมาเพื่อจับความไม่ตรงกันแบบนี้ตั้งแต่เนิ่น ๆ เพียงวาง CREATE TABLE DDL สองชุด หรือ schema ที่ dump ออกมาลงในเครื่องมือ มันจะรายงาน table และ column ที่เพิ่มเข้ามาหรือถูกลบไป, การเปลี่ยน type, การพลิก nullable, การเปลี่ยน default และ index diff ทั้งหมด พร้อมทั้งชี้ rename ที่น่าจะเป็นไปได้ และเสนอคำสั่ง ALTER TABLE สำหรับทุกความต่างที่พบ ทำให้คุณเดินจากจุดที่รู้แค่ว่า "มีอะไรเปลี่ยนไป" ไปสู่แผน migration ที่พร้อมรีวิวได้ภายในไม่กี่วินาที
ทุกอย่างประมวลผลในเบราว์เซอร์ของคุณ ไม่มีการอัปโหลด schema ไม่ต้องสมัครบัญชี และไม่ต้องเชื่อมต่อฐานข้อมูล จึงใช้ได้อย่างปลอดภัยแม้กับ dump ที่มาจาก production หรือ schema ของลูกค้าที่ห้ามส่งออกไปบริการภายนอก
ทำไมต้องใช้ SQL Schema Diff?
- จับ schema drift ก่อนที่ production จะพัง dev, staging และ production หลุดกันเงียบ ๆ ตลอดเวลา การ diff หนึ่งครั้งเปลี่ยนคำว่า "คิดว่าน่าจะตรงกัน" ให้กลายเป็นข้อเท็จจริงที่ตรวจสอบแล้ว ก่อนคุณกด deploy
- รีวิว migration ด้วยหลักฐานจริง แทนที่จะเชื่อ migration ที่ ORM สร้างให้โดยไม่ตรวจสอบ ลอง diff DDL ก่อนกับหลัง เพื่อยืนยันว่ามันทำตรงตามที่คาดไว้ และไม่มีอะไรแถมมาเกินความจำเป็น
- ไม่ต้องไล่อ่าน DDL หลายร้อยบรรทัดด้วยตาเปล่า การเทียบ dump สองไฟล์ใหญ่ด้วยมือทั้งช้าและพลาดง่าย เครื่องมือ diff อ่านทุก table, column และ index ให้จบในไม่กี่มิลลิวินาที
- ลดความเสี่ยงข้อมูลหายโดยไม่ตั้งใจ column ที่ถูกลบและ type ที่แคบลง คือสองสาเหตุคลาสสิกที่ทำให้การเปลี่ยน schema ทำลายข้อมูล การเห็นมันถูกธงไว้ก่อนรันจริง คุ้มค่ากับเวลาสามสิบวินาทีที่ใช้ทำ diff
- ได้ migration SQL ตั้งต้นทันที เครื่องมือเสนอคำสั่ง ALTER TABLE ให้ทุกความต่างที่ตรวจพบ เปลี่ยนงานจาก "ไล่สืบหาว่าอะไรเปลี่ยน" เป็นแค่ "รีวิวแล้วแก้"
- schema ที่ละเอียดอ่อนไม่หลุดออกนอกเครื่อง การ parse เกิดขึ้นในเบราว์เซอร์ทั้งหมด schema ภายในองค์กรหรือ schema ที่อยู่ใต้กฎระเบียบ จึงไม่เคยออกจากเครื่องของคุณ
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| Table diff | ระบุ table ที่มีอยู่แค่ฝั่งเดียวว่าเป็น table ที่เพิ่มเข้ามาหรือถูกลบไป |
| Column diff | ธง column ที่เพิ่มและถูกลบ พร้อมการเปลี่ยน type, การพลิก nullable และการเปลี่ยน default |
| Index diff | เทียบ index ของทุก table ที่มีอยู่ทั้งสองฝั่ง และระบุว่าต้องสร้างหรือลบอะไรบ้าง |
| Rename detection | จับคู่ column ที่หายไปกับ column ที่เพิ่มเข้ามา เพื่อเสนอ rename ที่น่าจะใช่ |
| คำสั่ง ALTER TABLE ที่เสนอให้ | สร้าง migration statement ที่คุณคัดลอก แก้ไข และนำไปรันได้ |
| ประมวลผลในเบราว์เซอร์ | parse และเทียบ DDL ในเครื่องคุณ ไม่มีการอัปโหลด ไม่ต้องสมัครสมาชิก |
- ใช้กับ dump ไฟล์ได้เลย ไม่จำเป็นต้องมีไฟล์ DDL ที่สมบูรณ์แบบ ผลลัพธ์จาก mysqldump, SHOW CREATE TABLE หรือ export ที่ก๊อปมาแปะ แยกวิเคราะห์ได้หมด
- rename hint เป็นข้อเสนอ ไม่ใช่คำตัดสิน เมื่อ column หายไปหนึ่งตัวและมีตัวคล้ายกันโผล่มาแทน เครื่องมือจะจับคู่ให้ เพื่อให้คุณยืนยันเจตนาก่อน แทนที่จะปล่อยคำสั่งแบบทำลายทิ้งแล้วสร้างใหม่โดยไม่รู้ตัว
- ผลลัพธ์อ่านเหมือนรายงาน diff ถูกจัดกลุ่มตาม table คุณจึงไล่ดูทีละ table ได้ ไม่ต้องหาเข็มในมหาสมุทรของตัวหนังสือ
วิธีใช้งาน SQL Schema Diff
- วาง schema A ใส่ baseline ของคุณ ไม่ว่าจะเป็น schema ปัจจุบันบน production, dump ไฟล์เก่า หรือ DDL รุ่นล่าสุดที่ release ไปแล้ว ลงในช่องแรก
- วาง schema B ใส่ schema เป้าหมายในช่องที่สอง อาจเป็นผลลัพธ์ migration ใหม่, dump ล่าสุด หรือ DDL ที่กำลังจะ deploy
- อ่านผล diff รายงานจะแสดง table และ column ที่เพิ่มหรือถูกลบ, การเปลี่ยน type, การพลิก nullable, การเปลี่ยน default และความต่างของ index โดยจัดกลุ่มตาม table
- ตรวจ rename hint กับ rename ที่ถูกเสนอทุกจุด ให้ตัดสินว่าเป็นการเปลี่ยนชื่อจริง (ใช้ migration ที่แนะนำได้เลย) หรือเป็นการลบทิ้งแล้วสร้างใหม่จริง ๆ (คงการเปลี่ยนแบบทำลายไว้โดยรู้เท่าทัน)
- คัดลอกคำสั่ง ALTER หยิบ migration SQL ที่แนะนำ ปรับให้เข้ากับ dialect ของฐานข้อมูลและข้อกำหนดการ deploy ของทีม แล้วส่งเข้ากระบวนการรีวิวตามปกติ
สิ่งที่ Schema Diff ต้องจับให้เจอ
Diff ที่น่าเชื่อถือต้องลึกกว่าคำว่า "สองไฟล์ไม่เหมือนกัน" นี่คือสิ่งที่เครื่องมือตรวจ และเหตุผลว่าทำไมแต่ละจุดจึงสำคัญ
การเพิ่มและลบ column การเพิ่ม column มักปลอดภัย คำถามจริงคือต้องมี default หรือต้อง backfill หรือไม่ ส่วนการลบ column คือจุดที่ข้อมูลหายไปตลอดกาล มันจึงต้องถูกชี้ให้เห็นชัดเจน ดัง และเกิดจากความตั้งใจเท่านั้น
Type widening เทียบกับ narrowing การเปลี่ยน INT เป็น BIGINT หรือ VARCHAR(50) เป็น VARCHAR(255) คือการขยาย (widening) แทบปลอดภัยเสมอ แม้บาง engine จะต้องเขียน table ใหม่ทั้งตัว ทว่าทิศตรงข้าม — BIGINT เป็น INT หรือ VARCHAR(255) เป็น VARCHAR(50) — คือการหด (narrowing) ที่อาจ fail ทันที หรือตัดค่าทิ้งแบบเงียบ ๆ ทั้งสองกรณีถูกนับเป็น "type change" เหมือนกัน แต่มีเพียงทิศทางเท่านั้นที่บอกความเสี่ยงที่แท้จริง
การพลิก nullable และความเสี่ยงด้าน migration การทำ column ให้เป็น nullable ง่ายนิดเดียว แต่การทำ column nullable ให้กลายเป็น NOT NULL คือหนึ่งในการเปลี่ยนแปลงประจำวันที่อันตรายที่สุดใน SQL มันจะ fail ทันทีที่มีแม้แต่แถวเดียวที่มีค่า NULL และบน table ใหญ่ยังอาจบล็อกการเขียนข้อมูลตลอดระยะเวลาที่รัน diff จะดึงพวกนี้ขึ้นมาให้เห็น เพื่อให้คุณวางแผนแก้แบบสองขั้น: backfill ข้อมูลก่อน แล้วค่อยใส่ constraint
การเปลี่ยน default default ที่ถูกเปลี่ยนจะกระทบทุก insert ในอนาคต ขณะที่แถวเก่ายังคงเก็บค่าเดิมไว้ โค้ดที่สมมติว่า default เป็นค่าเดิมอาจทำงานผิดพลาดตามไปด้วย การแก้เล็ก ๆ แบบนี้จึงสมควรมีบรรทัดของตัวเองในรายงาน
Index diff index ที่หายไปคือสาเหตุคลาสสิกของ release ที่ผ่าน staging มาได้ แต่ล้มเมื่อเจอ traffic จริง การเทียบ index ทั้งสองฝั่งจับได้ทั้ง index ที่มีใน DDL ของ dev แต่ไม่เคยถูกสร้างบน production และกรณีตรงข้ามด้วย
Rename detection ทำงานอย่างไร diff แบบง่าย ๆ จะรายงาน rename ว่าเป็น column หนึ่งตัวถูกลบ อีกหนึ่งตัวถูกเพิ่ม ซึ่งถูกตามตัวอักษรแต่ไร้ประโยชน์ในทางปฏิบัติ เครื่องมือมองหาคู่ที่น่าจะใช่ — type เดียวกัน nullability เดียวกัน ชื่อใกล้เคียงกัน — แล้วเสนอ migration แบบ rename แทน และเพราะฮิวริสติกย่อมพลาดได้ ทุก hint จึงยังคงเป็นเพียงข้อเสนอให้คุณยืนยัน
ทำไมคำสั่ง ALTER ที่เสนอต้องมีคนรีวิว statement ที่สร้างให้คือโครงตั้งต้น ไม่ใช่ migration สำเร็จรูป เครื่องมือรู้ไม่ได้ว่า dialect ของคุณล็อกอะไรบ้าง ข้อมูลเดิมผ่าน constraint NOT NULL ใหม่หรือเปล่า query backfill ที่ถูกต้องคืออะไร หรือการเปลี่ยนแปลงที่พึ่งพากันควรรันตามลำดับไหน รีวิวทีละคำสั่ง ปรับให้เข้ากับบริบท แล้วทดสอบก่อนแตะฐานข้อมูลจริงเสมอ
กรณีการใช้งานจริง
ตรวจจับ drift ระหว่าง dev กับ production
Dump schema จาก production วางเป็น schema A แล้ววาง migration เป้าหมายเป็น schema B คุณจะเห็นชัดว่าการ deploy ครั้งนี้จะเปลี่ยนอะไร สิ่งที่โผล่มาโดยไม่คาดคิด — column ที่โดนลบ, type ที่แคบลง — คือปัญหาที่คุณเจอก่อนที่มันจะเจอคุณ
รีวิว migration จาก ORM ก่อน merge
ORM บางครั้งสร้างสิ่งที่ผิด: ลบทั้งที่ควร rename หรือใช้ type ที่ DBA ไม่มีทางอนุมัติ export DDL ก่อนและหลัง นำมา diff แล้วอ่านรายงานเป็นส่วนหนึ่งของ pull request ไปเลย
เทียบ dump ไฟล์ก่อน release
เก็บ dump จาก staging และ production ก่อนวัน release หนึ่งวัน แล้วนำมา diff รายงานจะกลายเป็น checklist: รัน ALTER ชุดนี้แล้วสอง environment จะเท่ากัน และมันยังใช้เป็นเอกสารว่าระหว่าง release มีอะไรเปลี่ยนไปบ้างอีกด้วย
วางแผนอัปเกรดฐานข้อมูล
กำลังย้ายเวอร์ชันฐานข้อมูลหรือรวม schema หลายตัวเข้าด้วยกัน? diff DDL เก่ากับใหม่เพื่อทำบัญชี type change, object ที่ถูกลบ และ index ที่ต่างกันทั้งหมด แล้วเปลี่ยนคำแนะนำที่ได้ให้กลายเป็นแผน migration แบบเป็นขั้นตอน
แนวปฏิบัติที่ดี
- Diff ก่อนทุกครั้งที่ทำ migration ให้ before/after diff เป็นส่วนหนึ่งของนิยามคำว่า "เสร็จ" สำหรับการเปลี่ยน schema ทุกครั้ง ไม่ใช่สิ่งที่ทำเฉพาะตอนมีปัญหาขึ้นมาแล้ว
- รีวิว type ที่แคบลงสองรอบ BIGINT เป็น INT หรือ VARCHAR(255) เป็น VARCHAR(50) ทำลายข้อมูลได้ ยืนยันก่อนว่า column นั้นไม่มีค่าที่ใหญ่กว่านั้นจริง ๆ แล้วจึงกดอนุมัติ
- สำรองข้อมูลก่อนรัน snapshot หรือ dump ฐานข้อมูลเป้าหมายไว้ก่อนรัน ALTER ทุกครั้ง แผน rollback ที่มีอยู่จริงในมือ ชนะแผนที่แค่อยากให้มีเสมอ
- ทดสอบ ALTER บนสำเนาก่อน รันคำสั่งที่ได้กับ staging clone ที่มีปริมาณข้อมูลใกล้เคียงของจริง แล้วสังเกตเวลาที่ใช้, lock และ query ที่เกี่ยวข้อง
- ใส่ใจลำดับการรัน เพิ่ม column และ index ก่อนโค้ดที่พึ่งพามันขึ้นของ แล้วค่อยลบทิ้งเมื่อไม่เหลือใครใช้แล้วเท่านั้น
- Diff ซ้ำหลังรันเสร็จ เทียบ schema บนระบบจริงกับเป้าหมายอีกครั้ง เพื่อยืนยันว่าความจริงตรงกับแผนแล้ว โดยไม่มีเรื่องน่าประหลาดใจหลงเหลืออยู่
พร้อมดูแล้วหรือยังว่าระหว่างสอง schema ของคุณมีอะไรเปลี่ยนไปบ้าง เปิด SQL Schema Diff วาง DDL ของคุณลงไป แล้วรับรายงานฉบับเต็มพร้อมคำสั่ง ALTER TABLE ภายในไม่กี่วินาที — ฟรี เป็นส่วนตัว และทำงานในเบราว์เซอร์ทั้งหมด
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- SQL Schema Visualizer — เปลี่ยน CREATE TABLE script ให้เป็นแผนภาพตารางและความสัมพันธ์ของฐานข้อมูลแบบอินเทอร์แอกทีฟ
- SQL Formatter — จัดระเบียบ DDL และ query ที่รกให้อ่านง่าย เพื่อให้ diff อ่านสบายและการรีวิวไม่ทรมาน
- OpenAPI Diff — ใช้วินัยแบบเดียวกันกับ API contract ของคุณ โดยเทียบ OpenAPI spec สองฉบับ
ขอให้สนุกกับการเทียบ schema!
คำถามที่พบบ่อย
ถ: ข้อมูล schema ของฉันถูกส่งขึ้นเซิร์ฟเวอร์หรือไม่? ตอบ: ไม่ SQL Schema Diff แยกวิเคราะห์และเทียบ DDL ของคุณในเบราว์เซอร์ทั้งหมด ไม่มีการส่ง เก็บ หรือบันทึกข้อมูลใด ๆ จึงปลอดภัยแม้กับ schema ภายในองค์กรหรือ schema ที่เป็นความลับของลูกค้า
ถ: รองรับ database dialect แบบไหนบ้าง? ตอบ: เครื่องมือ parse CREATE TABLE DDL มาตรฐาน ซึ่งครอบคลุม syntax ของ MySQL, PostgreSQL และฐานข้อมูลเชิงสัมพันธ์ที่คล้ายกัน รวมถึงรับผลลัพธ์อย่าง mysqldump หรือ SHOW CREATE TABLE เป็น input ได้ด้วย
ถ: Rename detection ตัดสินอย่างไรว่าสอง column คือการเปลี่ยนชื่อ? ตอบ: เมื่อ column มีอยู่แค่ฝั่งเดียว เครื่องมือจะมองหาคู่ในอีกฝั่งที่มี type และ nullability เดียวกันและชื่อใกล้เคียงกัน คู่ที่มั่นใจสูงจะถูกนำเสนอเป็น rename ที่เป็นไปได้ พร้อม migration ที่แนะนำ แต่การตัดสินใจสุดท้ายเป็นของคุณเสมอ
ถ: เอาคำสั่ง ALTER ที่ได้ไปรันบน production ได้เลยไหม? ตอบ: ไม่แนะนำ ให้ถือว่าคำแนะนำเหล่านี้เป็นจุดตั้งต้นที่ต้องรีวิว: เช็ก dialect, ตรวจข้อมูลเดิมก่อนพลิกเป็น NOT NULL, ระวังพฤติกรรม lock บน table ใหญ่ และทดสอบบนสำเนาพร้อมสำรองข้อมูลก่อนเสมอ