T-Test Calculator: แยกความต่างที่แท้จริงออกจากความบังเอิญ
รัน one-sample, independent two-sample (Welch) และ paired t-test ได้ฟรีในเบราว์เซอร์ พร้อมสรุป t statistic, p-value, degrees of freedom, effect size และช่วงความเชื่อมั่น 95% ในไม่กี่วินาที
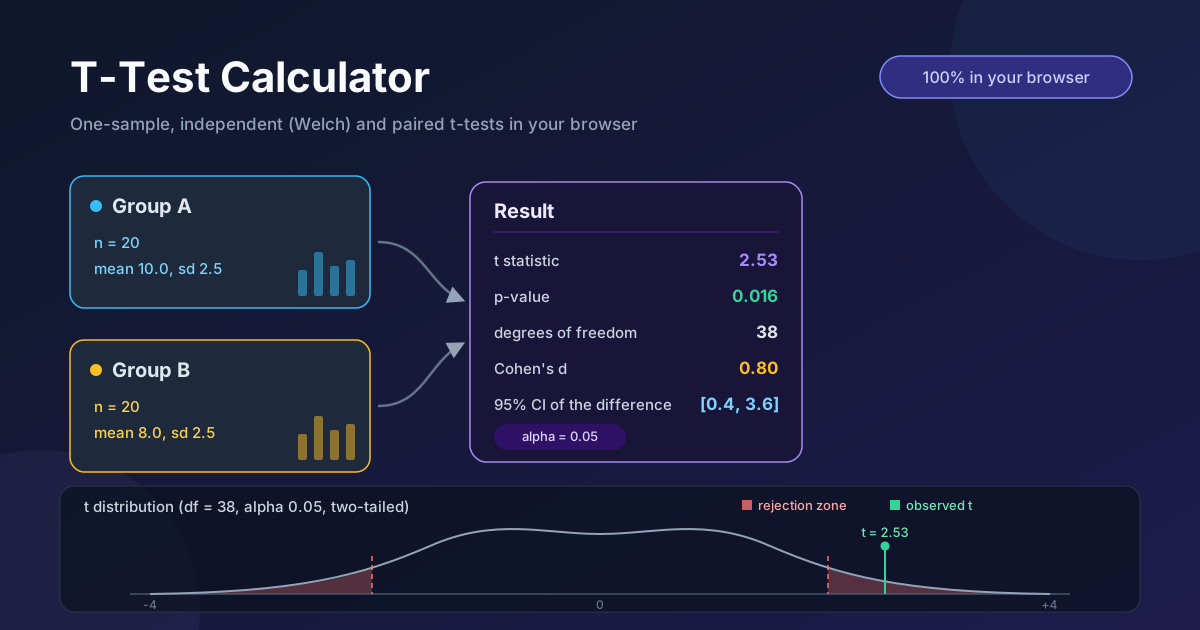
Table of Contents
T-Test Calculator: แยกความต่างที่แท้จริงออกจากความบังเอิญ
ทีมของคุณเพิ่งทำการทดลองเสร็จ: เวอร์ชัน B ของหน้า checkout ทำยอดขายเฉลี่ยต่อออเดอร์ได้ 42.80 ส่วนเวอร์ชัน A อยู่ที่ 40.10 ดูไปก็เหมือนเป็นฝ่ายชนะ แต่ชนะจริง หรือเป็นแค่ความบังเอิญของกลุ่มตัวอย่างที่เข้าข่ายมาแบบนั้น? สัญชาตญาณของคนเราตัดสินโจทย์แบบนี้ได้แย่มาก และนั่นคือเหตุผลที่ t-test ถูกคิดค้นขึ้น — มันชั่งน้ำหนักของความต่างที่เห็นเทียบกับสัญญาณรบกวนในข้อมูล แล้วบอกเราว่าถ้าความต่างนี้ไม่มีจริง โอกาสที่จะเห็นผลแบบนี้มีมากน้อยแค่ไหน
T-Test Calculator ให้คำตอบมาตรฐานทางสถิติได้ภายในไม่กี่วินาที โดยทำงานในเบราว์เซอร์ล้วน ๆ เครื่องมือรองรับสามแบบที่ใช้บ่อยที่สุด คือ one-sample t-test, independent two-sample t-test แบบ Welch correction และ paired t-test พร้อมสรุปผลเป็น t statistic, p-value, degrees of freedom, Cohen's d และช่วงความเชื่อมั่น 95% (95% confidence interval) เนื่องจากทุกการคำนวณเกิดขึ้นบนเครื่องของคุณ ข้อมูลที่อ่อนไหวจึงไม่มีทางถูกส่งออกไปไหน
บทความนี้จะพาไปดูว่าแต่ละแบบเหมาะกับสถานการณ์ไหน อ่านตัวเลขที่เครื่องมือรายงานอย่างไร และนิสัยการทำงานแบบไหนที่ทำให้ข้อสรุปจาก t-test น่าเชื่อถือ ถ้าคุณวางตัวเลขลงกล่องข้อความได้ คุณก็รันการทดสอบที่ถูกต้องได้
ทำไมต้องใช้ T Test Calculator?
- ไม่ต้องติดตั้ง ไม่ต้องสมัครสมาชิก — เปิดในเบราว์เซอร์รุ่นใหม่ได้เลย ฟรีและไม่จำกัดจำนวนครั้ง
- ครบทั้งสามแบบในที่เดียว — one-sample, independent two-sample (Welch) และ paired เลือกสลับกันคลิกเดียว ไม่ต้องจำสูตรว่าแบบไหนใช้กับสถานการณ์ไหน
- ได้ effect size ไม่ใช่แค่ความมีนัยสำคัญ — นอกจาก p-value ยังได้ Cohen's d และช่วงความเชื่อมั่น 95% ช่วยแยกให้เห็นว่าความต่างแบบไหนใหญ่และมั่นคง กับแบบไหนเล็กและใกล้เคียงกันมาก
- ข้อมูลไม่ออกจากเครื่อง — ประมวลผลฝั่ง client 100% ปลอดภัยกับข้อมูลแล็บ ตัวเลขสินค้าที่ยังไม่เปิดตัว และข้อมูลนักเรียน
- วางข้อมูลได้ยืดหยุ่น — คั่นค่าด้วยช่องว่าง คอมมา หรือการขึ้นบรรทัดใหม่ก็ได้ หากมี token ที่อ่านไม่ได้เครื่องมือจะแจ้งเตือนแทนที่จะเงียบ ๆ คำนวณจากข้อมูลที่หายไป
- ปรับระดับนัยสำคัญได้ — เลือก alpha เป็น 0.01, 0.05 หรือ 0.1 ตามความเข้มงวดที่สาขาหรือรายวิชาของคุณกำหนด
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไรได้ |
|---|---|
| สามแบบการทดสอบ | เทียบค่าเฉลี่ยกับค่าที่รู้แล้ว, two-sample แบบ Welch correction และแบบ paired ก่อน-หลัง |
| ผลลัพธ์ครบชุด | t statistic, p-value สองทาง, degrees of freedom, Cohen's d และช่วงความเชื่อมั่น 95% |
| ระดับนัยสำคัญ | เลือก alpha 0.01, 0.05 หรือ 0.1 ตามเกณฑ์การตัดสินใจของคุณ |
| คำนวณฝั่ง client | ทุกตัวเลขคำนวณในเบราว์เซอร์ ไม่มีการอัปโหลด ไม่ต้องสมัครบัญชี |
| รับข้อมูลยืดหยุ่น | รองรับตัวคั่นแบบผสม และไฮไลต์ token ที่อ่านไม่ได้ก่อนคำนวณ |
มีสองจุดที่น่าสนใจเป็นพิเศษ ประการแรก โหมด two-sample ใช้ Welch correction เป็นค่าเริ่มต้น ความแปรปรวนที่ไม่เท่ากันและขนาดกลุ่มที่ไม่เท่ากันจึงไม่บิดเบือน p-value ของคุณอย่างเงียบ ๆ ประการที่สอง ช่วงความเชื่อมั่นถูกคำนวณจากข้อมูลเดียวกันในรอบเดียว เรื่องขนาดของผลและเรื่องความมีนัยสำคัญจึงสอดคล้องกันเสมอ
วิธีใช้งาน
- เปิดเครื่องมือแล้วเลือกชนิดการทดสอบ — เลือก one-sample เมื่อจะเทียบค่าเฉลี่ยของกลุ่มกับค่าเป้าหมายที่รู้แล้ว, independent two-sample เมื่อมีสองกลุ่มที่ไม่เกี่ยวข้องกัน หรือ paired เมื่อการวัดแต่ละครั้งมีคู่ที่สัมพันธ์กันตามธรรมชาติ
- วางข้อมูลของแต่ละกลุ่ม — ใส่ค่าโดยคั่นด้วยช่องว่าง คอมมา หรือขึ้นบรรทัดใหม่ สำหรับแบบ paired ให้คงลำดับแถวให้ตรงกัน เพื่อให้คู่ก่อน-หลังจับคู่กันถูกต้อง
- ตั้งค่าอ้างอิงถ้าเลือก one-sample — เช่น สายผลิตที่ปรับเกณฑ์ไว้ 250 มิลลิลิตร ก็กรอก 250 เป็นค่าที่ใช้ทดสอบ
- เลือกระดับนัยสำคัญ — ค่าเริ่มต้น 0.05 เหมาะกับงานส่วนใหญ่ ถ้าข้อสรุปที่ผิดมีราคาแพงให้เข้มขึ้นเป็น 0.01
- อ่านแผงผลลัพธ์ — คุณจะได้ t statistic, p-value, degrees of freedom, Cohen's d และช่วงความเชื่อมั่น 95% พร้อมข้อสรุปภาษาง่าย ๆ ว่าความต่างผ่านเกณฑ์ที่ตั้งไว้หรือไม่
เลือก t-test แบบไหน และอ่านผลลัพธ์อย่างไร
สามแบบ ใช้เมื่อไหร่
one-sample t-test เปรียบเทียบค่าเฉลี่ยของกลุ่มเดียวกับค่าอ้างอิงคงที่ เช่น เครื่องจ่ายนี้จ่ายน้ำจริง 500 มิลลิลิตรต่อขวดหรือไม่ หรือล็อตนี้ต่างจากค่ามาตรฐานที่เผยแพร่ไหม independent two-sample t-test เทียบค่าเฉลี่ยของสองกลุ่มที่ไม่เกี่ยวข้องกัน เช่น กลุ่มควบคุมกับกลุ่มทดลอง เครื่องมือใช้เวอร์ชันของ Welch ที่ไม่ถือสมมติฐานว่าสองกลุ่มมีความแปรปรวนเท่ากัน ซึ่งเป็นค่าเริ่มต้นที่ปลอดภัยที่สุดสำหรับข้อมูลจริง ส่วน paired t-test ใช้กับงานแบบก่อน-หลัง คือคน เครื่อง หรือตัวอย่างชุดเดียวกันถูกวัดสองรอบ โดยการวัดแต่ละคู่จะถูกลบกันก่อนวิเคราะห์ การจับคู่ช่วยตัดสัญญาณรบกวนระหว่างบุคคลออกไป และมักให้พลังทางสถิติสูงกว่าการเทียบแบบไม่จับคู่มาก
อ่าน t, p-value และ degrees of freedom
t statistic คืออัตราส่วนสัญญาณต่อสัญญาณรบกวน นั่นคือความต่างที่เห็นหารด้วย standard error ของมัน ยิ่งค่าสัมบูรณ์ของ t ใหญ่ ความต่างยิ่งใหญ่เมื่อเทียบกับความสั่นไหวของข้อมูล p-value ตอบคำถามเดียว คือถ้าจริง ๆ แล้วไม่มีความต่างเลย การสุ่มตัวอย่างจะให้ความต่างใหญ่อย่างน้อยเท่าที่เห็นบ่อยแค่ไหน ถ้า p-value ต่ำกว่า alpha ที่ตั้งไว้ (มักเป็น 0.05) เราจะเรียกตามธรรมเนียมว่ามีนัยสำคัญทางสถิติ degrees of freedom (df) บอกปริมาณข้อมูลที่ตัวอย่างพามา df น้อยหมายถึงหางการแจกแจงอ้วน ค่า t เท่าเดิมจึงให้ p-value ใหญ่กว่าเมื่อกลุ่มตัวอย่างเล็กกว่า
Cohen's d: effect size ใหญ่แค่ไหน
Cohen's d แปลงความต่างให้เป็นหน่วยของส่วนเบี่ยงเบนมาตรฐาน ทำให้เทียบผลข้ามงานวิจัยและข้ามหน่วยวัดได้ เกณฑ์คลาสสิกคือ 0.2 เล็ก, 0.5 กลาง และ 0.8 ใหญ่ จุดนี้สำคัญเพราะความมีนัยสำคัญกับความสำคัญไม่ใช่เรื่องเดียวกัน กลุ่มตัวอย่างใหญ่มากอาจทำให้ความต่างจิ๋วได้ p-value เล็กมาก ขณะที่ผลที่สำคัญจริงในงานนำร่องขนาดเล็กอาจไม่ถึงเกณฑ์ความมีนัยสำคัญเลย จึงควรอ่าน d คู่กับ p เสมอ
ช่วงความเชื่อมั่น กับ p-value ต่างกันอย่างไร
ช่วงความเชื่อมั่น 95% บอกช่วงค่าที่ข้อมูลมองว่าเป็นไปได้สำหรับความต่างที่แท้จริง ถ้าช่วงกางคร่อมศูนย์ แปลว่าข้อมูลของคุณไม่สามารถตัดความเป็นไปได้ของ "ไม่มีความต่าง" ออกที่ระดับ 5% นอกจากคำตอบแบบใช่-ไม่แล้ว ช่วงนี้ยังบอกทั้งขนาดและความแม่นยำ ช่วง [0.4, 3.6] บอกว่าผลน่าจะมีความหมาย แต่ช่วง [-0.1, 30.0] บอกว่าการทดลองมีสัญญาณรบกวนมากเกินกว่าจะสรุปอะไรได้
ตัวอย่างพร้อมคำนวณ
สมมติว่าเครื่องชงกาแฟถูกปรับเกณฑ์ไว้จ่าย 250 มิลลิลิตรต่อแก้ว คุณสุ่มแก้วมาแปดแก้วได้ค่า 248, 251, 247, 250, 246, 252, 249 และ 253 ค่าเฉลี่ยตัวอย่างคือ 249.5 ส่วนเบี่ยงเบนมาตรฐานราว 2.45 เมื่อใส่ค่าเหล่านี้พร้อมค่าอ้างอิง 250 ในโหมด one-sample จะได้ t = -0.58, df = 7, p = 0.58, Cohen's d = 0.20 และช่วงความเชื่อมั่น 95% คือ [247.5, 251.5] ช่วงนี้ครอบคลุมค่า 250 สบาย ๆ แม้ขอบที่แย่ที่สุดก็เพี้ยนไปราว 2.5 มิลลิลิตรเท่านั้น เป็นหลักฐานชัดว่าไม่มีการจ่ายเกินหรือขาดที่มีความหมาย ไม่ใช่เครื่องที่ทำงานแย่ลง
สำหรับตัวอย่างแบบ two-sample ให้แต่ละกลุ่มมีการวัดยี่สิบครั้ง ค่าเฉลี่ย 10.0 กับ 8.0 และส่วนเบี่ยงเบนมาตรฐานเท่ากันที่ 2.5 การทดสอบแบบ Welch จะให้ t = 2.53 ที่ df = 38, p = 0.016, Cohen's d = 0.80 และช่วงความเชื่อมั่น 95% คือ [0.4, 3.6] ที่นี่ความต่างทั้งมีนัยสำคัญทางสถิติและใหญ่ระดับใหญ่ตามเกณฑ์ของ Cohen
ข้อสมมติที่ต้องมองก่อน
t-test ถือว่าข้อมูลเป็นอิสระจากกัน และข้อมูล — หรือผลต่างรายคู่ในกรณีแบบ paired — มีรูปร่างใกล้เครื่องหมายประมาณนี้คือ ใกล้การแจกแจงปกติ ความเบ้ปานกลางเมื่อมีข้อมูลตั้งแต่ยี่สิบค่าขึ้นไปต่อกลุ่มมักไม่ใช่ปัญหา แต่ข้อมูลที่เบ้มาก มีค่าผิดปกติสุดขั้ว หรือเป็นข้อมูลนับและสัดส่วน ควรใช้วิธีอื่น การลากฮิสโตแกรมดูก่อนทดสอบคือประกันที่ถูกที่สุดเท่าที่ซื้อได้
กรณีใช้งานจริง
ตรวจยืนยันผล A/B test ให้เกินแค่การคำนวณ sample size
การวางแผนด้วย Sample Size Calculator บอกได้ว่าต้องมีผู้เข้าชมกี่คน แต่เมื่อการทดลองจบลงคุณยังต้องวิเคราะห์มัน สำหรับผลลัพธ์แบบต่อเนื่อง เช่น รายได้ต่อผู้เข้าชม หรือเวลาที่อยู่ในหน้า two-sample t-test แบบ Welch คือเครื่องมือมาตรฐาน และมันจะเปลี่ยนช่องว่างดิบ ๆ ให้เป็นข้อสรุปที่ป้องกันตัวได้
งานวิจัยก่อน-หลังการอบรม
หน่วยงานวัดคะแนนผลิตภาพของพนักงานก่อนและหลังอบรม เพราะวัดคนชุดเดียวกันสองรอบ paired t-test จึงเป็นตัวเลือกที่ถูกต้อง มันควบคุมเรื่องที่ว่าบางคนเก่งอยู่แล้วตั้งแต่ต้น ทำให้เห็นเฉพาะการเปลี่ยนแปลงที่หลักสูตรสร้างขึ้นจริง
เทียบการวัดจากห้องแล็บหรือเครื่องมือ
ห้องปฏิบัติการคุณภาพใช้ one-sample t-test ตรวจว่าล็อตสินค้าตรงกับค่ามาตรฐานอ้างอิงที่รับรองไว้หรือไม่ และใช้ two-sample เทียบเครื่องมือสองชิ้นหรือช่างสองคนที่วัสดุชุดเดียวกัน ทั้งหมดเสร็จเร็วกว่าการเปิดอ่านเอกสารขั้นตอนอีกรอบ
ตรวจการบ้านและงานในห้องเรียน
นักเรียนสถิติใช้ตรวจค่า t statistic และ p-value ที่คำนวณด้วยมือทีละขั้น ผู้สอนก็ออกแบบแบบฝึกหัดให้เห็นว่าเปลี่ยนข้อมูลจุดเดียวแล้ว t, df และช่วงความเชื่อมั่นขยับอย่างไร ส่วนผลลัพธ์แบบแบ่งหมวดหมู่เช่น ผ่าน-ไม่ผ่าน ให้คู่กับ Chi-Square Calculator แทน
แนวปฏิบัติที่ดี
- ตรวจข้อสมมติก่อนเชื่อผลลัพธ์ — กวาดตาดูความใกล้เคียงการแจกแจงปกติและค่าผิดปกติ Statistics Calculator คำนวณค่าเฉลี่ย ส่วนเบี่ยงเบนมาตรฐาน และสรุปอื่น ๆ ในเบราว์เซอร์เดียวกัน
- รายงาน effect size ไม่ใช่แค่ p-value — อ้าง Cohen's d และช่วงความเชื่อมั่นประกอบ เพื่อให้ผู้อ่านตัดสินความสำคัญเชิงปฏิบัติได้ ไม่ใช่เห็นแค่ความมีนัยสำคัญทางสถิติ
- วางแผนขนาดกลุ่มตัวอย่างก่อน — กำหนดจำนวนข้อมูลที่ต้องใช้ด้วย Sample Size Calculator ก่อนเก็บข้อมูล เพราะการทดสอบที่พลังต่ำจะเสียเปล่าไม่ว่าผลจะออกมาอย่างไร
- ถ้ามีการจับคู่ให้ใช้แบบ paired — การวัดก่อน-หลังที่จับคู่กันตัดแหล่งสัญญาณรบกวนก้อนใหญ่ออกไปได้ฟรี ๆ
- ตั้ง alpha และสมมติฐานไว้ก่อนดูข้อมูล — การรันทดสอบซ้ำจนกว่าอะไรจะออกมามีนัยสำคัญ คือทางลัดที่เร็วที่สุดสู่การเผยแพร่ความบังเอิญ
- เลือกวิธีทดสอบให้ตรงชนิดข้อมูล — t-test เทียบค่าเฉลี่ยของข้อมูลต่อเนื่องที่ใกล้การแจกแจงปกติ ถ้าเป็นการนับหรือสัดส่วนหมวดหมู่ ให้ใช้ Chi-Square Calculator
เริ่มทดสอบผลต่างแรกของคุณภายในหนึ่งนาที
เปิด T-Test Calculator วางรายการตัวเลขสั้น ๆ สองชุด แล้วอ่านข้อสรุป ทั้ง t statistic, p-value, effect size และช่วงความเชื่อมั่น คำนวณทั้งหมดบนเครื่องของคุณเอง ครั้งหน้าที่ใครถามว่า "ความต่างนี้จริงหรือเปล่า?" คุณจะมีคำตอบมาตรฐานทางสถิติพร้อมเสิร์ฟก่อนประชุมจบ
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Sample Size Calculator — คำนวณว่าแต่ละกลุ่มต้องมีข้อมูลกี่ค่าก่อนเริ่มเก็บจริง
- Statistics Calculator — สำรวจค่าเฉลี่ย มัธยฐาน ส่วนเบี่ยงเบนมาตรฐาน และสรุปเชิงพรรณนาอื่น ๆ
- Chi-Square Calculator — ทดสอบความสัมพันธ์ระหว่างผลลัพธ์แบบหมวดหมู่ เช่น ผ่านกับไม่ผ่าน
ขอให้สนุกกับการวิเคราะห์ข้อมูล และขอให้ p-value เล็กกว่า alpha ทุกครั้งครับ
คำถามที่พบบ่อย
ถ: ควรใช้ t-test เมื่อไหร่ แทน z-test?
ตอบ: ใช้ t-test เมื่อไม่รู้ส่วนเบี่ยงเบนมาตรฐานของประชากร ซึ่งเกิดขึ้นเกือบตลอดกับข้อมูลจริง t-test ชดเชยความไม่แน่นอนที่เพิ่มมาจากการประมาณความกระจายจากตัวอย่างเอง และจะเข้าใกล้ z-test เมื่อขนาดกลุ่มตัวอย่างใหญ่ขึ้น
ถ: p-value เท่ากับ 0.03 แปลว่าอะไรกันแน่?
ตอบ: ถ้าจริง ๆ แล้วไม่มีความต่างระหว่างสองกลุ่มเลย การสุ่มตัวอย่างเพียงอย่างเดียวจะให้ความต่างใหญ่อย่างน้อยเท่าที่คุณเห็นประมาณ 3% ของครั้ง มันไม่ได้แปลว่าสมมติฐานว่างมีโอกาสถูก 3% และไม่ได้แปลว่า effect นั้นใหญ่ด้วย
ถ: ระหว่าง Welch กับ Student's t-test ควรเลือกแบบไหน?
ตอบ: Student's t-test แบบคลาสสิกถือว่าทั้งสองกลุ่มมีความแปรปรวนเท่ากัน เวอร์ชันของ Welch ตัดสมมติฐานนี้ออกและเป็นค่าเริ่มต้นที่ปลอดภัยกว่า โดยเฉพาะเมื่อขนาดกลุ่มไม่เท่ากัน ถ้าความแปรปรวนเท่ากันจริง สองแบบจะให้คำตอบใกล้เคียงกันมาก จึงแทบไม่เสียอะไรเลยที่ใช้ Welch
ถ: เครื่องมืออัปโหลดข้อมูลของฉันขึ้นเซิร์ฟเวอร์ไหม?
ตอบ: ไม่ การคำนวณทั้งหมดทำงานในเบราว์เซอร์ของคุณด้วย JavaScript ไม่มีค่า ผลลัพธ์ หรือตัวระบุใดถูกส่งไปที่ใด คุณแม้จะตัดอินเทอร์เน็ตหลังโหลดหน้าเสร็จก็ยังทดสอบต่อได้