Text Similarity Checker: เปรียบเทียบข้อความสองชุดด้วย Levenshtein Jaccard และ Cosine Similarity
เปรียบเทียบข้อความสองชุดด้วย Text Similarity Checker ที่ให้คะแนน Levenshtein Jaccard และ cosine similarity พร้อม word diff ระดับคำ คำนวณทั้งหมดในเบราว์เซอร์ของคุณ
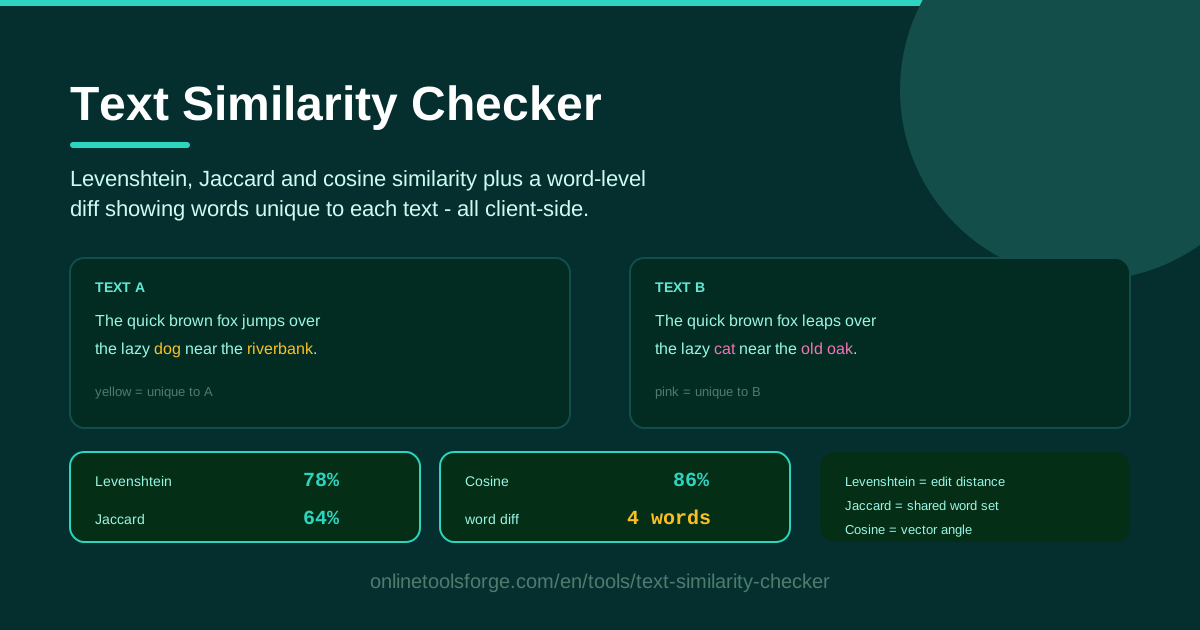
Table of Contents
นักเขียน บรรณาธิการ นักการตลาด และครูผู้สอน ต่างต้องเจอคำถามเดียวกันสักครั้งในชีวิต: ข้อความสองชุดนี้เหมือนกันแค่ไหนกันแน่? การอ่านเทียบกันด้วยตาเปล่ามักไม่ช่วยตัดสินเท่าไร เพราะสายตามนุษย์ให้อภัยการเขียนใหม่ มองข้ามคำที่ถูกสลับ และเริ่มงงตั้งแต่หลังย่อหน้าที่สอง Text Similarity Checker เปลี่ยนการเดาให้กลายเป็นตัวเลขที่วัดได้ เปรียบเทียบข้อความสองชุดให้เสร็จภายในไม่กี่วินาที
เครื่องมือนี้ให้คะแนนสามแบบพร้อมกันในหน้าจอเดียว ได้แก่ Levenshtein similarity ที่นับการเปลี่ยนแปลงระดับตัวอักษร, Jaccard similarity ที่วัดความทับซ้อนของชุดคำสองชุด และ cosine similarity ที่ดูความสอดคล้องโดยรวมเมื่อมองข้อความเป็นเวกเตอร์ นอกจากค่าเปอร์เซ็นต์แล้ว ยังมี word diff ระดับคำที่ไฮไลต์ทุกคำที่ปรากฏเฉพาะในข้อความฝั่งใดฝั่งหนึ่ง ทำให้คุณเห็นไม่ใช่แค่ว่าเหมือนกันกี่เปอร์เซ็นต์ แต่เห็นด้วยว่าสองเวอร์ชันต่างกันตรงคำไหนบ้าง
ทุกการคำนวณทำงานแบบ client-side ในเบราว์เซอร์ของคุณล้วน ๆ ไม่มีการอัปโหลด เก็บ หรือบันทึกข้อความใด ๆ ขึ้นเซิร์ฟเวอร์ จึงปลอดภัยแม้กับงานลับ งานลูกค้า และเอกสารที่ยังไม่เผยแพร่ บทความนี้จะพาไปดูวิธีใช้งานทีละขั้น ความหมายของแต่ละคะแนน ตัวอย่างการใช้งานจริง และวิธีอ่านตัวเลขเมื่อสามค่านี้ไม่เห็นพ้องกัน
ทำไมต้องใช้ Text Similarity Checker?
- ได้สามมาตรวัดในหน้าจอเดียว Levenshtein, Jaccard และ cosine ตอบคำถามเรื่อง similarity คนละมุมมอง การเทียบทั้งสามค่าพร้อมกันจึงน่าเชื่อถือกว่าการพึ่งตัวเลขเดียวเสมอ
- มี diff ที่อ่านรู้เรื่อง เปอร์เซ็นต์บอกว่าต่างกันมากแค่ไหน แต่ word diff บอกว่าคำไหนปรากฏเฉพาะฝั่งไหน เปลี่ยนคะแนนนามธรรมให้เป็นรายการการเปลี่ยนแปลงที่จับต้องได้
- เป็นส่วนตัวหนึ่งร้อยเปอร์เซ็นต์ ทุกการคำนวณรันในเบราว์เซอร์ ข้อความของคุณไม่ผ่านเซิร์ฟเวอร์เลย งานที่ยังไม่เปิดเผยจึงยังเป็นของคุณเท่านั้น
- ไม่ต้องสมัครสมาชิก ไม่มีลิมิต เปิดหน้าเว็บ วางข้อความ อ่านผลลัพธ์ จบ ไม่มีบัญชี ไม่มีโควตา ไม่มีการตั้งค่าให้ปวดหัว
- เป็นหลักฐานที่เป็นกลาง ก่อนตั้งคำถามเรื่องการคัดลอกกับเพื่อนร่วมงาน นักเรียน หรือ vendor คุณชี้เปอร์เซ็นต์ที่วัดได้แทนการใช้ความรู้สึกส่วนตัว
- ใช้ได้กับข้อความทุกประเภท คณิตศาสตร์เบื้องหลังทำงานกับตัวอักษรและคำ จึงรองรับบทความ คำอธิบายสินค้า งานแปล และโค้ดได้เท่าเทียมกัน
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| วางข้อความเทียบกันสองฝั่ง | วางข้อความ A และ B ลงสองแผง ผลลัพธ์อัปเดตอัตโนมัติ |
| Levenshtein similarity | แปลง edit distance (แทรก ลบ แทนที่ตัวอักษร) เป็นเปอร์เซ็นต์ |
| Jaccard similarity | เทียบชุดคำสองชุด แล้วรายงานคำศัพท์ที่ทับซ้อนเป็นเปอร์เซ็นต์ |
| Cosine similarity | มองแต่ละข้อความเป็นเวกเตอร์ความถี่ของคำ แล้ววัดมุมระหว่างเวกเตอร์ทั้งสอง |
| Word diff ระดับคำ | ไฮไลต์คำที่ปรากฏเฉพาะในข้อความ A หรือเฉพาะใน B |
| คำนวณแบบ client-side | ทุกการคำนวณรันในเบราว์เซอร์ ไม่มีข้อมูลใดถูกส่งออกไป |
รายละเอียดที่ควรรู้เพิ่มเติม:
- สามค่าเปอร์เซ็นต์คำนวณแยกจากกัน จึงมีทางขยับต่างทิศทางเวลาคุณแก้ข้อความ ซึ่งเป็นสัญญาณสำคัญที่ควรอ่าน ไม่ใช่บั๊ก
- diff ทำงานทั้งคำ ทำให้เห็นคำศัพท์ที่ถูกเปลี่ยน ชื่อสินค้าที่ถูกแก้ หรือคำขยายที่หายไปได้ในชั่วเดียว
- ไม่มี threshold, API key หรือการตั้งค่าให้เรื่องมาก ใส่ข้อความครบสองฝั่งเมื่อไหร่ ผลลัพธ์เต็มรูปแบบมาทันที
วิธีใช้งาน Text Similarity Checker
- เปิดเครื่องมือแล้ววางข้อความชุดแรก ใส่เวอร์ชันอ้างอิง เช่น ต้นฉบับ เอกสารต้นทาง หรือคำอธิบายสินค้าเวอร์ชันเดิม ลงในแผงด้านซ้าย
- วางข้อความชุดที่สองข้าง ๆ วางเวอร์ชันที่ต้องการเทียบลงแผงขวา ระบบจะคำนวณคะแนนอัตโนมัติทันทีที่ทั้งสองแผงมีข้อความ
- อ่านค่าเปอร์เซ็นต์ทั้งสามพร้อมกัน เริ่มจาก Levenshtein เพื่อดูความใกล้เคียงระดับตัวอักษร ตามด้วย Jaccard เรื่องคำศัพท์ทับซ้อน และ cosine เรื่องความสอดคล้องโดยรวม พร้อมสังเกตว่าสามค่าตรงกันหรือแยกจากกัน
- ศึกษา word diff ไล่ดูคำที่ปรากฏเฉพาะฝั่งใดฝั่งหนึ่ง เพราะ 90% ที่มาจากคำขยายสลับกัน กับ 90% ที่ซ่อนราคาหรือเงื่อนไขสำคัญที่ถูกแก้ไป คือเรื่องคนละเรื่องกันสนิท
- ปรับซ้ำจนได้ระดับที่ต้องการ แก้ข้อความ วางกลับเข้าไป แล้วดูคะแนนขยับ ส่วนใหญ่ใช้เพียงสองถึงสามรอบก็เข้าเป้า
สามวิธีวัดความคล้ายคลึง
Levenshtein Edit Distance: นับการเปลี่ยนตัวอักษร
Levenshtein edit distance คือจำนวนครั้งน้อยที่สุดของการกระทำระดับตัวอักษรหนึ่งตัว ไม่ว่าจะแทรก ลบ หรือแทนที่ ที่ใช้เปลี่ยนข้อความหนึ่งเป็นอีกข้อความหนึ่ง เครื่องมือแปลงค่าดิบนี้เป็นเปอร์เซ็นต์ similarity ยิ่งแก้น้อยยิ่งได้คะแนนสูง เพราะทำงานทีละตัวอักษร Levenshtein จึงไวที่สุดในสามตัว พิมพ์ผิดจุดเดียวหรือเลขที่เปลี่ยนไปหนึ่งตัวก็ทำให้คะแนนลดลงเห็นได้ชัด จึงเหมาะเป็นตัวชี้ว่าข้อความนี้ถูกคัดลอกมาอย่างระมัดระวังแค่ไหน
Jaccard Similarity: วัดคำศัพท์ที่ทับซ้อนกัน
Jaccard similarity ไม่สนใจลำดับคำและความถี่ของคำเลย มันสร้างชุดคำที่ไม่ซ้ำของแต่ละข้อความ แล้วหารจำนวนคำที่ทับกันด้วยจำนวนคำรวมทั้งหมด ข้อความสองชุดที่สลับประโยคไปมาแต่ใช้คำชุดเดิมยังได้ 100% ส่วนการเพิ่มย่อหน้าใหม่ที่มีคำศัพท์แปลกใหม่จะดึงคะแนนลงทันที จึงเป็นมาตรวัดที่ตรงไปตรงมาที่สุดเรื่องความทับซ้อนของหัวข้อ และช่วยตอบได้เร็วว่างานเขียนใหม่นั้นเปลี่ยนแค่ถ้อยคำหรือเปลี่ยนทั้งเนื้อหา
Cosine Similarity: มุมระหว่างสองข้อความ
Cosine similarity มองแต่ละข้อความเป็นเวกเตอร์ของความถี่คำ แล้ววัดมุมระหว่างเวกเตอร์ทั้งสอง ข้อความที่การกระจายคำเหมือนกันจะชี้ไปทางเดียวกันและได้คะแนนใกล้ 100% ส่วนข้อความที่ทับคำบางส่วนแต่เน้นคำต่างกันจะอยู่ช่วงกลาง ๆ ต่างจาก Jaccard ตรงที่ cosine สนใจว่าแต่ละคำปรากฏกี่ครั้ง เอกสารที่พูดถึงคำว่า refund ยี่สิบครั้งจึงไม่ดูเหมือนเอกสารที่พูดแค่ครั้งเดียว แนวคิดเดียวกันนี้คือหัวใจของการจัดอันดับผลค้นหาว่า เอกสารที่คล้ายกันมักชี้ไปทิศทางเดียวกัน
เมื่อสามคะแนนไม่เห็นพ้องกัน
ตัวเลขที่แยกจากกันเองก็เป็นข้อมูลที่มีค่า Jaccard สูงแต่ Levenshtein ต่ำมักแปลว่าใช้คำชุดเดิมแต่เรียงใหม่ เช่น งานเขียนใหม่หรือลิสต์ที่ถูกสลับ Levenshtein สูงแต่ cosine ปานกลางมักบอกว่าข้อความหนึ่งยาวกว่าอีกฝั่งมาก เพราะ edit distance ลงโทษทุกตัวอักษรที่เพิ่มเข้ามา ขณะที่ cosine สนใจสัดส่วนเป็นหลัก ส่วน Jaccard ต่ำแต่ cosine สูงมักพบเมื่อสองข้อความทับกันแค่คำเชื่อมที่ใช้บ่อย แต่จริง ๆ คุยคนละเรื่อง เมื่อไหร่ที่คะแนนแยกทางกัน ให้เปิด diff ดูคำจริงก่อนสรุปอะไรทั้งนั้น
ตัวอย่างการใช้งานจริง
ตรวจงานเขียนใหม่ (paraphrase)
ลูกค้าส่ง white paper ของคุณกลับมาพร้อมบอกว่าแก้นิดหน่อยเท่านั้น วางทั้งสองเวอร์ชันลงเครื่องมือ ถ้า Levenshtein ยังสูงและมีคำ unique โผล่ใน diff เพียงไม่กี่คำ แปลว่าการแก้เป็นแค่เชิงผิวเผิน แต่ถ้า Jaccard ลดลงชัดเจน แปลว่ามีทั้งตอนที่เปลี่ยนหัวข้อไปแล้ว ควรดูให้ละเอียดก่อนกดอนุมัติ
เทียบคำอธิบายสินค้าเรื่อง duplication
มาร์เก็ตเพลสและเสิร์ชเอนจินต่างลงโทษคอนเทนต์ที่ซ้ำกัน ลองเทียบคำอธิบายของ supplier กับลิสติ้งของคุณ ถ้า cosine similarity อยู่ช่วงเก้าสิบตอนต้น ๆ และ diff แทบไม่มีคำต่างเลย แปลว่าข้อความเหมือนกันจริงและควรเขียนใหม่ แต่ถ้าคะแนนต่ำกว่านั้นมาก ก็ยืนยันได้ว่าเวอร์ชันของคุณแตกต่างเพียงพอ
รีวิวงานแปลที่ถูกแก้
เมื่อ reviewer ส่งงานแปลกลับมา ให้เทียบเวอร์ชันเดิมกับเวอร์ชันที่แก้แล้ว ก้อนคำ unique ใน diff จะชี้ชัดว่าช่วงไหนถูก rework ไป ทำให้คุณรีวิวเฉพาะจุดที่เปลี่ยนอย่างตั้งใจ แทนที่จะต้องอ่านซ้ำทั้งเอกสารเพื่อตามหาการแก้ไขเอง
ตรวจความคล้ายคลึงก่อนตัดสินเรื่อง plagiarism
เครื่องมือนี้ไม่ใช่เครื่องมือพิสูจน์ plagiarism ระดับนิติเวช แต่เป็น screening รอบแรกที่เร็วมาก ก่อนยกระดับเรื่องงานที่สงสัยว่าลอกมา การเทียบครั้งเดียวให้เปอร์เซ็นต์ที่วัดได้เป็นหลักฐาน และบ่อยครั้ง diff เพียงอย่างเดียวก็ปิดคำถามได้ในไม่กี่วินาที
แนวปฏิบัติที่ดีที่สุด
- ปรับ case ให้เท่ากันก่อนเทียบ เมื่อความต่างของตัวพิมพ์ไม่มีความหมาย เพราะ iPhone กับ iphone ถูกนับเป็นสายอักขระคนละชุดสำหรับ edit distance
- อย่าตัดสินจากคะแนนเดียว ให้อ่านทั้งสามเปอร์เซ็นต์เป็นชุดก่อนตัดสินใจอะไรทุกครั้ง
- ดู diff ก่อนสรุป รายการคำ unique คือคำอธิบายว่าทำไมคะแนนถึงขยับ ข้อความสองชุดอาจได้เปอร์เซ็นต์เท่ากันด้วยเหตุผลคนละเรื่อง
- ระวังข้อความสั้น การเปลี่ยนคำเดียวทำให้คะแนนเด้งแรงมากบนข้อความสั้น จึงควรใช้คะแนนเป็นคำใบ้แล้วอ่านจริงประกอบเสมอ
- เทียบของที่เทียบกันได้ บทสรุปสั้น ๆ เทียบกับรายงานยาว ๆ จะได้คะแนนต่ำเสมอ ควรตัดหรือแบ่งข้อความยาวให้ขนาดใกล้กันก่อน
- รันซ้ำหลังแก้ทุกรอบ similarity เป็นเป้าที่ขยับได้ตลอด การเช็กหลังแก้ทุกครั้งช่วยให้คุณอยู่บนเส้นทางสู่คะแนนเป้าหมาย
อยากเทียบข้อความสองชุดตอนนี้เลย? Text Similarity Checker ทำงานทั้งหมดในเบราว์เซอร์ของคุณ เพียงวางข้อความทั้งสองชุดแล้วรับค่า Levenshtein, Jaccard และ cosine พร้อม word diff เต็มรูปแบบภายในไม่กี่วินาที โดยไม่มีข้อมูลใดออกจากเครื่องของคุณเลย
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Diff Checker — เทียบข้อความสองชุดแบบรายบรรทัด เห็นทุกการเปลี่ยนแปลงที่ถูกไฮไลต์
- Duplicate Line Remover — ลบบรรทัดซ้ำจากลิสต์และ log ได้ในคลิกเดียว
- Word Counter — นับคำ นับตัวอักษร และเวลาอ่านระหว่างที่คุณเขียน
ขอให้สนุกกับการเปรียบเทียบข้อความ!
คำถามที่พบบ่อย
ถ: ข้อความของฉันถูกอัปโหลดขึ้นเซิร์ฟเวอร์หรือเปล่า? ตอบ: ไม่ ทุกการคำนวณ ทั้ง Levenshtein, Jaccard, cosine และ word diff รันแบบ client-side ในเบราว์เซอร์ ข้อความของคุณไม่เคยออกจากเครื่อง
ถ: ควรเชื่อคะแนนไหนมากที่สุดระหว่างสามค่านี้? ตอบ: ไม่ควรเชื่อตัวใดตัวเดียว Levenshtein สะท้อนความใกล้เคียงระดับตัวอักษร Jaccard สะท้อนการทับซ้อนของคำศัพท์ และ cosine สะท้อนสัดส่วนโดยรวม ควรอ่านทั้งสามค่าร่วมกันแล้วยืนยันด้วย word diff เสมอ
ถ: ทำไมคะแนนเด้งแรงมากกับข้อความสั้น ๆ? ตอบ: เพราะคำมีน้อย การเปลี่ยนแปลงแม้คำเดียวก็คือสัดส่วนใหญ่ของทั้งข้อความ คะแนนจึงควรใช้เป็นสัญญาณหยาบ ๆ แล้วตัดสินจากการอ่านข้อความจริงประกอบ
ถ: เครื่องมือนี้พิสูจน์เรื่อง plagiarism ได้ไหม? ตอบ: มันให้หลักฐาน similarity ที่วัดได้ ไม่ใช่คำตัดสินทางกฎหมาย ใช้เป็น screening รอบแรก แล้วดูคำ unique ที่ถูกไฮไลต์ว่าความทับซ้อนนั้นเป็นเรื่องบังเอิญหรือน่าสงสัย