ULID Decoder: อ่าน timestamp ที่ซ่อนอยู่ในทุก ULID
Decode ULID เพื่อดู timestamp ระดับมิลลิวินาทีที่ฝังอยู่ข้างใน วันที่สร้างใน timezone ใดก็ได้ และส่วน randomness 80 บิต ตรวจสอบรูปแบบ Crockford Base32 พร้อม batch decode ได้ถึง 200 รายการต่อครั้ง ทำงานฝั่ง client ทั้งหมด
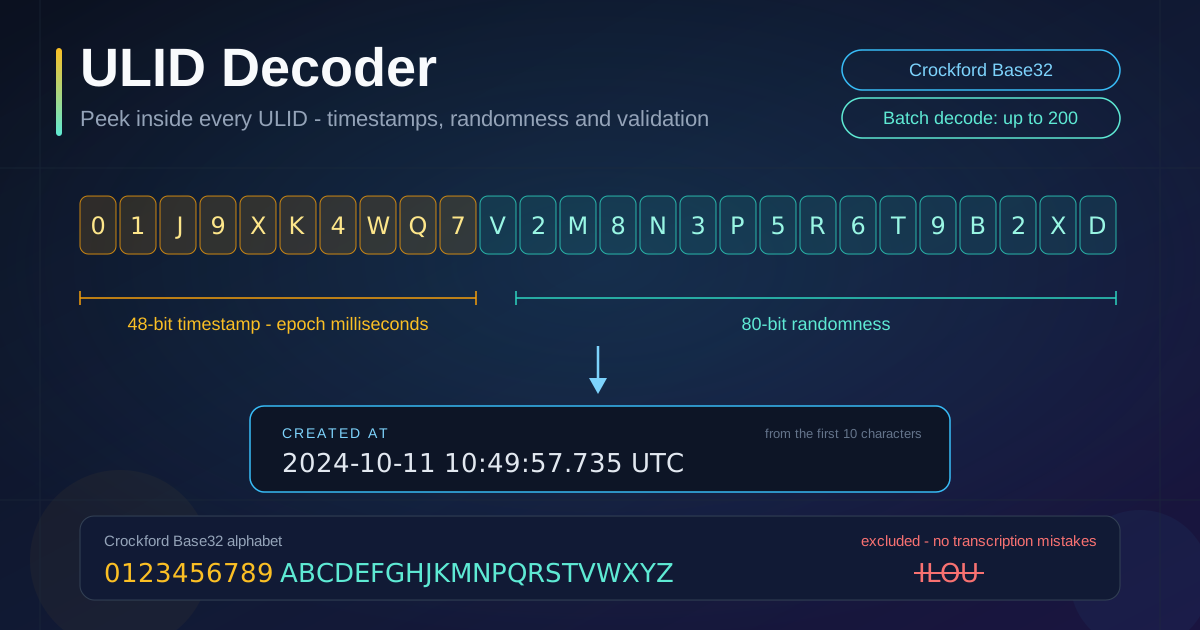
Table of Contents
ULID Decoder: อ่าน timestamp ที่ซ่อนอยู่ในทุก ULID
ULID แต่ละตัวมีความพิเศษสองอย่างพร้อมกัน คือเป็นทั้ง unique identifier และบันทึกเวลาที่ซ่อนอยู่อย่างเงียบ ๆ ULID ย่อมาจาก Universally Unique Lexicographically Sortable Identifier เป็นข้อความ 26 ตัวอักษรที่เรียงลำดับตามเวลาที่สร้าง ทำงานร่วมกับ database index ได้ดีกว่า UUID แบบสุ่มล้วน และที่ไม่ค่อยมีใครรู้คือมันซ่อน timestamp ระดับมิลลิวินาทีเอาไว้ชัด ๆ ULID Decoder เปิดมันออกมาให้ดูได้ในไม่กี่วินาที โดยไม่ต้องเขียนโค้ดหรือติดตั้ง library ใด ๆ
วาง ULID ลงไปแล้วเครื่องมือจะแยกมันออกเป็นสองส่วน ได้แก่ timestamp 48 บิตที่บอกมิลลิวินาทีที่แท้จริงของการสร้าง และส่วน randomness 80 บิตที่ทำให้ identifier คาดเดาไม่ได้ คุณจะได้ค่า epoch milliseconds ดิบ ๆ วันที่สร้างที่อ่านง่ายซึ่งแสดงผลใน timezone ที่คุณเลือก และการตรวจรูปแบบทีละตัวอักษรตามชุดตัวอักษร Crockford Base32
เนื่องจากทุกอย่างทำงานฝั่ง client ในเบราว์เซอร์ 100% ข้อมูลที่คุณวางลงไปจึงไม่เคยออกจากเครื่องของคุณ ซึ่งสำคัญมากเมื่อ identifier ที่คุณกำลังตรวจสอบมาจาก production log, support ticket หรือข้อมูลลูกค้าจริง
ทำไมต้องใช้ ULID Decoder?
- รู้เวลาที่สร้างทันที 10 ตัวอักษรแรกของ ULID ฝังนาฬิกา 48 บิตหน่วยเป็นมิลลิวินาที แทนที่จะเขียนสคริปต์ชั่วคราวหรือนั่งคิดเลข base-32 เพียงวาง ID ลงไปก็อ่านวันที่สร้างได้ทันที
- จับ ID ที่ผิดรูปแบบก่อนสร้างปัญหา การ validate แบบ Crockford Base32 จะชี้ typo, ความยาวที่ผิด และตัวอักษรที่ไม่มีในชุดตัวอักษร ก่อนที่คุณจะเอา identifier ที่เสียหายไปใส่ใน config, ticket หรือ migration script
- อ่านวันที่ใน timezone ของคุณ เลือก timezone ที่ต้องการแล้วดูเวลาสร้างที่ decode แล้วในหน่วยมิลลิวินาที เหมาะกับการประสานงานระหว่าง server ที่ใช้ UTC กับทีมงานท้องถิ่น
- ส่องส่วน randomness 16 ตัวอักษรสุดท้ายคือความสุ่ม 80 บิตล้วน ๆ การเห็นมันแยกออกมาช่วยตอนทดสอบ generator, ทำ data masking หรืออธิบายให้เพื่อนร่วมทีมเข้าใจว่าทำไม ULID สองตัวที่เกิดในมิลลิวินาทีเดียวกันยังต่างกัน
- Batch decode ได้ถึง 200 รายการต่อครั้ง วาง ID ทั้งคอลัมน์บรรทัดละหนึ่งตัว แล้วรับตารางผลลัพธ์ในรอบเดียว เหมาะกับการไล่ log และ spot check dataset
- ข้อมูลอ่อไหวอยู่กับเครื่องคุณ ไม่มีขั้นตอนอัปโหลด ไม่มีการเรียก API และไม่มี telemetry decode ทั้งหมดเกิดขึ้นในแท็บเบราว์เซอร์ของคุณ
ฟีเจอร์หลัก
| ฟีเจอร์ | ทำอะไร |
|---|---|
| ดึง timestamp ที่ฝังไว้ | อ่านนาฬิกา 48 บิตหน่วยมิลลิวินาทีจาก 10 ตัวอักษรแรกของ ULID ทุกตัว |
| วันที่สร้างตาม timezone | แสดง timestamp ที่ decode แล้วเป็นวันที่และเวลาเต็มรูปแบบใน timezone ใดก็ได้ ละเอียดถึงมิลลิวินาที |
| แยกส่วน randomness | แสดง 16 ตัวอักษรสุดท้าย ซึ่งเป็นส่วนสุ่ม 80 บิต ให้ตรวจสอบหรือคัดลอกแยกต่างหาก |
| ตรวจรูปแบบ Crockford Base32 | ปฏิเสธตัวอักษรที่ไม่ถูกต้อง รวมถึง I, L, O และ U พร้อมความยาวที่ผิด พร้อมสถานะชัดเจนรายแถว |
| โหมด batch ถึง 200 รายการ | decode รายการ ULID ทั้งชุดพร้อมกัน บรรทัดละหนึ่งตัว พร้อมผลลัพธ์รายแถว |
| ประมวลผลฝั่ง client 100% | decode ทั้งหมดเกิดในเบราว์เซอร์ identifier ไม่เคยออกจากอุปกรณ์ของคุณ |
รายละเอียดเล็ก ๆ ที่ทำให้เครื่องมือนี้ใช้งานประจำวันได้ลื่นไหล ตัวอักษรพิมพ์เล็กรับได้และถูก normalize ให้อัตโนมัติ ในโหมด batch แถวที่ไม่ถูกต้องจะถูกติดสถานะไว้ ส่วนแถวที่ถูกต้องยัง decode ต่อได้ปกติ บรรทัดที่เสียหนึ่งบรรทัดจึงไม่ขวางรายการที่เหลือ และทุกค่าที่ decode แล้วคัดลอกแยกได้ทีละช่อง ช่วยให้เขียน bug report และเอกสารได้เร็วขึ้น
วิธีใช้งาน
- เปิด ULID Decoder ในเบราว์เซอร์ ไม่ต้องติดตั้งอะไรและไม่ต้องสมัครบัญชี
- สำหรับ identifier เดี่ยว วาง ULID 26 ตัวอักษรลงในช่อง input เครื่องมือจะ decode ทันทีและแสดงค่า millisecond timestamp ดิบ วันที่สร้าง และส่วน randomness
- เลือก display timezone จาก dropdown หากต้องการให้วันที่สร้างแสดงในเขตเวลาอื่นนอกจาก UTC ไม่ว่าจะเป็นเวลาท้องถิ่นของคุณหรือ timezone ของลูกค้า
- สำหรับ batch decode ให้วาง ULID สูงสุด 200 ตัวลงในช่อง input บรรทัดละหนึ่งตัว เครื่องมือจะสร้างตารางผลลัพธ์ที่มีคอลัมน์ timestamp, วันที่ และ randomness สำหรับทุกแถว รองรับตัวพิมพ์เล็ก
- ดูคอลัมน์สถานะ: แถวที่ถูกต้องแสดงผล decode ครบถ้วน แถวที่ผิดจะบอกว่าอะไรผิด คัดลอกค่าใดก็ได้จากตารางไปใส่ใน note, ticket หรือสคริปต์ของคุณ
Crockford Base32 และนาฬิกา 48 บิต
ULID ยาว 26 ตัวอักษรพอดี และโครงสร้างถูกกำหนดตายตัว 10 ตัวอักษรแรกเข้ารหัส timestamp 48 บิต คือจำนวนมิลลิวินาทีนับจาก Unix epoch ส่วน 16 ตัวอักษรที่เหลือเข้ารหัสความสุ่ม 80 บิตที่แข็งแรงเชิงเข้ารหัสลับ รวมกันเป็น identifier 128 บิตที่ unique โดยโครงสร้างและเรียงลำดับตามกำเนิด
การเข้ารหัสใช้ Crockford Base32 ซึ่งเป็นชุดตัวอักษร 32 สัญลักษณ์ที่ Douglas Crockford ออกแบบมาเพื่อการถอดเขียนด้วยมนุษย์โดยเฉพาะ ใช้เลข 0-9 บวกตัวอักษร ABCDEFGHJKMNPQRSTVWXYZ สังเกตว่าอะไรหายไป: I, L, O และ U เพราะ I กับ L หน้าตาคล้ายเลข 1, O คล้าย 0 และ U ถูกตัดออกเพื่อไม่ให้ identifier ที่พิมพ์ออกมาเกิดคำหยาบโดยบังเอิญ การตัดสัญลักษณ์หน้าตาคล้ายกันออกทำให้ ID ที่อ่านผ่านโทรศัพท์ เขียนบนกระดาน หรือพิมพ์ใหม่จากภาพหน้าจอมีโอกาสเพี้ยนน้อยลงมาก ชุดตัวอักษรนี้ไม่สนตัวพิมพ์ จึงเป็นเหตุผลที่ decoder รับ input ตัวพิมพ์เล็กได้สบาย
คณิตศาสตร์ของการ decode เป็นการขยายตำแหน่งแบบตรงไปตรงมา ถือว่าบล็อก timestamp 10 ตัวอักษรเป็นเลขฐาน 32: คูณ index ของตัวอักษรแต่ละตัวด้วย 32 ยกกำลังตำแหน่งจากขวา แล้วรวมกัน ค่าที่ได้คือมิลลิวินาทีนับจาก 1970-01-01 UTC ลองดูตัวอย่าง ULID 01J9XK4WQ7V2M8N3P5R6T9B2XD: บล็อก timestamp 01J9XK4WQ7 คิดค่าได้ 1,728,643,757,735 มิลลิวินาที ซึ่งคือ 2024-10-11 10:49:57.735 UTC ส่วนบล็อกท้าย V2M8N3P5R6T9B2XD คือ randomness ที่มักแสดงเป็นค่า hex decoder ทำการคำนวณนี้ให้คุณและจัดรูปแบบผลลัพธ์ใน timezone ที่คุณเลือก
การ batch decode เปลี่ยนสิ่งนี้ให้เป็นพลังสำหรับงานวิเคราะห์ log export คอลัมน์ ULID จาก database หรือเก็บจาก application log วางทีละ 200 ตัว แล้วคุณจะได้ตารางเรียงเวลาได้ทันที เพราะ ULID ฝังนาฬิกาการสร้างไว้ในตัว timestamp ที่ decode ออกมาจึงช่วยสร้างลำดับเหตุการณ์ใหม่ได้ แม้บรรทัด log รอบ ๆ จะไม่มี timestamp ที่เชื่อถือได้ หรือใช้ตรวจว่า timestamp ที่มีอยู่สอดคล้องกับ identifier หรือไม่
ควรวาง ULIDไว้เทียบกับเครือญาติที่เรียงตามเวลาเหมือนกัน UUIDv7 ก็ฝัง Unix timestamp 48 บิตหน่วยมิลลิวินาทีเช่นกัน แต่เข้ารหัสในรูปแบบ hexadecimal ของ UUID มาตรฐาน จึงต้องเข้าใจระดับบิตถึงจะอ่านได้ Snowflake ID ที่นิยมในระบบ distributed ขนาดใหญ่ บรรจุ timestamp, machine ID และ sequence number ลงในจำนวนเต็ม 64 บิตตัวเดียว จุดแข็งของ ULID คือความเป็นมิตรกับมนุษย์: เรียงตามตัวอักษรได้ใน database ใดก็ได้ ชุดตัวอักษรที่ถอดเขียนปลอดภัย และโครงสร้างเรียบง่ายจนบทความนี้สอนให้คุณ decode ด้วยมือเองได้
กรณีการใช้งานจริง
หาวันที่สร้างของข้อมูลใน database
เคย backfill ตารางโดยไม่มีคอลัมน์ created_at หรือรับ schema เก่าที่มีแต่ primary key เป็นหลักฐานเดียวไหม decode ตัวอย่าง ULID ชุดหนึ่งแล้วคุณจะจับเวลา record ได้ละเอียดถึงมิลลิวินาที ว่าคลื่นการสมัครเริ่มเมื่อไร migration queue ระบายใช้เวลาเท่าไร หรือบัญชีทดสอบที่คิดว่าเก่านั้นจริง ๆ แล้วสร้างเมื่อวันจันทร์ที่ผ่านมา
เชื่อมโยง log ข้ามบริการ
เมื่อ ULID ตัวเดียวกันปรากฏใน gateway log, payload ใน queue และ service log timestamp ที่ฝังไว้จะผูก identifier นั้นกับช่วงเวลาหนึ่ง ไม่ว่ามันจะโผล่ที่ไหน การ decode ID ที่เกี่ยวข้องเป็นชุดเผยลำดับจริงข้ามระบบที่นาฬิกาหรือรูปแบบ log ไม่ตรงกัน
ตรวจสอบลำดับการเรียง
ULID ควรเรียงตามเวลาเสมอ ถ้ารายการ ULID ที่เรียงแล้วให้ timestamp ที่ decode ออกมาไม่เรียงตาม คุณเจอทั้ง clock skew ระหว่างเครื่องที่สร้างหรือบั๊กการเรียงใน query การ batch decode อย่างรวดเร็วเปลี่ยน "รู้สึกว่าลำดับแปลก ๆ" ให้เป็นข้อสรุปที่ชี้ชัดและพิสูจน์ได้
ตรวจสอบย้อนหลังตอน migrate ระบบ
ระหว่าง migration แพลตฟอร์มหรือการส่งมอบระหว่าง vendor คุณมักต้องพิสูจน์ว่า record ถูกสร้างเมื่อไรโดยใช้เพียง identifier ที่รอดมาได้ การ batch decode ULID จากทั้งระบบเก่าและใหม่ให้ audit trail ของเวลาสร้างโดยไม่ต้องเชื่อข้อมูล metadata ของระบบใดระบบหนึ่ง
แนวทางปฏิบัติที่ดี
- Validate ก่อน decode ทุกครั้ง ใช้การตรวจรูปแบบของเครื่องมือก่อน ตัวอักษรที่พิมพ์ผิดเพียงตัวเดียวอาจ decode ให้ timestamp ที่ดูน่าเชื่อแต่ผิดไปเงียบ ๆ
- จำไว้ว่า timestamp เปิดเผยเวลาที่สร้าง ULID บอกใบ้ว่า record เกิดเมื่อไร ถือเป็น metadata ที่อ่อไหวเล็กน้อย ก่อนนำ identifier ของลูกค้าไปแปะใน issue สาธารณะหรือภาพหน้าจอ
- ใช้การเช็คการเรียงเป็นการเช็ค timestamp ถ้าข้อมูลของคุณเรียงด้วย ULID การที่ timestamp ที่ decode ได้ไต่ขึ้นอย่างสม่ำเสมอคือ integrity test ราคาถูกหลัง export, ETL job และ restore
- เทียบข้ามระบบด้วย UTC การแสดงผลตาม timezone ไว้ให้คนอ่าน เมื่อ reconcile วันที่ที่ decode ระหว่างสอง environment ให้สลับ display เป็น UTC เพื่อเลี่ยงความผิดพลาดเรื่อง offset
- แบ่ง batch ทีละ 200 เครื่องมือจำกัด 200 ULID ต่อรอบ ซึ่งทำให้ decode เร็วเสมอ แบ่ง export ใหญ่เป็นชุดแล้ววางตามลำดับ
- ถือว่าเวลาที่ decode ได้คือนาฬิกาของเครื่องผู้สร้าง ความละเอียดระดับมิลลิวินาทีสะท้อนเครื่องที่สร้าง ULID clock skew หมายความว่ามันเป็นหลักฐานของเวลาสร้าง ไม่ใช่การรับประกันลำดับการ insert ในทุก database
พร้อม decode ULID แรกของคุณหรือยัง?
หยิบ ULID สักตัวจาก log, database หรือ codebase ของคุณ แล้ววางลงใน ULID Decoder ในแวบเดียวคุณจะเห็นมิลลิวินาทีที่มันเกิด วันที่สร้างเต็มรูปแบบใน timezone ของคุณ และความสุ่มที่ทำให้มัน unique พร้อมโหมด batch รออยู่เมื่อคุณมีอีกสองร้อยตัว
เครื่องมือที่เกี่ยวข้องที่คุณอาจสนใจ:
- Snowflake ID Decoder — แยกเลข Snowflake 64 บิตเป็นส่วน timestamp, worker และ sequence
- UUID Decoder — ส่อง UUID ทั้งเวอร์ชัน, variant bits และ timestamp ที่ฝังอยู่
- Unix Timestamp Converter — แปลง epoch หน่วยวินาทีและมิลลิวินาทีเป็นวันที่ที่อ่านได้
ขอให้สนุกกับการ decode
คำถามที่พบบ่อย
ถ: ULID บอกเวลาที่สร้าง record ได้แม่นยำจริงหรือ?
ตอบ: แม่นยำถึงระดับมิลลิวินาที แต่เทียบกับนาฬิกาของเครื่องที่สร้างมัน 10 ตัวอักษรแรกเข้ารหัส timestamp 48 บิตหน่วยมิลลิวินาที วันที่ที่ decode ได้จึงเป็นหลักฐานเวลาสร้างที่แม่นบนระบบผู้สร้าง ภายใต้ความแม่นยำของนาฬิกาเครื่องนั้น
ถ: ทำไมตัวอักษร I, L, O และ U ถึงไม่มีใน ULID?
ตอบ: Crockford Base32 ตัดสัญลักษณ์หน้าตาคล้ายกันออกโดยเจตนา I และ L สับสนกับเลข 1 ได้ง่าย O กับ 0 และ U ถูกตัดเพื่อไม่ให้ identifier ที่พิมพ์ออกมามีคำหยาบโดยบังเอิญ decoder จะติด flag ตัวอักษรเหล่านี้ว่าไม่ถูกต้อง
ถ: decode ULID พร้อมกันได้กี่ตัว?
ตอบ: ได้สูงสุด 200 ตัวต่อ batch วางทีละบรรทัด ใช้ตัวพิมพ์เล็กก็ได้ เครื่องมือจะคืนตารางผลลัพธ์ที่แถวที่ถูกต้องถูก decode ครบ ส่วนแถวที่ผิดถูกระบุชัดเจน บรรทัดที่เสียหนึ่งบรรทัดจึงไม่ขวางรายการที่เหลือ
ถ: ข้อมูลของฉันถูกอัปโหลดไปที่ไหนหรือเปล่าเวลาใช้ decoder?
ตอบ: ไม่ การ decode ทั้งหมดทำงานฝั่ง client ในเบราว์เซอร์ 100% ULID ที่คุณวางลงไปไม่เคยออกจากอุปกรณ์ของคุณ เครื่องมือจึงปลอดภัยกับ identifier จาก production และข้อมูลลับ
ถ: ส่วน timestamp กับส่วน randomness ต่างกันอย่างไร?
ตอบ: 10 ตัวอักษรแรกคือ timestamp 48 บิต บอกว่า ULID ถูกสร้างเมื่อไร ส่วน 16 ตัวอักษรสุดท้ายคือความสุ่ม 80 บิตที่ทำให้ ULID ที่เกิดพร้อมกันยังไม่ซ้ำกัน การเรียงตาม ULID คือการเรียงตามส่วน timestamp ส่วนความ unique มาจากฝั่ง randomness